8GBのノート用GPUが、35Bのモデルを動かす——。以前この連載で取り上げたllama.cppのMoEオフロード(使わないエキスパートの重みをGPUの外に置いて動かす技)をめぐり、今度は実際に試した人の記録や専用ツール、解説が見え始めてきました[2][3]。
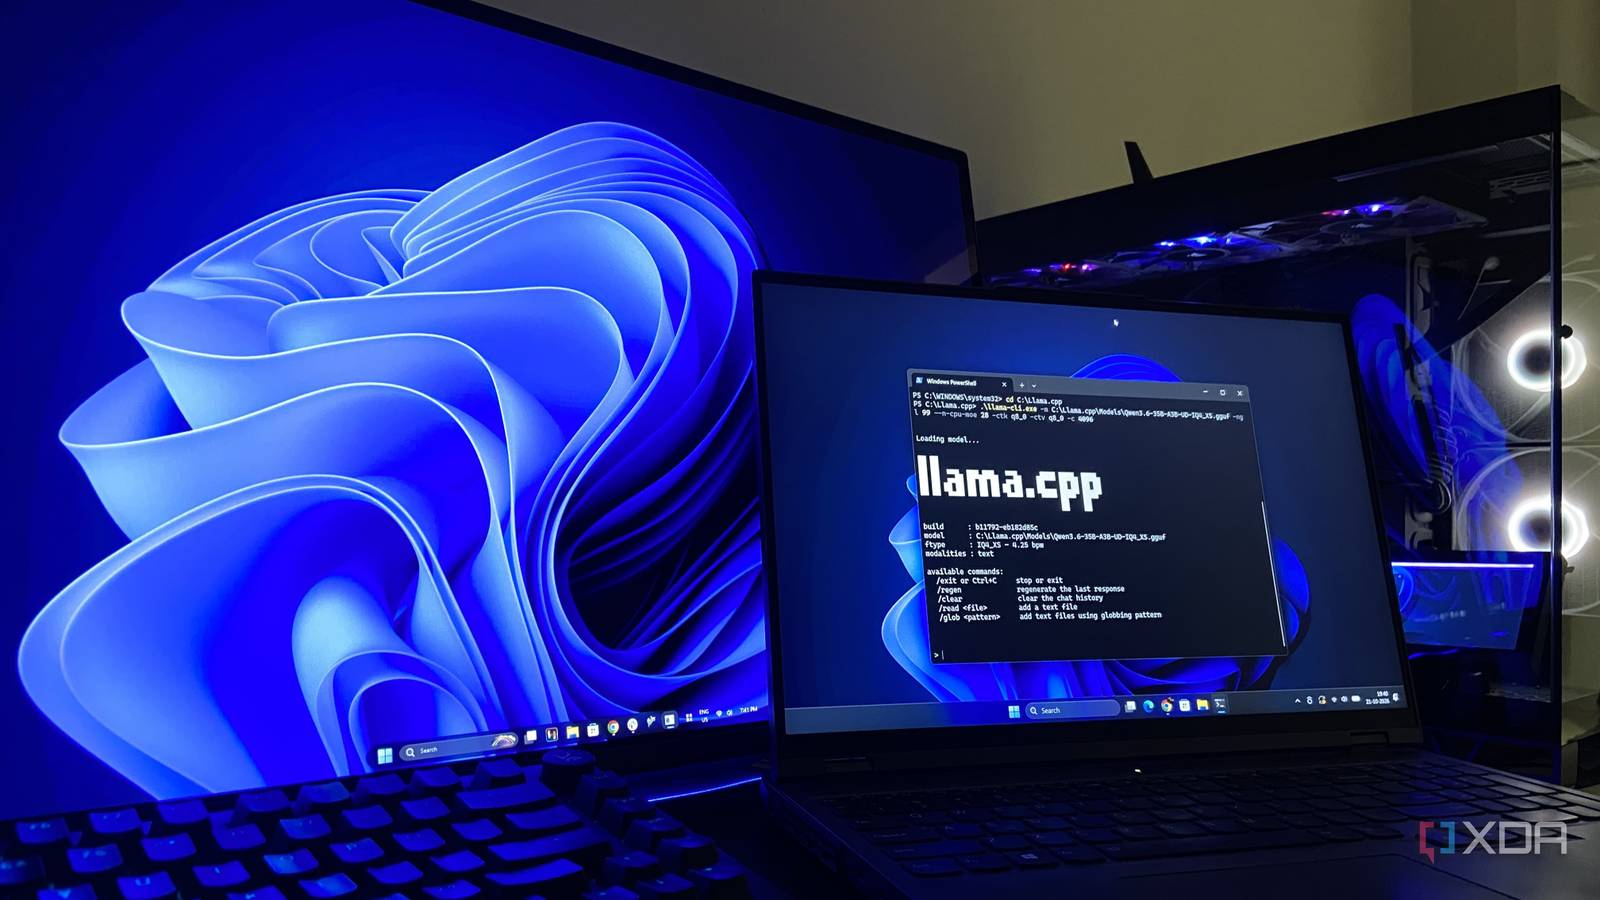
XDA Developersのライターは、8GBのRTX 3070 Mobileを積んだLenovoのノートPCで検証しました。VRAMの容量は、ゲームの解像度や動画編集だけでなく、自分のPCで動かせるAIモデルの規模まで決める壁です。ライターは当初、このGPUでは大きなモデルを「動かす資格がない」と切り捨てていました[2]。Ollamaからllama.cppへ環境を移し、各機能を試す中で転機が訪れたといいます[2]。
鍵はllama.cppのフラグです。まず全層をGPUに載せる指定をした上で、–n-cpu-moeというオプション(最初のN層分のエキスパートをRAMに残す指定)を組み合わせます[2]。エキスパートとは、MoE(混合エキスパート)モデルがトークンごとに選んで使う計算ユニットのこと。休みのエキスパート層をRAMへ移し、常に動く部分をGPUに残すのが仕組みです[2]。
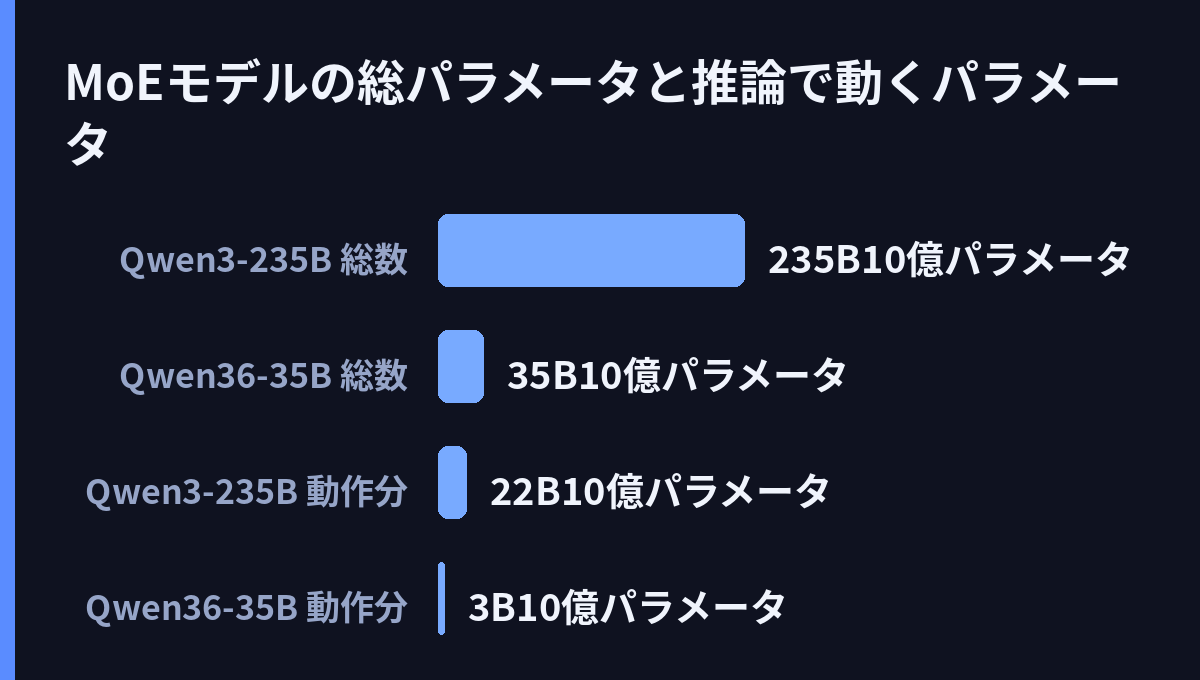
参考として示されたのが、デスクトップのRTX 4070 Ti Super(16GB)での記録です。Qwen3.6-35B-A3BをIQ4_XSという形式(重みを圧縮してメモリを節約する量子化の一種)で、32Kコンテキスト(一度に扱える文章の長さ)に設定して動かしたところ、17.7GBのファイルでありながらテストした中で最速だったといいます[2]。数の上ではVRAMに収まらないはずのサイズです。MoEでは35Bのパラメータのうち、推論で動くのは約3Bだけです[2]。以前取り上げた解説では、Qwen3-235B-A22Bは総235Bのうち約22Bが動くと説明されていました。規模は違っても、動く部分が全体の1割弱という構造は共通しています。
道具側の動きも目立ちます。GitHubではllama.cppベースの軽量フレームワーク「llama.moe」が公開され、エキスパートを動的にオフロードすると謳われています。llama-serverと同じ使い方で、コマンドを置き換えるだけで試せるようです。CUDAの入った環境でのビルドを前提としています[3]。またHacker Newsには、スマホやノートで巨大MoEをストリーミングするllama.cppのラッパー「BigMoeOnEdge」がShow HNとして投稿されました。llama.cppの上にかぶせる形で作られており、ポイントもコメントもまだついていない段階です[1]。
解説も整ってきました。VRAMの少ない環境で大きなモデルを動かすためのガイド[4]や、Hugging Faceのブログに載った「MoEをCPU推論とGPU加速で快適に動かす」ためのガイド[5]、大規模MoEの推論性能を最適化する手順をまとめたGistも出ています[6][6]。いずれも自分のマシンで試す人向けの内容のようです。技そのものは以前から知られていましたが、真似をするための道しるべが一気に増えた形です。
一方で、疑問を投げる声も出ています。arXivには「MoEは消費者向け・エッジの推論で本当に役立つのか」と問いかける論文が投稿されました[6]。素材からは論文の詳細な結果までは確認できませんでした。ただ、オフロードした重みはRAMから読むことになるため、メモリまわりの構成が速度を左右する場面はあるはずです。省メモリの恩恵と速度のバランスは、環境ごとに確かめる必要があります。
MoEオフロードは、玄人の小技から道具と解説がそろった選択肢へと一歩進んだようです。8GBのGPUでも35Bが動く可能性は、実検証で示されました。ただし「MoEなら少ないVRAMで必ず得」という図式は、論文の問いかけが示す通り環境次第です。まずは自分のGPUとRAMの容量に合わせて、そろった材料で試してみるのが近道と思われます。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B … — https://www.xda-developers.com/i-stopped-thinking-my-8gb-gpu-was-too-small-after-learning-to-offload-moe-llm-layers-to-ram/
A lot of what you can do with your PC seems to be limited by the VRAM its GPU has. It decides what resolution your games run at, how large a video project you can edit without the timeline stuttering intermittently, and
- Web記事 記事全文: GitHub – jklincn/llama.moe: Optimized inference of MoE models based on … — https://github.com/jklincn/llama.moe
A lightweight inference framework for Mixture-of-Experts (MoE) models, built on top of llama.cpp with dynamic expert offloading.
sudo apt update
sudo apt install build-essential cmake ccache libcurl4-openssl-dev ninja-bu - Web記事 Web検索: Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide … — https://aliteq.com/llama-cpp-moe-offloading-run-bigger-models-less-vram
Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide …
- Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0/182081356f8ef4daeb7ad207fb2e989af96977e9
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: Does Mixture-of-Experts Actually Help Inference on Consumer and Edge … — https://arxiv.org/html/2606.21428
Does Mixture-of-Experts Actually Help Inference on Consumer and Edge …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS