「最速」より「現役」が強いという見方があります。2022年に投入されたNVIDIA H100は、2026年の時点でデータセンターで最も広く使われているGPUとされています[1]。AI推論の話題では、flashやhacker、ローカル環境への関心も根強いですが、今回はサーバー側の検証に焦点を当てます。
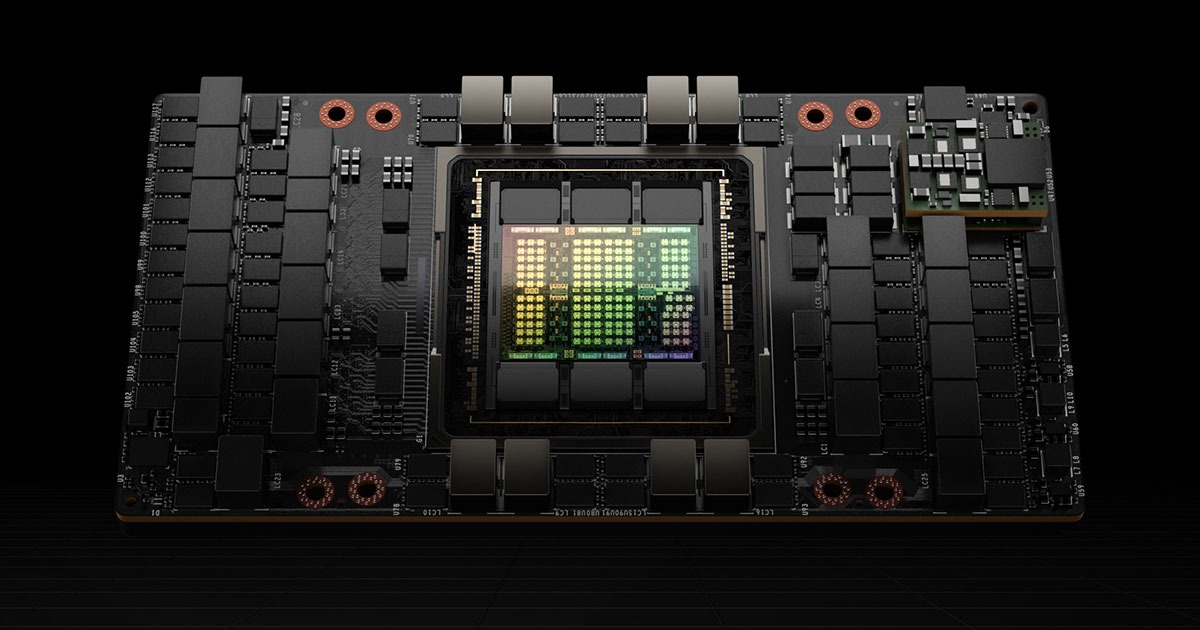
H100の性能は、形態によって大きく変わります。訓練向きはSXM5(高速接続向け基板)で、NVLink(GPU同士を高速につなぐ仕組み)によりGPU間で900GB/sの帯域を使います[1]。8枚構成のノードでは、GPT-3規模のモデルで約87%の線形スケーリング効率(GPUを増やしたときの性能の伸び率)が得られるとされています[1]。一方、PCIe版(通常のサーバー接続)は350Wと700Wの差があり、メモリ帯域は2,000GB/s、FP16(16ビット浮動小数点)スループットは約756TFLOPS(演算速度の単位)まで下がります[1]。PCIe版はGPU間通信が64GB/sのPCIeバスになるため、分散訓練で詰まりやすいとされています[1]。
NVIDIA公式は、H100がLLM(大規模言語モデル)を最大30倍高速化し、推論でも最大30倍の高速化を掲げています[2]。GPT-3 175Bの学習では前世代と比べて4倍速いとしており[2]、Transformer Engine(Transformer向けの専用回路)とFP8が鍵です。FP8は8ビット浮動小数点の形式で、16ビット形式のBF16より速いとされています[1][2]。実務ガイドでは、FP8訓練がTransformerでBF16と比べて1.5〜2倍のスループット向上をもたらすとされています[1]。
新しいBlackwellでは、単純な倍率以上の差が見えます。第三者のマイクロベンチマーク(部品ごとの性能測定)では、B200がH200と比べて混合精度スループットを1.56倍、エネルギー効率を42%改善したと報告されています[3]。注目すべきはメモリで、キャッシュミス時のアクセス遅延が58%減少したとされています[3]。B200は第5世代Tensor Core、Tensor Memory(テンソル用の専用メモリ)、圧縮データを元に戻す専用回路である展開エンジン、デュアルチップなどを搭載しています[3]。この検証はオープンソースのマイクロベンチマーク群として公開されています[3]。
公式資料では、Blackwellを生成AIと加速計算の次の段階としており[4]、プラットフォーム発表資料[6]や公式アーキテクチャページ、検索結果、PDF解析資料[5]も確認できます。H100については実務ガイド[1]とデータシート[5]が並び、新旧比較の需要が続いています。

ただし、数字の読み方には注意が必要です。H100の30倍は、特定のモデルやネットワーク構成を前提とした数値です[2]。公式資料では、前世代A100とH100の比較でInfiniBand(高速ネットワーク)やNVLink Switch System(GPU同士を大規模につなぐ仕組み)が挙げられています[2]。Blackwellの1.56倍や42%改善も、行列計算やTransformer推論・訓練のマイクロベンチマークでの結果です[3]。実運用では、推論のオプションや、GPU構成と接続方式によって差が出ます[1]。
つまり、2026年のNVIDIA GPU選びは「新しい世代にするか」より「どの形態と接続で使うか」が重要になっています。H100は現役の主力として残り、Blackwellはメモリ遅延と省電力で差を広げているようです。H100からH200やB200への乗り換え判断にも、この差が影響します[1]。AI推論の速度を語るなら、倍率だけでなく、GPU構成とデータ経路まで見るべきでしょう。
引用ソース
- Web記事 記事全文: NVIDIA H100 Complete Guide: Specs, Benchmarks, and Real-World … — https://gpuadvisor.com/blog/nvidia-h100-complete-guide-2026
NVIDIA H100 Complete Guide: Specs, Benchmarks, and Real-World Performance (2026)
Everything you need to know about the NVIDIA H100 GPU in 2026. Detailed specs for SXM5 and PCIe variants, real training and inference bench - Web記事 記事全文: H100 Gpu | Nvidia — https://www.nvidia.com/en-us/data-center/h100/
NVIDIA H100 GPU
Extraordinary performance, scalability, and security for every data center.
An Order-of-Magnitude Leap for Accelerated Computing
The NVIDIA H100 GPU delivers exceptional performance, scalability, and secu - Web記事 記事全文: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://arxiv.org/html/2512.02189v1
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth Architectural Analysis
Abstract
As GPU architectures rapidly evolve to meet the overcoming demands of exascale computing and machine learning, the performanc - Web記事 記事全文: [en_us] Blackwell Architecture – resources.nvidia.com — https://resources.nvidia.com/l/en-us-blackwell-architecture
The NVIDIA Blackwell architecture introduces groundbreaking advancements for generative AI and accelerated computing. Blackwell’s multiple advancements build upon generations of accelerated computing technologies to defi
- Web記事 Web検索: Dissecting the NVIDIA Blackwell Architecture with Microbenchmarks — https://arxiv.org/pdf/2507.10789v1
Dissecting the NVIDIA Blackwell Architecture with Microbenchmarks
- Web記事 Web検索: Computing NVIDIA Blackwell Platform Arrives to Power a New Era of — https://nvidianews.nvidia.com/_gallery/download_pdf/65f8a7843d633205563719fc/
Computing NVIDIA Blackwell Platform Arrives to Power a New Era of
- Web記事 Web検索: PDF NVIDIA H100 Tensor Core GPU Datasheet | NVIDIA – PNY — https://www.pny.com/File%20Library/Company/Support/Product%20Brochures/NVIDIA%20Data%20Center%20GPUs/english/nvidia-h100-datasheet.pdf
PDF NVIDIA H100 Tensor Core GPU Datasheet | NVIDIA – PNY
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。

RECENT COMMENTS