AIをローカルで使う話題では、0.8Bという小さなモデルが注目されています。以前取り上げたQwen4系の話題とは条件が違い、直接比較はできませんが、今回はQwen3.5-0.8Bの微調整が具体化しています。Redditでは、このモデルを調整して英語をbashコマンドに変える試みが話題になりました[1][7]。hackerが好みそうな機能ですが、作者は端末補助として作りました。
このオフライン推論ツールは、ユーザーが「show the 5 largest files in this folder」のように入力すると、微調整した小さなモデルがコマンドを書き出し、その後、確定的なリスクチェックがsafe、caution、dangerのラベルを付けます。実行前に確認を求めます[1]。471件の評価では、CPUで動くdale-0.8bの正解率は79.4%でした。同じ0.8Bの未調整版は14.9%で、差は大きいです[1]。9Bでも未調整の62.8%に対し、微調整版は89.2%でした[1]。GPUなしの2020年製ノートPCで、中央値1.7秒で回答したそうです[1]。
微調整の入口は、以前より狭くなりました。Unslothなどの資料では、Qwen3.5の0.8Bから122BまでLoRAで調整できるとされています[2][5]。LoRAは、重みの一部だけ追記する軽い調整方法です。BF16 LoRA(16bitの重みでLoRAを使う方法)なら、0.8BはVRAM(ビデオメモリ)約3GB、2Bは約5GB、4Bは約10GB、9Bは約22GBが目安です[2][5]。標準的なFA2(flash attention系の高速化設定)より1.5倍速く、VRAMを約50%減らすという説明もあります[2][5]。新しいバージョンのtransformersが必要で、古い版は使えません[2]。学習後は、GGUF形式(llama.cpp向けのファイル形式)でllama.cppやOllama(ローカル実行の仕組み)に読み込めるとされています[2]。Hugging Face向けの簡易スクリプトでは、0.8Bが約4GBに収まり、8GBのMacでも動く例が示されています[3]。

ただし、成功のカギはセットアップよりデータにあります。実務ガイドでは、ChatML形式(会話の役割を分けるデータ形式)を用意し、最低500件、推奨は1000〜5000件、重複を除き、出力形式を揃えることが挙げられています[4]。モデルの挙動を揃えるため、形式の統一が重要だとされています[4]。GitHubの例では、Alpaca風(指示と回答を並べる形式)、チャット形式、Q&A形式などを自動で読み込めるようです[3]。ニュース分類のような用途では、Qwen3.5の小型モデルをQLoRA(量子化したモデルにLoRAを付ける方法)で調整するチュートリアルもあります[7]。自然言語からシェルを作る関連プロジェクトも検索できます[6]。ローカルで試すための解説記事も複数あり、0.8Bは入門向けとして扱われています。
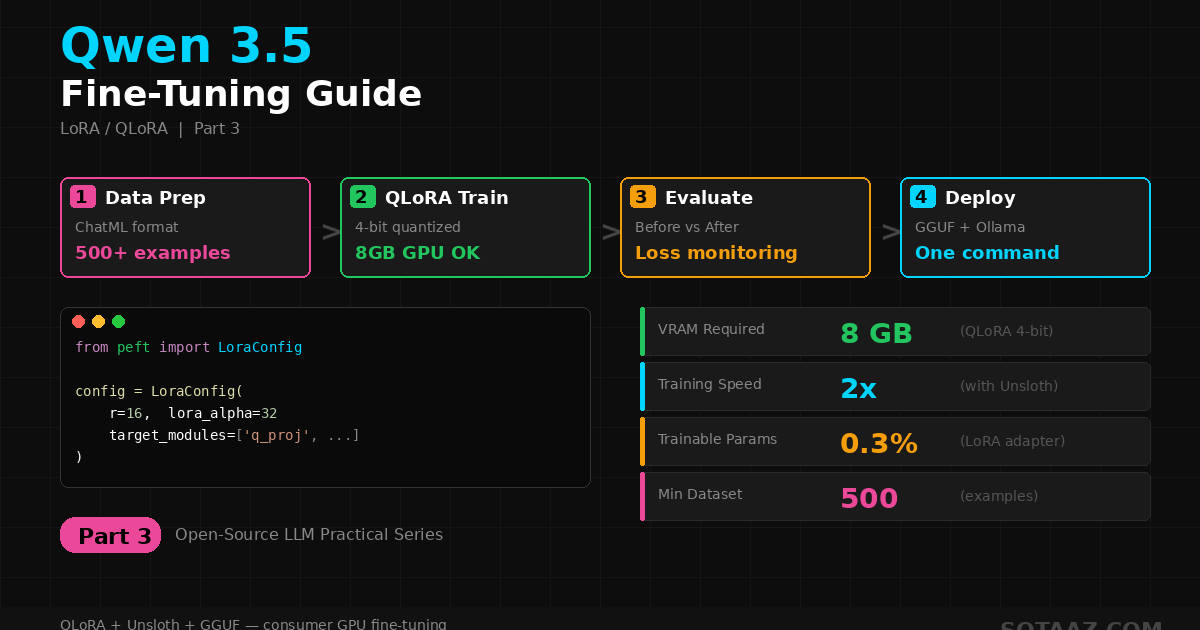
ここで注意が必要です。小型モデルはQLoRAで手軽に動かしやすい一方、Qwen3.5では4bit量子化(重みを圧縮してメモリを減らす方法)の誤差が大きいとして、QLoRAが推奨されていない資料があります[2][5]。BF16 LoRAなら0.8Bは3GB前後で済むため、ローカルではそちらが現実的かもしれません[2][5]。一方、8GB GPU向けのQLoRA手順も紹介されており、モデルの精度差を示す具体的な数値は発表資料では確認できません[4][7]。なお、作者が試した推論ではQ4_K_M(4bit系の量子化)を使っており、訓練の量子化とは別です[1]。MoEモデル(専門家を集めたモデル)では、router層(MoEでどの専門家を使うか決める層)の調整を既定で無効化し、安定性を保つという説明もあります[5]。
結局、Qwen3.5-0.8Bの微調整は、大きなモデルを置き換える話ではありません。bashコマンド生成のような狭いタスクで、オフライン推論の速さと小ささを両立させる試みです[1]。作者が試した結果では、0.8BはCPUで529MB、1.7秒という数字でした[1]。今後は、LoRAの軽い調整と、リスク確認のような安全装置を組み合わせる流れが広がりそうです[1][3]。
引用ソース
- Reddit Reddit r/LocalLLaMA: I fine-tuned Qwen3.5-0.8B to turn plain English into bash. What I learnt — https://www.reddit.com/r/LocalLLaMA/comments/1xr0ykk/i_finetuned_qwen3508b_to_turn_plain_english_into/
I fine-tuned Qwen3.5-0.8B to turn plain English into bash. What I learnt
- Web記事 記事全文: From Zero to Deployment: A Complete Qwen3.5 Fine‑Tuning Guide — https://www.besthub.dev/articles/from-zero-to-deployment-a-complete-qwen3-5-fine-tuning-guide-869c8e1c888c
Qwen3.5 Fine‑Tuning Overview
Core advantages
Training speed 1.5× faster than standard FA2.
VRAM usage reduced by ~50%.
Supports the full model series: 0.8B, 2B, 4B, 9B, 27B, 35B‑A3B (MoE), 122B‑A10B (MoE).
Three fine‑tun - Web記事 記事全文: qwen3.5-fine-tuning/README.md at main – GitHub — https://github.com/samyou/qwen3.5-fine-tuning/blob/main/README.md
Fine-tune Qwen3.5 using the HuggingFace stack (transformers + PEFT + TRL) with LoRA. Works on NVIDIA GPUs (CUDA), Apple Silicon (MPS), and CPU.
# Install dependencies
uv sync
# Fine-tune Qwen3.5-0.8B (fits in ~4 GB, runs - Web記事 記事全文: Qwen 3.5 Fine-Tuning Practical Guide — Build Your Own Model with LoRA — https://sotaaz.com/post/qwen35-finetuning-en
Qwen 3.5 Fine-Tuning Practical Guide — Build Your Own Model with LoRA
In the previous post, we covered installing and running Qwen 3.5 locally. Now let’s go one step further: fine-tuning the model with your own data.
Wit - Web記事 記事全文: Qwen3.5 Fine-tuning Guide | Unsloth Documentation — https://unsloth.ai/docs/models/qwen3.5/fine-tune
You can now fine-tune Qwen3.5 model family (0.8B, 2B, 4B, 9B, 27B, 35B‑A3B, 122B‑A10B) with Unsloth. Support includes both vision, text and RL fine-tuning. Qwen3.5‑35B‑A3B – bf16 LoRA works on 74GB VRAM.
– Unsloth makes - Web記事 Web検索: GitHub – nl2shell/nl2shell: NL2Shell — Natural Language to Shell/Bash … — https://github.com/nl2shell/nl2shell
GitHub – nl2shell/nl2shell: NL2Shell — Natural Language to Shell/Bash …
- Web記事 Web検索: I fine-tuned Qwen3.5-0.8B to turn plain English into bash. What I … — https://www.zgaiagent.cn/items/21189
I fine-tuned Qwen3.5-0.8B to turn plain English into bash. What I …
- Web記事 Web検索: Fine-Tuning Qwen3.5 Small With QLoRA For News Classification — https://www.datacamp.com/tutorial/fine-tuning-qwen3-5-small
Fine-Tuning Qwen3.5 Small With QLoRA For News Classification
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS