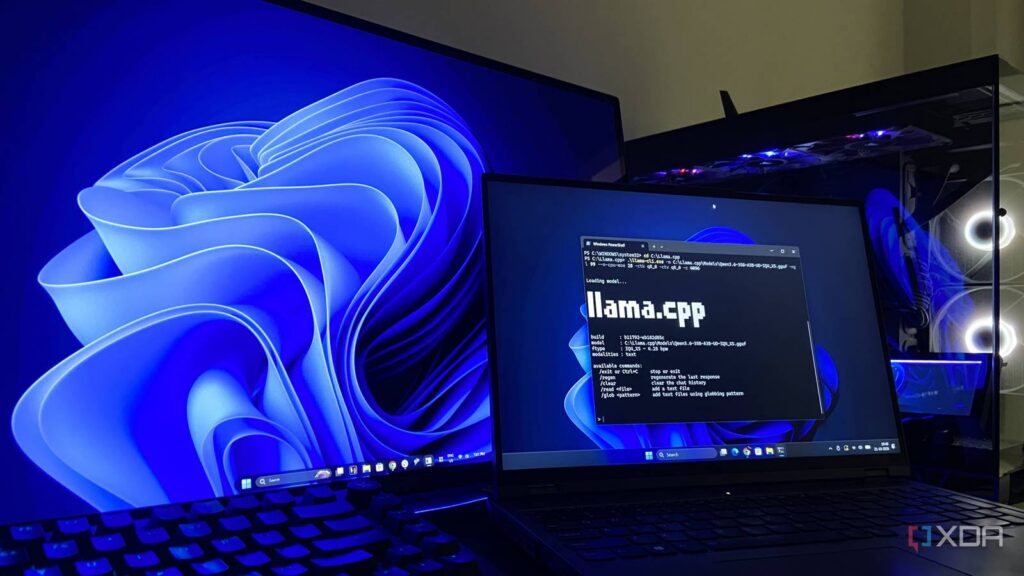
「GPUのメモリが8GBでは、35Bのモデルは動かない」——そんな常識を崩す動きが、llama.cpp周辺で続いています。そして今回、さらにその先を目指す試みが現れました。RAM(メインメモリ)の容量すら超えるMoEモデルを、スマホやノートPCで動かそうという拡張「BigMoeOnEdge」です。Hacker Newsに「Show HN」(自作プロジェクトの紹介)として投稿されました[1]。
MoE(混合専門家、Mixture-of-Experts)は、巨大モデルの中でトークンごとに使う一部だけを計算に回す仕組みです。GitHubの説明では、このプロジェクトは「RAMより大きいMoEモデルを動かす」とうたわれています[6]。投稿のタイトルも「大きなMoEモデルのストリーミングを可能にする」としています[1]。これまでの定番は、VRAM(GPU側のメモリ)に入らない重みをRAMへ退避させる方法でした。以前取り上げた解説では、16GBや24GBのマシンでは重みの「置き場所」が最大の壁になると指摘されています。BigMoeOnEdgeは、その壁の外側まで狙いを伸ばす試みのようです[6]。
土台となる技術の効果は、具体的な数値で示されています。XDA Developersのライターは、8GBのRTX 3070 Mobileを積んだLenovo Legion 5で、Qwen3.6-35B-A3Bを動かしました[2]。このノートPCは当初、デスクトップで動かしているモデルの対象外とされていたといいます。出発点は「PCにできることはVRAMが決める」という実感で、ゲームの解像度から、どのローカルAIを自前で動かせるかまでVRAMが左右すると書かれています[2]。Ollamaからllama.cppへ環境を移し、各機能を試す中でこの方法にたどり着いたといいます。
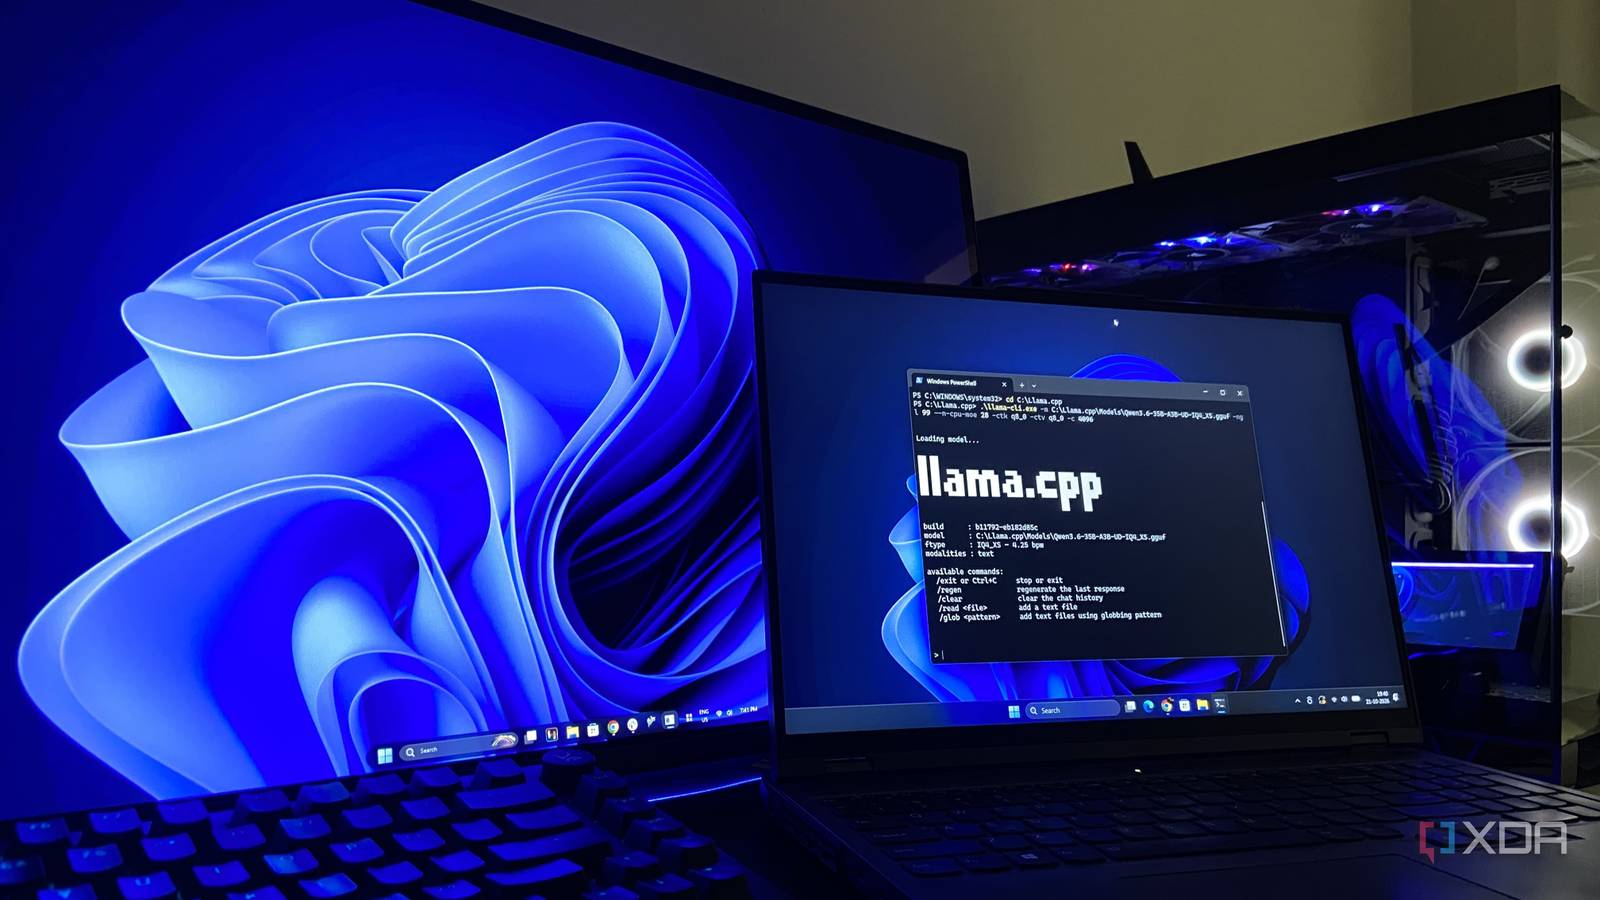
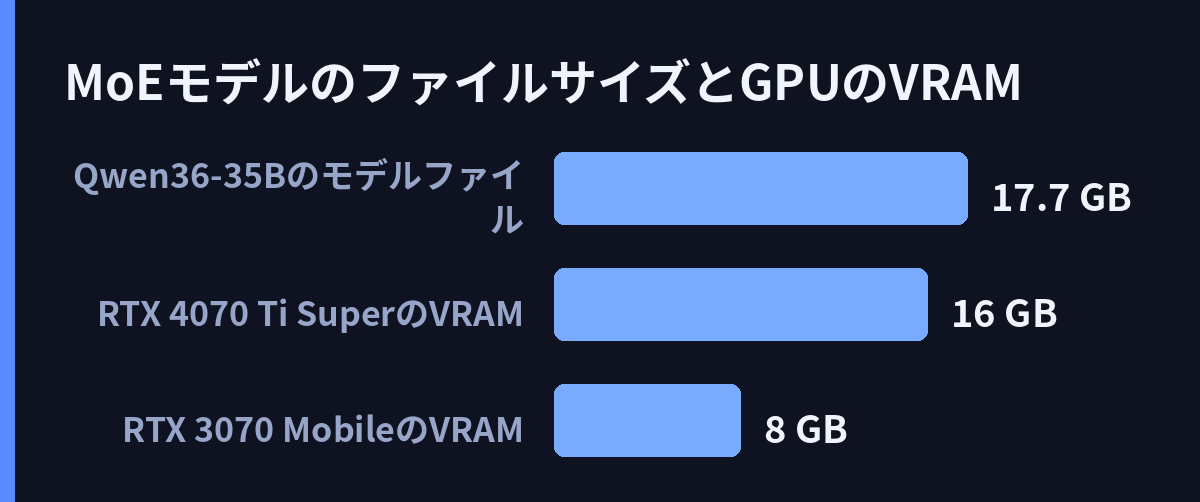
条件を詳しく見ます。量子化(重みを圧縮してメモリを節約する仕組み)はIQ4_XSです。コンテキスト長(一度に参照できる文章の量)は32Kで、モデルファイルは17.7GBあります。16GBのVRAMを持つデスクトップのRTX 4070 Ti Superでも、数値の上では収まらないサイズです[2]。それでも動くのは、MoEの構造が背景にあります。35Bのパラメータのうち、推論で実際に動くのは約3Bで、残りは待機しているのです[2]。
そこでllama.cppでは、常に動く部分はGPUに残し、待機の専門家層だけをRAMへ移します。XDA記事が紹介するのは、GPUに置く層とCPU側に残す層を切り分ける指定(–n-cpu-moe)です。まず全層をGPUへ載せ、その後で専門家にあたる重みを、先頭の層から指定した数だけRAMへ戻す二段構えになります[2]。以前取り上げた解説では、Qwen3-235B-A22Bは総235Bのうちトークンごとに約22Bが動くと説明されていました。今回の35Bモデルと比べても、総量のごく一部だけが稼働する構造は共通しています。
こうしたノウハウは、解説の形でもまとまり始めています。Hugging Faceのブログには、GPU加速と組み合わせてMoEをCPUで回す実践ガイドが投稿されています[4]。GitHubの要点まとめでは、大規模MoEモデルの推論性能を環境ごとに最適化する手順が解説されています[5]。デスクトップのRTX 4070 Ti Superでは、この35Bモデルは記者がテストした中で最も速い動作だったとも述べられています[2]。ツール紹介サイトのToolCenterもBigMoeOnEdgeを掲載し、AIアシスタントや自然言語インターフェースなどの機能を列挙しています[3]。
しかし、手放しで喜べる状況ではありません。Hacker Newsの投稿は現時点で1ポイント・コメント0件で、注目や検証はまだ広がっていません[1]。ToolCenterの情報も薄く、料金や利用制限は未確認で、レビューは一件も付いていません[3]。そもそもこの手法は、ハードウェアを増やすのではなく、重みの置き場所を組み替える回避策です。XDA記事も「ハードリミットに見える制約にも、回避策はほとんど存在する」という趣旨で書いています[2]。そしてRAMを超えるモデルをどう流すのか、その仕組みや速度への代償は、今回の素材からは確認できませんでした。生成速度も「妥当な速度」とあるだけで、トークン/秒などの実測値は素材に見つかりませんでした[2]。
それでも方向性ははっきりしています。壁の位置は、VRAMからRAMへ、さらにその外へと変わってきています。フラグ一つの工夫で8GBのGPUが35Bを扱えた事実は、エッジ端末の可能性を押し広げました[2]。巨大MoEをスマホやノートで動かす流れは、道具・数値・解説が揃いながら、次の段階へ進もうとしているようです。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B … — https://www.xda-developers.com/i-stopped-thinking-my-8gb-gpu-was-too-small-after-learning-to-offload-moe-llm-layers-to-ram/
A lot of what you can do with your PC seems to be limited by the VRAM its GPU has. It decides what resolution your games run at, how large a video project you can edit without the timeline stuttering intermittently, and
- Web記事 記事全文: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://www.toolcenter.ai/en/tools/a-layer-on-top-llama-cpp-enabling-big-moe-streamin
Pricing
Detailed plans have not been confirmed in our catalog. Check the official website for current limits and billing terms.
Visit Website
Prices and limits may change. Confirm the currency, billing period, seat minim - Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: GitHub – Helldez/BigMoeOnEdge: Run MoE models bigger than your RAM … — https://github.com/Helldez/BigMoeOnEdge/tree/main/
GitHub – Helldez/BigMoeOnEdge: Run MoE models bigger than your RAM …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS