🔁 前回の続き: 続:Qwen3.8 27Bの推論設定と速度のその後 📌 エグゼクティブサマリーQwen3.8 Flash Nextは、ai推論で速度と精度の両立が話題です。hacker newsでのローカル報告では27Bが2枚のTesla p100sで約60tok/s、ベンチでは53tok/sです […]
🔁 前回の続き: 続:Qwen3.8 27Bの推論設定と速度のその後 📌 エグゼクティブサマリーQwen3.8 Flash Nextは、ai推論で速度と精度の両立が話題です。hacker newsでのローカル報告では27Bが2枚のTesla p100sで約60tok/s、ベンチでは53tok/sです […]
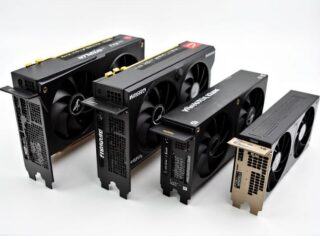
📌 エグゼクティブサマリーNVIDIAのRTX 50系は32Bモデルで最大213 tokens/secと速いが、70B超はVRAM不足が壁です。aiのローカル推論ではメモリ帯域とCUDA代替、中国製チップの動向が中心で、実測の差が読み取れます。買い替え判断も変わります。 「速い」だけでは足りない。a […]
🔁 前回の続き: 続:OpenClawは接続と評価の設計が細かくなる 📌 エグゼクティブサマリーOpenClawはaiエージェントのv2026.5.12で、タスク台帳やメディア/memoryの分離が細かくなりました。評価基盤の名前は増えましたが、具体スコアは素材にありません。追跡記事として、接続から […]
🔁 前回の続き: 続:GrokBotは役割設計と承認停止が鍵 📌 エグゼクティブサマリー派手なflashの更新ではなく、GrokBotは1アカウントで共有クラウドPCを持つ点が核心です。チームでは既定で有効化され、企業では管理者が設定できます。aiの役割設計より共有境界、承認停止、外部権限の取り消し […]
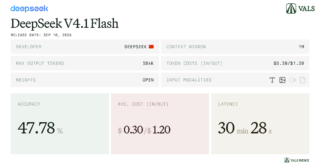
📌 エグゼクティブサマリーVals AIの多段サイバー攻撃タスクで、DeepSeek V4.1 Flash 1017がGPT 6 Solを上回った。Vals Index 57.86%、1テスト0.30ドルと高速。エージェント作業での実力と注意点も把握できる。 画像出典: 記事全文: DeepSeek […]
🔁 前回の続き: 最新:Hermesの三層構造と70ツール 📌 エグゼクティブサマリーHermesの話題は、三層構造やツール数から音声接続へ移ったようです。VoiceManagerは1本のWebSocketで低遅延音声を実現し、Hermes Agentは11プロバイダのTTSに対応します。実測遅延の […]
🔁 前回の続き: llama.cppがCohere対応を進めた 📌 エグゼクティブサマリーllama.cppのCohere対応が、LLMから視覚エンコーダへ進みました。North Mini Codeは総30B、アクティブ3B、256Kコンテキストが示されていますが、実測TPSや電力は素材にありません […]
🔁 前回の続き: 続・Dots、中間公開と音声合成で変わるローカル推論 📌 エグゼクティブサマリーAI音声合成dots.ttsは2Bパラメータで、Seed-TTS-EvalのWERや初音遅延85/54msなど具体的な数値を示しました。音声編集やSGLang Omniの制約も追跡し、ローカル推論への影 […]
🔁 前回の続き: PS5 llama.cpp続報、HackerでflashしたAI推論 📌 エグゼクティブサマリーPS5でllama.cppを動かすPS5LMが、GPU経由のAI推論とOpenAI互換APIまで進みました。27Bモデルで約20トークン毎秒、9Bで55トークン毎秒など、実測がHacke […]
🔁 前回の続き: llama.cppがCohereモデルをローカル推論へ 📌 エグゼクティブサマリーllama.cppがCohereのMoE向け専用パーサを追加し、North Mini Codeの30B総パラメータ・3Bアクティブや256Kコンテキストをローカルで狙えるようになりました。Vision […]
RECENT COMMENTS