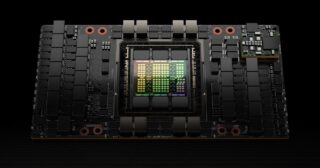
BlackwellがMLPerf Training v5.1で全項目最速となり、B200のmicrobenchmarkではメモリ遅延が58%減りました。AIの推論セッションでは、データのやり取りと次バージョンのFP4の精度が焦点になります。
BlackwellがMLPerf Training v5.1で全項目最速となり、B200のmicrobenchmarkではメモリ遅延が58%減りました。AIの推論セッションでは、データのやり取りと次バージョンのFP4の精度が焦点になります。
OpenAIの仕様更新、行動規範比較、METRの加速評価、市場シェア変化が話題です。ChatGPTは日本で39.36ポイント下落し2位、AIの寄与は約80%と示唆されました。選び方が性能から運用・価値観へ移った状況が伝わります。
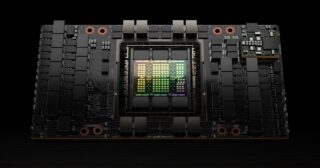
NVIDIAのBlackwellを巡り、MLPerfで全項目最速と報告されました。さらに論文ではB200がH200比で学習スループットが1.85倍、エネルギー効率が32%向上したと実測されています。AIの推論と学習で、FP4と省エネの差が焦点です。
Qwen3.8系の公開とローカル推論が同時に進み、Strataとllama.cppの速度差や27Bの評価と不満が話題です。API版の拡充やAIバブル関連語も加わり、実運用では速さと安定を自分の構成で測る必要があり、分かれ目が見えます。
ThreadShelfの続報です。MCPサーバーは9ツールでObsidianのvaultを既定読み取り専用にし、削除はMCP外に限定します。Hacker Newsの注目度は小さく、AIバブル関連トレンドの中でローカル推論の安全な接続が進みます。
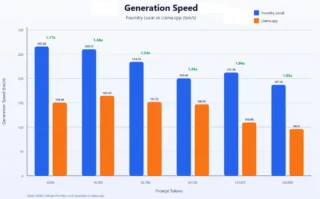
Foundry LocalはQwen3.8-27Bをローカルで動かし、GitHub Copilotに接続します。量子化で約18GB、24GBのGPUメモリで動作し、llama.cppより速いという報告があります。実用性と制約がわかります。
RTX 3090でDeepSeek Flashを動かす試みです。Delta推論エンジンv0.93は192GB RAMで41 tok/s、64GB RAMでも使えると報告されています。品質は99問で52問から57問に改善し、入口がRAMと量子化へと広がりました。
llama.cppチームのMac/Windows向けアプリが話題です。1MBでOpenAI互換APIや自動設定を提供し、Vulkan最適化やベンチマークも続いています。AIバブルの話題の中で、ローカル推論の実用性が見えてきます。
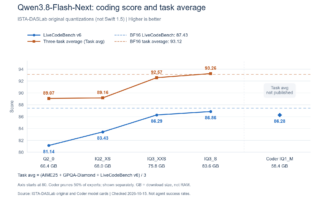
StrataでQwenの小型から大型まで試した結果、VRAMを超える構成でprefillとdecodeが伸びる分岐点が示されました。RTX 3060では35B以上のMoEで最大約2倍、RTX 5060 Tiでは軽い量子化が65.55トークン/秒です。
NVIDIAのBlackwellがMLPerf Training v5.1で全項目で最速を発表しました。H200比ではResNet-50が1.85倍、GPT-1.3Bが1.55倍、電力効率は32%改善しました。FP4と接続仕様からAI推論と学習の変化を解説します。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS