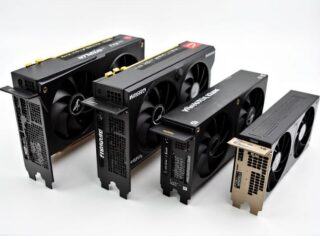
ローカルAI推論では、RTX 50系が32Bモデルで最大213 tokens/secを出す一方、70B超はVRAM不足が壁になります。選定の鍵は計算性能の数字より、VRAM容量とメモリ帯域、CUDAの代替の有無です。
ローカルAI推論では、RTX 50系が32Bモデルで最大213 tokens/secを出す一方、70B超はVRAM不足が壁になります。選定の鍵は計算性能の数字より、VRAM容量とメモリ帯域、CUDAの代替の有無です。
AIエージェントをチャットから動かすOpenClawのv2026.5.12では、タスク台帳やメディア・memoryの分離が細かくなりました。評価基盤の名前も増えていますが、具体スコアはまだありません。接続から記録・評価への流れを整理します。
xAIのGrokBotの核心は、派手なモデル更新ではなく1アカウントで共有するクラウドPCの設計です。ボット間でファイルやログインが共有されるため、チームでは既定で有効、企業では管理者の設定が重要になります。承認停止や外部権限の取り消しまでが一続きの運用です。
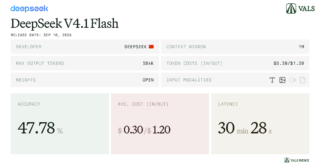
Vals AIの多段サイバー攻撃タスクで、DeepSeek V4.1 Flash 1017がGPT 6 Solを上回りました。総合スコア57.86%で公開モデル1位、1テスト0.30ドルと安く速い点も目立ちます。ただし単発タスクの結果であり、最初の返答までの遅さには注意が必要です。
Hermesの話題は三層構造などから音声接続へ移った。VoiceManagerは1本のWebSocketで低遅延音声を実現し、Hermes Agentは11種類の音声合成に対応。ただし実測遅延の数値はまだ出ていない。
llama.cppのCohere対応が視覚エンコーダまで広がりました。North Mini Codeは総30B・アクティブ3BのMoEで、ローカル実行の道が開いたと報告されています。ただし速度や電力の実測値はまだありません。
AI音声合成dots.ttsが、連続表現・音声編集・低遅延の数値を更新しました。Seed-TTS-EvalのWERや初音遅延85/54ms、編集ベンチdoteBenchを示しています。ローカル環境での実測情報はまだ不足しています。
脱獄したPS5でllama.cppを動かすPS5LMが、GPU推論とOpenAI互換APIまで進みました。27Bモデルで約20トークン毎秒、9Bで55トークン毎秒などの実測がHacker Newsで注目されています。
llama.cppがCohereのMoEモデル向け専用パーサを追加しました。North Mini Codeは総30B・アクティブ3B、256Kコンテキストで、ローカル動作が視野に入ります。ただし実測の速度データはまだありません。
Metaの個人AIエージェント「Muse」に、自分の動作環境を尋ねる試みが注目されています。2vCPUの仮想マシンと、ブラウザを別VMに分離する設計が見えました。実行環境の分離と、無料提供の行方が今後の焦点です。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS