llama.cppの上で巨大MoEをスマホやノートに流す拡張がHacker Newsに投稿され、動的に専門家をオフロードする実装も公開されました。専門家をディスクから先読みする方式は約2倍の速度向上が報告されています。ただし注目は限定的で、複数実装が並立する段階です。
llama.cppの上で巨大MoEをスマホやノートに流す拡張がHacker Newsに投稿され、動的に専門家をオフロードする実装も公開されました。専門家をディスクから先読みする方式は約2倍の速度向上が報告されています。ただし注目は限定的で、複数実装が並立する段階です。
Hacker Newsで、llama.cppの上に層を重ね、スマホやノートPCで大きなMoEモデルをストリーミング推論する試みが紹介されました。8GBのノートPC GPUで35Bモデルを動かした報告もあり、小さい端末で大きいモデルを動かす動きが集まっています。評価はまだこれからです。
AIエージェントの実行を隔離する動きが、個人開発から公式標準へ広がっています。Kubernetesにagent-sandboxが登場し、gVisorを使う個人開発者は認証情報の分離などを工夫。企業向けには1万5000以上のAIツールを管理するセキュリティ製品も現れました。
Javaさえあれば動く単一JARファイルでLLM推論を行い、llama.cppより速いと主張するツールがHacker Newsで話題に。ローカル推論はコスト面でも有利で、RTX 4090なら約5300万トークンで元が取れる計算です。ただし速度比較の実測データはまだありません。
llama.cppのMoEオフロードをめぐり、スマホやノートPCで巨大MoEを動かすラッパーがHacker Newsに投稿されました。Qwen3-235B-A22Bは総235Bのうち約22Bだけが動くため、16GBのGPUでも動かせます。ただしラッパー自体の実測値はまだありません。
スマホやノートPCで巨大MoEを動かすストリーミング層のその後を追った。32GBノートPCで80B MoEを37トークン/秒で動かす報告や、動的エキスパートオフロードの専用フレームワークが登場。一方で注目は限定的で、速度の壁に挑む研究も進む。
RAMが12GBのスマホで、284BのAIモデルが動き出しました。生成速度は毎秒0.94トークン。速くはありませんが、CPUだけでの実行です[4]。きっかけは、Hacker Newsに投稿された「BigMoeOnEdge」です。llama.cpp(ローカルAI実行で定番のオープンソースエンジン)の上 […]
AIエージェントの安全性をめぐり、生成コードを動かす実行環境の隔離が注目されています。gVisorやFirecracker、WASMなどの候補が比べられ始め、端末内で完結させる動きも見えます。安全と速さの両立が課題です。
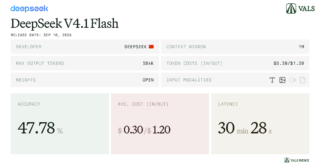
Vals AIの多段サイバー攻撃タスクで、DeepSeek V4.1 Flash 1017がGPT 6 Solを上回りました。総合スコア57.86%で公開モデル1位、1テスト0.30ドルと安く速い点も目立ちます。ただし単発タスクの結果であり、最初の返答までの遅さには注意が必要です。
脱獄したPS5でAIモデルを動かす試み「PS5LM」が再び注目を集めています。小型モデルの推論やAPI対応が進む一方、メモリ制限と導入の壁が課題です。実用性やコストを巡る議論も続いています。
2026.11.11
続・RTX 3090、2026年の中古で24GBとNVLinkが再評価される
2026.11.11
続・Qwen4、4種とFlashが示すローカル実行の行方
2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
RECENT COMMENTS