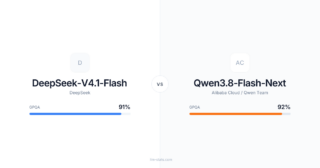
180B・活性化6BのQwen3.8-Flash-Nextが、スコア比較でMetaの816Bモデルを上回る40点を記録し話題に。ローカル実測ではDeepSeek-V4.1-Flashの量子化に対し25問全問正解と好調です。一方で総合指標ではDeepSeekに僅差で及ばず、必要メモリも111GB超と軽量ではありません。
180B・活性化6BのQwen3.8-Flash-Nextが、スコア比較でMetaの816Bモデルを上回る40点を記録し話題に。ローカル実測ではDeepSeek-V4.1-Flashの量子化に対し25問全問正解と好調です。一方で総合指標ではDeepSeekに僅差で及ばず、必要メモリも111GB超と軽量ではありません。
Qwen3.8のローカル実行で、125B MoEのFlash-Nextと27B denseモデルの比較が進んでいます。IQ2まで圧縮したFlash-NextがQ8の27Bをコーディングで上回った報告や、RTX 4070 1枚での実測が共有され、用途別の使い分けが見えてきました。
VRAM12GBのグラフィックボード1枚で、1250億パラメータのモデルが動く——。ローカル推論エンジン「Strata」をめぐり、そんな報告が相次いでいます。開発者Niko1221氏によるオープンソースのこのプロジェクトは、Qwen3.8-Flash-Next 125Bという大型のMoEモデルを、1 […]
Qwen3.8 Flash Nextを巡り、速度と精度を両立させる工夫が話題です。ローカルでは27BモデルがGPU2枚で約60tok/s、ベンチでは53tok/sという報告があります。評価データの欠落もあり、数字の背景にある条件が結果を左右します。
Qwen3.8-Flash-Nextで、DFlash2が同時実行1で約20%速いとの報告や、53tok/s・262Kという公開値が話題です。英語限定の量子化版は多言語を犠牲にします。速度と能力の両立への道筋を追跡します。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS