1MBのアプリでAIが手元で動きます。llama.cppチームがMacとWindows向けのデスクトップアプリを公開し、それがHacker Newsに投稿されました[1][5]。Xのトレンドでは「AIバブル」「AIバブル崩壊」も上がっています[3]。こうした語が並ぶ中、ローカル推論の入口が手軽になった点が目立ちます。
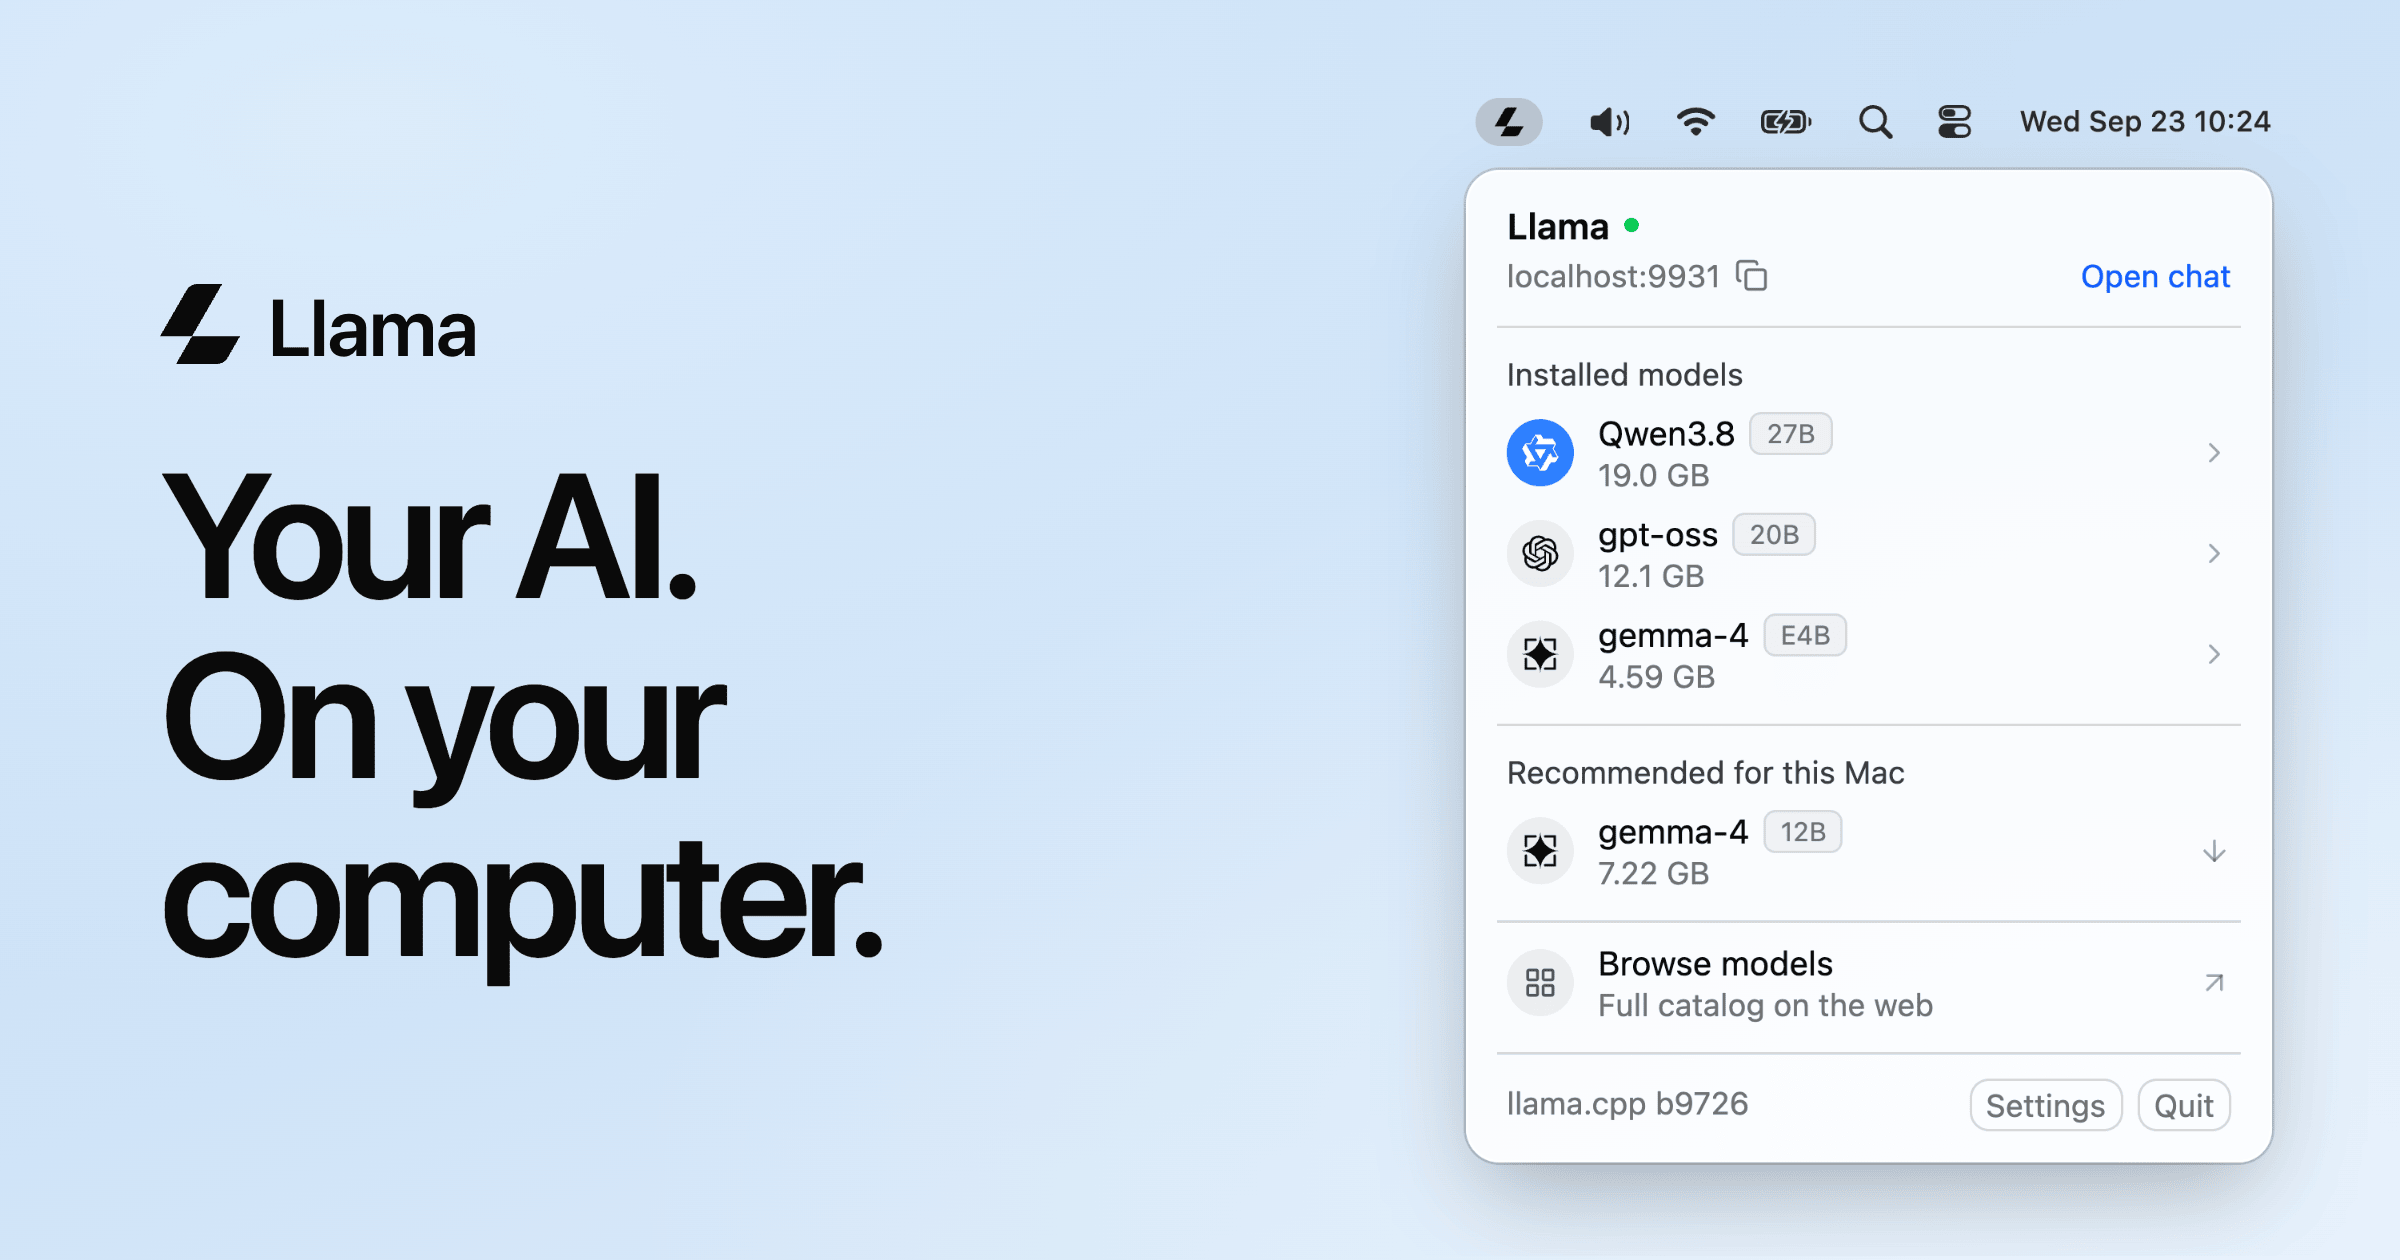
Llama appはメニューバーやシステムトレイに常駐します。ブラウザでチャットでき、OpenAI互換APIもローカルで公開します。URLはlocalhost:9931/v1です[5]。アプリはMacやPCの構成に応じて、量子化、コンテキスト長、画像入力、推測デコード、バッチサイズを選びます。量子化は重みを圧縮してメモリを節約する仕組みで、コンテキスト長は一度に扱える文章の長さ、バッチサイズはまとめて処理する量です。詳しいオプションの調整は平文ファイルで管理されます。セットアップの手間と制御の両立を狙った設計です[5]。Windows版はWinUI 3のトレイアプリで、x64とARM64の.msixbundleが配布されます[6]。Alt+Spaceでどのアプリからでも呼び出せます[6]。モデルはHugging Faceキャッシュに保存され、llama.cppや他ツールと共有されます[5][6]。LinuxやCLI向けには1行のインストールコマンドも用意されています[6]。MacでCLIを使わずに動かすという紹介記事もあります。
低レベルでは、リリースb12143でVulkanのFWHTカーネルが幅512超のブロックに対応しました[2]。VulkanはGPU向けの計算基盤です。FWHTはHadamard変換という特定の行列計算を速くする仕組みで、量子化モデルの推論で効いてきます。F16入力も追加されました。MoltenVKで半精度を有効にしたM5 Pro環境で、test-backend-opsのMUL_MAT(行列乗算)は1128/1128、Hadamardケースは24件(既存F32 18件、新規F16 6件)を通ったと報告されています[2]。b12142では、FAのdequant経路で、アテンション計算に使うK+Vのf16一時メモリサイズを確認する修正も入りました[2]。dequantは量子化を解除して計算する経路です。Qwen3.8-Flash-Nextのllama.cpp対応を扱う記事もあり、アプリの裏側ではこうした最適化が続いています。
周辺ツールも増えています。llama-benchというベンチマーク用ツールも公開されています。Qualcomm向けのllama.cppでもベンチマークと評価ツールの解説があり、2026年の推論速度最適化ガイドも登場しました。単に動くだけでなく、どの構成で速く動かすかが定番の話題になっています。
ただし、万能ではありません。VulkanのF16 FWHTは、デバイスがF16を直接扱える場合だけ専用の実行パスを作り、非対応なら従来の計算にフォールバックします[2]。幅512超では共有メモリを使う別の計算方法に切り替わり、デバイスの制限次第で一部の幅は使えません[2]。アプリ側も、モデルを5分間アイドルでアンロードし、メモリに収まる量子化やコンテキスト長を選びます[5]。重いモデルを常時起動し続ける用途には、向かない面があります。Windows版はテレメトリを送らないとしていますが、モデルのダウンロードや更新確認では、HTTPリクエストのアプリ情報にアプリ版、OSビルド、アーキテクチャが載ります[6]。
それでも、llama.cppの話題はCLIの速さ比べから、日常のアプリとAPIへ移っています。Hacker Newsでは、量子回路をllama.cppの中で動かすqullamaも投稿されました[4]。ローカルAIを試す入口として、1MBのアプリ、OpenAI互換API、自動設定、Hugging Faceとの共有、ベンチマーク、量子回路の実験が同じ文脈に並びました[1][4][5][6]。AIバブルの言葉がトレンド入りする今[3]、手元で推論を回す地味な改良が、次の評価基準を作るようです。
引用ソース
- Hacker News Hacker News: Desktop app from the llama.cpp team (Mac OS and Windows) — https://llama.app/models
Desktop app from the llama.cpp team (Mac OS and Windows)
- Web記事 記事全文: Releases · ggml-org/llama.cpp · GitHub — https://github.com/ggml-org/llama.cpp/releases
b12143
vulkan: FWHT kernels for block widths above 512 (#29772)
– vulkan: add F16 input to the FWHT
The Vulkan FWHT accepts F32 input only. This adds an F16 source variant of the
shader, for both the subgroup and the sha - X Xトレンド: AIバブル崩壊 — https://trends24.in/japan/
AIバブル崩壊
- Hacker News Hacker News: Running quantum circuits inside llama.cpp — https://github.com/dakk/qullama
Running quantum circuits inside llama.cpp
- Web記事 記事全文: Llama · Your AI, on your computer — https://llama.app/
Your AI.
On your computer.
Llama is a tiny menu bar app that runs the latest open models on your Mac. Llama is a system tray app that runs the latest open models on your PC. Llama is an app for Mac and Windows that runs - Web記事 記事全文: GitHub – ggml-org/Llama-Windows: Windows Llama App Companion — https://github.com/ggml-org/Llama-Windows
Local LLMs, one click away — right from your Windows system tray.
Llama is a Windows 11 tray app for running llama.cpp models locally. It’s a WinUI 3 port of Llama for Mac.
Grab the latest .msixbundle (x64 + ARM64) from - Web記事 記事全文: Installation — llama.app — https://llama.app/docs/installation
Installation
You can easily install llama.cpp on your machine:
– Mac and Windows: install the Llama app
– Linux (or if you only want the command line): one-line install command
Llama app (recommended)
Download the app fo - Web記事 Web検索: Llama Windows: llama.cpp in Your Windows Tray (Free) | explainx.ai Blog — https://www.explainx.ai/blog/llama-windows-app-llama-cpp-tray-rtx-spark-hugging-face-2026
Llama Windows: llama.cpp in Your Windows Tray (Free) | explainx.ai Blog
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。

RECENT COMMENTS