VRAM 16GBのGPUで、235Bの巨大モデルが動く。名前だけ聞くとH100(データセンター向けの高価なGPU)のラックが要るように思えますが、動かすだけなら話が違います[3]。以前取り上げたllama.cppのMoEオフロードをめぐり、その「なぜ」と「速度の代償」を解説する記事が相次いで登場しました[2][3]。
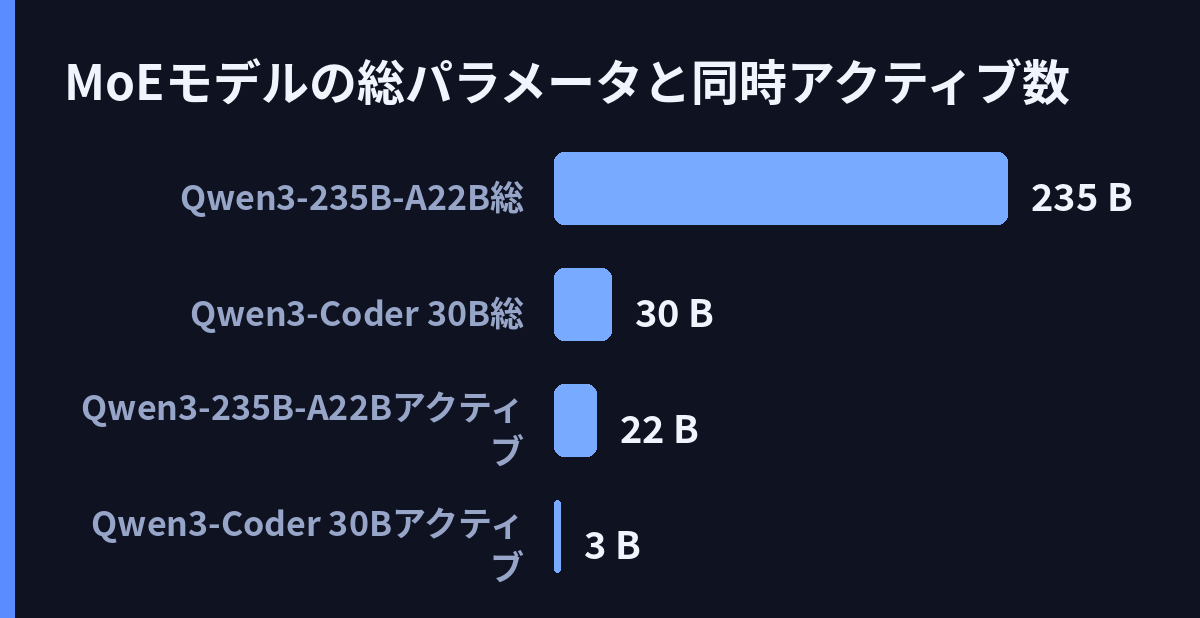
以前の記事では、8GBのGPUで35Bモデルが動く現象そのものをお伝えしました。今回は一歩進んで、仕組みの核心がはっきりしてきています。MoE(混合エキスパート)は、トークンごとに必要な一部の専門家ネットワーク(エキスパート)だけを動かすモデル構造です。Qwen3-Coderの30Bモデルは、同時に動くのはわずか3Bです[2]。Qwen3-235B-A22Bも、総パラメータ235Bのうち動くのは約22Bにすぎません[3]。
ところが推論では、動かないエキスパートもどこかに置いておく必要があります。16GBや24GBのマシンでは、この「置き場所」が最大の壁になります[2]。そこで使われるのが、前半の層のエキスパート重みをVRAMではなくシステムRAMに置く指定(–n-cpu-moe)です[2]。解説記事はこれを「最適化ではなく調整ノブ」と表現します。数を増やすほどVRAMは節約できる一方、トークンごとのCPU処理が増えて速度は落ちます[2]。適正値は「モデルがメモリ不足で読み込めなくなる直前まで上げた数」という、実践的な考え方です[2]。
効果は具体例がはっきりしています。attention(関連する箇所に注目する計算)と、実際に動く部分の計算はGPUに残す。巨大なエキスパート重みだけをRAMへ逃がす。これだけで30BクラスのMoEモデルが16GBのカードで使えるようになります[2]。より細かく詰める方法もあります。従来の「GPUに積む層数を指定するオプション」は層の中身を見分けられず、小さなattentionのテンソル(重みのひとかたまり)が、VRAMを食う巨大なエキスパート重みと一緒にGPUに残って無駄になることがあります[3]。そこで層単位ではなくテンソル単位で置き場所を指定できる正規表現ベースの仕組み(–override-tensor)を使うと、フラットな層指定より多くをGPUに収められるようです[3]。また、CPUとGPUに処理を分けると、論理・物理のバッチサイズの既定値(2048と512)がGPU専用前提で小さすぎます。この構成のガイドの多くは、物理バッチを1024以上に引き上げるよう勧めています[3]。
ここからが次の段階です。エキスパートをRAMに事前に置くのではなく、ディスクから必要な分だけオンデマンドで流し込む方式の実装が、執筆時点で少なくとも5つ独立に出ています[2]。仕組みはこうです。トークンにどのエキスパートを使うか決めるルーターの計算は、現在の層のattentionが終わるより先に完了します。この空き時間が「先読みの窓」になり、次の層に必要な重みを、計算の裏側でディスクから読み込めるのです[2]。あるプロジェクトの議論では、この入出力と計算の重ね合わせにより、全量を事前ロードする場合よりスループット(単位時間あたりの処理量)が約2倍になったと挙げられています[2]。
ただし、期待ばかりではありません。–n-cpu-moeは速度と引き換えにVRAMの余裕を確保する手段で、その代償はトークン/秒に直接表れます[2]。ディスクストリーミングも公式に取り込まれた機能ではなく、まだ機能要望とコミュニティ実装の段階です[2]。一方、スマホとラップトップで巨大MoEを流すことを目指すレイヤー(BigMoeOnEdge)がHacker Newsに投稿されましたが、現時点でポイント1・コメント0と、注目はまだ限定的なようです[1]。
周辺も動いています。Hugging FaceのブログではCPU推論とGPUアクセラレーションの組み合わせが解説され[4]、GitHub Gist上の最適化ガイド[4]や、MoE推論の最適化を進めるプロジェクトllama.moe[4]も現れました。総パラメータの大きさはそのままに、動く部分だけを賢く配置する。MoEの構造が、メモリの壁をソフトウェア側から崩しつつあります。先読み方式が標準機能になれば、消費者向けマシンで動くモデルの上限は、また一段上がると思われます。
引用ソース
- Hacker News Hacker News: Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop — https://github.com/Helldez/BigMoeOnEdge
Show HN: A layer on top llama.cpp enabling big MoE streaming on phone and laptop
- Web記事 記事全文: llama.cpp's MoE Expert Offload: –n-cpu-moe and Streaming, Explained — https://www.shawnmayzes.com/ai-engineering/llama-cpp-moe-expert-offload-explained/
llama.cpp’s MoE Expert Offload: –n-cpu-moe and Streaming, Explained
– 8 min read
If you’re running a mixture-of-experts model locally – Qwen3-Coder, DeepSeek-class models – the whole appeal is that only a fraction of th - Web記事 記事全文: Run Bigger Local AI Models on Less VRAM: llama.cpp MoE Offloading Guide … — https://aliteq.com/llama-cpp-moe-offloading-run-bigger-models-less-vram
Qwen3-235B-A22B sounds like a model that needs a rack of H100s. It doesn’t — not to run it, anyway. It has 235 billion total parameters, but only about 22 billion of them activate for any given token, because it’s a mixt
- Web記事 Web検索: Performant local mixture-of-experts CPU inference with GPU acceleration … — https://huggingface.co/blog/Doctor-Shotgun/llamacpp-moe-offload-guide
Performant local mixture-of-experts CPU inference with GPU acceleration …
- Web記事 Web検索: GitHub – jklincn/llama.moe: Optimized inference of MoE models based on … — https://github.com/jklincn/llama.moe
GitHub – jklincn/llama.moe: Optimized inference of MoE models based on …
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS