
GPUの話題は、また一段階進みました。NVIDIAのBlackwell世代を、microbenchmarkで細かく解剖する動きが目立ちます。microbenchmarkは、小さな処理を繰り返して性能の癖を確かめる検証です。AI(ai)の推論や学習で、どこが速いのかをhacker的な視点で見る試みと言えそうです。公式の速さだけでなく、内部の仕組みが問われています。
その土台にあるのがH100です。NVIDIAの公式ページは、H100がデータセンター向けの性能、拡張性、安全性を備えると説明しています[1]。大規模言語モデルは30倍高速化するとされます[1]。GPT-3 175Bの学習では、前世代比で4倍速いとしています[1]。Hopperアーキテクチャを使い、Transformer EngineとFP8を備えます[1]。Transformer Engineは、Transformer向けの専用回路です。FP8は、数値の精度を落として計算を軽くする仕組みです。

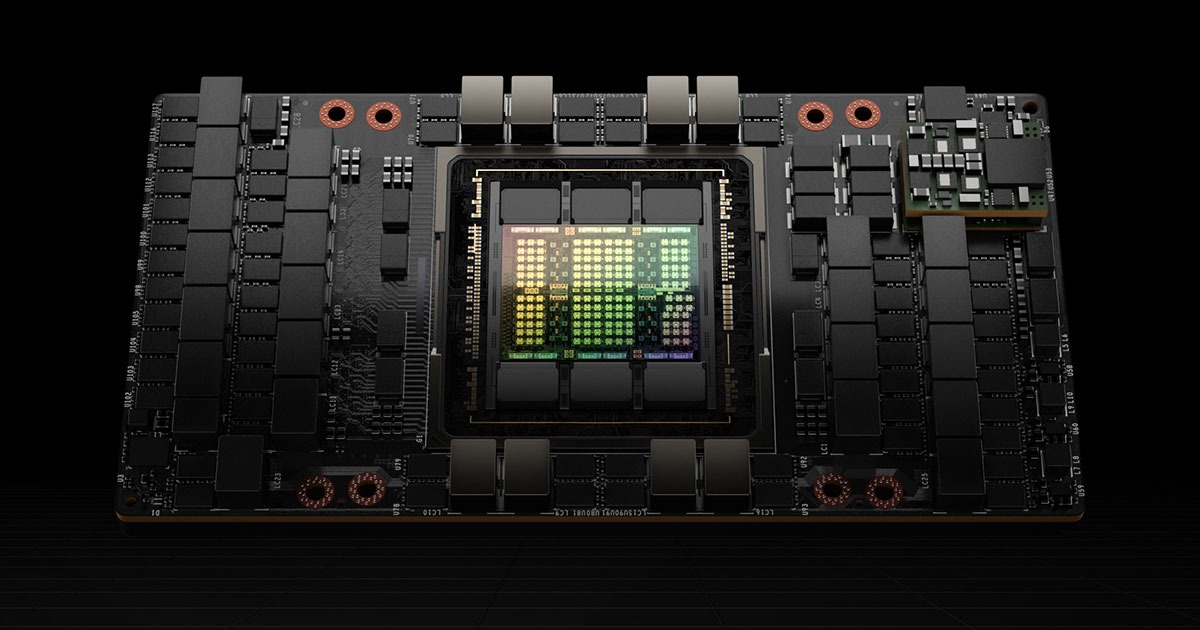
H100は、1兆パラメータ規模の言語モデルも想定しています[1]。推論では最大30倍、低い遅延を強調します[1]。第四世代Tensor Coreは、FP64やINT8など幅広い精度を高速化するとされます[1]。Tensor Coreは、行列計算向けの回路です。GPU間の接続は900 GB/sです[1]。これは、複数のGPUを束ねるセットで効いてきます。NDR Quantum-2 InfiniBand、PCIe Gen5、Magnum IOも挙げられています[1]。
素材には、MoEの条件も出ています。MoEは、専門家を集めたように一部の回路だけを使う仕組みです。Switch-XXLの395Bパラメータ、1Tトークンという例が書かれています[1]。ただし、これは予測値で、変更されうると注記されています[1]。A100側はHDR IB、H100側はNDR IBという条件も書かれています[1]。データシートも検索結果にあります[2]。ただし、今回の素材ではPDF本文が文字化けしており、数値は読み取れませんでした。
Blackwell側には、技術概要やMLPerf Training v5.1関連の話題が並びます[4][7]。MLPerf Trainingは、機械学習の学習性能を測るベンチマークです。RTX Blackwellをmicrobenchmarkで解剖する論文も確認できます[3][5][6]。IEEE Xploreに検索結果があり、arXivにはHTML版とPDF版があります[3][5][6]。NVIDIAはBlackwellがMLPerf Training v5.1を席巻したと見出しで示しています[4]。ただし、具体的なスコアは素材に出ていません。技術概要もタイトルから存在はわかりますが、本文の詳細は素材にありません[7]。
ここから読み取れるのは、評価の段階が変わったことです。H100の話題は、公式が示した倍率と接続速度が中心でした[1]。Blackwellの話題は、microbenchmarkで細部を測る方向に進んでいます[3][5][6]。ベンダー記事と研究寄りの検証が混在している点も、読み分けが必要です。MLPerf Training v5.1の席巻という見出しは強いですが、数値がなければ比較はできません[4]。
ここで注意が必要です。以前取り上げたA100の価格や音声モデルの実測とは、条件が異なります。同じGPU・同じモデル・同じベンチマークでなければ、単純な比較はできません。flash attentionのような語で速さを語りたいところですが、今回の素材には数値がありません。ローカル実行の話とも直接は結びつきません。推論の速さは、モデルの大きさや接続条件に左右されます[1]。
それでも、注目点は移っています。H100では30倍と4倍という数字が前面に出ていました[1]。Blackwellでは、microbenchmarkで内部の癖を確かめる段階に入ったようです[3][5][6]。次の注目点は、バージョンごとの実測値と、推論セッションでの応答性です。GPUの性能は、見出しだけでなく検証の数値で決まります。技術概要とmicrobenchmarkが組み合わさることで、次の評価が見えてくると思われます[7]。
引用ソース
- Web記事 記事全文: H100 Gpu | Nvidia — https://www.nvidia.com/en-us/data-center/h100/
Extraordinary performance, scalability, and security for every data center.
The NVIDIA H100 GPU delivers exceptional performance, scalability, and security for every workload. H100 uses breakthrough innovations based on - Web記事 記事全文: PDF NVIDIA H100 Tensor Core GPU Datasheet | NVIDIA — https://dam-cdn.nvd.orangelogic.com/AssetLink/u5hh6fv4r7564i4y673484y3m20083nj.pdf
�t6�Wu �dgm��-�֨mEI�&� ʎ���3�J�!5�1�D�L��_�Mv�f��Q���ޑ��N8���:, �s�’9Ŷ#?y�͗�3W�(Ӥ]�c��eI<3�`7�ݐ”�,S��5[�<���,��(P�”V;EC��ό”#���1�ݪ,5 �dcma�-�hZ��/X���w����n�7Q�6F6��؝���V ‘M��sJ��� J\:`��. �Hr��:T
- Web記事 Web検索: Dissecting the NVIDIA RTX Blackwell Architecture with Microbenchmarks — https://ieeexplore.ieee.org/document/11459272
Dissecting the NVIDIA RTX Blackwell Architecture with Microbenchmarks
- Web記事 Web検索: NVIDIA Blackwell Architecture Sweeps MLPerf Training v5.1 Benchmarks — https://developer.nvidia.com/blog/nvidia-blackwell-architecture-sweeps-mlperf-training-v5-1-benchmarks/
NVIDIA Blackwell Architecture Sweeps MLPerf Training v5.1 Benchmarks
- Web記事 Web検索: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://arxiv.org/html/2512.02189v1
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth …
- Web記事 Web検索: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://arxiv.org/pdf/2512.02189
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth …
- Web記事 Web検索: NVIDIA Blackwell Architecture Technical Overview — https://resources.nvidia.com/en-us-blackwell-architecture
NVIDIA Blackwell Architecture Technical Overview
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。

RECENT COMMENTS