システムメモリ8GBのPCでも、125BのMoEモデルが約20 tok/sで動きました。こんな実測レポートが、Redditのr/LocalLLaMAで注目を集めています[1]。MoEは、専門担当の小さなネットワーク「エキスパート」を必要な部分だけ切り替えて使う、大規模モデルの構造です。
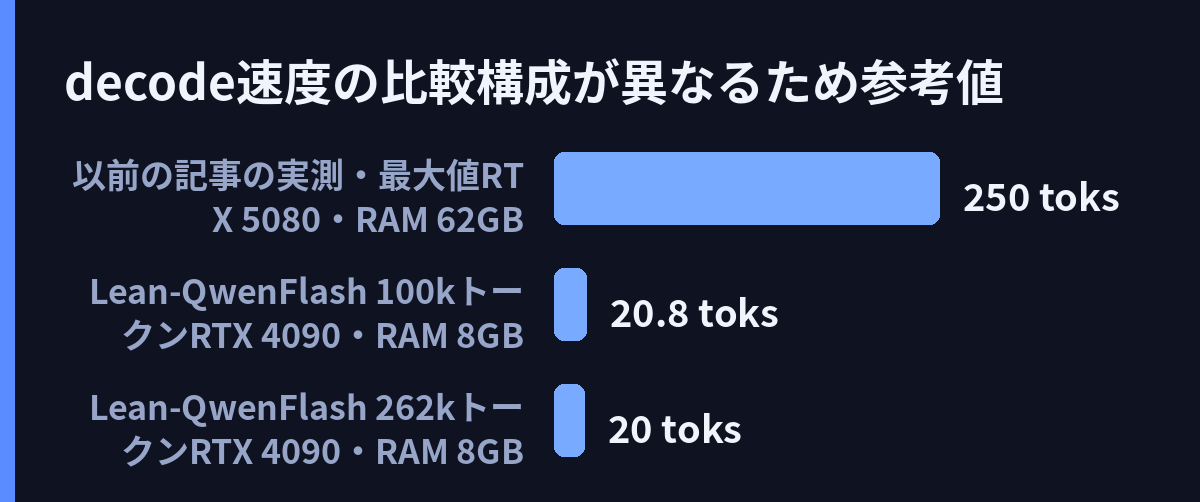
話題のStrataは、大規模モデルを自分のPCで動かすためのローカル推論エンジンです。以前の記事で取り上げた実測では、RTX 5080(16GB VRAM)、Core Ultra 9 285K、DDR5-6800のメモリ62GB、同時実行数1という構成で、125B級モデルが最大250 tok/sを記録していました。今回の投稿は、その先にある「RAMがほとんどないPC」を狙った試みです。
投稿者によると、Qwen3.8-Flash-Nextの一般的な動かし方では、約2.4万個のエキスパートをすべてシステムRAM(約48〜64GB)に置きます。Strataもこの方式で、RAMに載っていない部分はCPU側で処理します[1]。高性能ワークステーション向けの設計で、メモリが少ない普通のPCやノートには荷が重いのが実情でした。投稿者が目をつけたのは、GLM-5.3を驚くほど少ないメモリで動かしていた実装「glm-flash-lite」です。モデルの規模の割にメモリ消費が突出して少なく、「効率的な設計が見過ごされている」との思いから、その考え方をQwen3.8-Flash-Nextに応用。NVMe SSD(高速なSSD)からエキスパートを直接読み込む方式を試しました。
構成はRTX 4090(16GB VRAM)で、システムRAMの割り当てはわずか8GBです。重みは1つあたり約3ビットまで削る量子化(重みを圧縮してメモリを節約する仕組み)を使い、文脈を保持するKVキャッシュもQ4(4ビット)に圧縮しています[1]。結果は、8kトークンの短い文脈で28〜33 tok/s(文章)、コードでは19〜22 tok/s。prefill(プロンプト全体を一括処理する段階)は約1,080 tok/sでした[1]。ノートPC向けのRTX 3080 Laptopでの検証も併せて報告されています。
長い文脈でも速度は持ちこたえます。100kトークンではdecode(トークンを1つずつ生成する段階)が20.8 tok/s、prefillは約1,536 tok/s。最大の262kトークン(全ウィンドウ)でもdecodeは20.0 tok/sを維持し、prefillは約1,627 tok/sとむしろ伸びました[1]。文脈をどこまで伸ばしてもdecodeが約20 tok/s前後で安定するのが、この方式の強みのようです。
もっとも、代償もはっきりしています。前述の250 tok/sという実測は、RAMが潤沢な構成での話です。今回は約20 tok/s。GPUもRAMも構成が違うため単純比較はできませんが、RAMを大幅に削る代わりに速度を犠牲にする方向であることは間違いないようです。エキスパートをSSDから読み込む分の待ち時間が響いていると思われます。興味深いのは、Strata本体の最新版0.2.6が逆アプローチを取った点です。CPU側のエキスパートが全部RAMに載り、なお8GiB余るときは、ロード時に一括コピーして必要な都度の読み込みをやめる変更が入りました[2]。WindowsではRAMとページファイル(仮想メモリ)の合計も確認され、ページファイルが小さいPCでは無理をしない設計です。
0.2.6ではこのほか、Windowsのアンインストール後にプログラムフォルダが残る問題の解消、内蔵GPUを実カードとは別に数えてしまう表示の修正などが行われています[2]。DeepSeekエンジンは0.1.51に更新された一方、Qwenエンジンは0.1.50のまま変更なしです。また、20ドルで入手したというXeonサーバーで「PolyStrata」を動かした投稿も現れており、安価な中古サーバーで試す動きも見られます[3]。
125B級MoEのローカル実行をめぐっては、VRAMに載るかどうかだけでなく、VRAM・RAM・SSDの分担をどう組むかが鍵になってきています。RAMが潤沢なら全部載せて速く、なければSSDから直接読んで動かす。StrataはRAMの空きを自動判定して動作を切り替えるようになり、エンジン選びでも「自分の環境に合う方式か」が重要になってきたと思われます。普通のPCでも大規模モデルが動かせる場面が、着実に増えていきそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: Lean-QwenFlash: Qwen3.8-Flash-Next (125B) running at ~20 tok/s on 16gb vram and 8gb ram via direct nvme SSD offloading — https://www.reddit.com/r/LocalLLaMA/comments/1xev6bo/leanqwenflash_qwen38flashnext_125b_running_at_20/
Lean-QwenFlash: Qwen3.8-Flash-Next (125B) running at ~20 tok/s on 16gb vram and 8gb ram via direct nvme SSD offloading
- Web記事 記事全文: Releases · Niko1221/Strata – GitHub — https://github.com/Niko1221/Strata/releases
Releases: Niko1221/Strata
Release list
Strata 0.2.6
Strata 0.2.6: fixes from the stress tests, a faster DeepSeek on big-RAM PCs, and an uninstaller that finishes the job
The app and the Terminal are 0.2.6. The DeepSeek e - Reddit Reddit r/LocalLLaMA: Show and tell: PolyStrata on my $20 Xeon server — https://www.reddit.com/r/LocalLLaMA/comments/1xfb9oz/show_and_tell_polystrata_on_my_20_xeon_server/
Show and tell: PolyStrata on my $20 Xeon server
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS