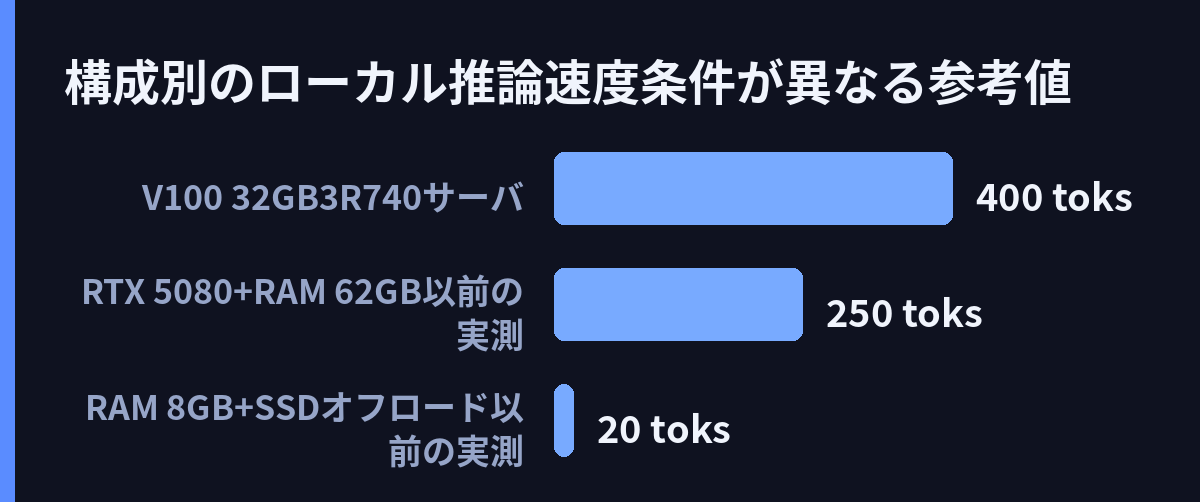
V100 3枚を積んだ古いサーバ1台で、125B級のモデルがほぼ400 tok/s。Redditのr/LocalLLaMAに投稿されたこの実測が、ローカルLLM好きの間で話題になっています[1]。投稿者はローカル推論エンジン「Strata」をフォークし、エンジンの内部を古いGPU向けに作り直したうえで、Qwen-Flash-Nextを動かしました[1]。使ったのはR740という古いサーバに搭載したV100 32GB 3枚です[1]。
Strataは、Qwen3.8-Flash-Nextをコンシューマ向けハードウェアで動かすための無料のオープンソースプロジェクトです[2]。チャットやコード、画像の扱いをローカルで完結でき、アカウント登録も不要です[2]。デスクトップアプリとターミナルの両方で動き、Claude CodeやCodex CLIといったコーディングツールからも使えます[2]。対応GPUはNVIDIA RTX 30/40/50シリーズ(WindowsとLinux)と、AMD Radeon AI PRO R9700(Linux)です[2]。メモリに収まらない部分はSSDから読み込む仕組みを持ち、その分、空きディスク容量は多く必要です[2]。公式サイトは「125B超のMoEモデルを12GB VRAMのGPUで動かす」ことをうたっています[4]。MoEとは、入力に応じて多数の「エキスパート」と呼ばれる専門家ネットワークの一部だけを使い、計算を減らす構造のことです。
速度の示し方も特徴的です。Strataは回答の出力速度と、入力(プロンプト)を読む速度を分けて計測します[2]。それぞれdecode(トークンを1つずつ生成する段階)と、prefill(プロンプト全体を一括処理する段階)にあたります。重みを圧縮してメモリを節約する量子化では、ISTA-DASLabとUnslothのパックを推奨し[2][5]、重み1つあたり2ビットに圧縮した「2.00bpw」のセットで計測値を出しています[2]。
バージョン0.2.6では、大容量RAM搭載PCでのDeepSeekが高速化されました[3]。CPU側に置くエキスパートがすべてRAMに載り、なお8GiB余る場合、起動時に全部を読み込んで動きます[3]。この場合、必要な部分をその都度読み込む方式は使われません[3]。WindowsではRAMにページファイルを加えた空きまで確認する、丁寧な作りです[3]。背景として、Qwen3.8-Flash-Nextの一般的な動かし方では、約2.4万個のエキスパートをシステムRAM(約48〜64GB)に置きます(以前の記事で取り上げた実測)。0.2.6には細かい修正も多く、Windowsのアンインストールでフォルダが残る問題の解消や、内蔵GPUがあるPCでのモニター表示の改善も含まれます[3]。
しかし、どちらの話にも条件が付きます。0.2.6の高速化は、RAMに十分な余りがあるPC限定です。以前取り上げた実測では、システムメモリ8GBのPCでは125BのMoEモデルが約20 tok/sにとどまりました。同じく以前の実測では、RTX 5080(16GB VRAM)とメモリ62GB、Core Ultra 9 285Kの構成で、125B級モデルが最大250 tok/sを記録しています。V100 3枚のほぼ400 tok/sは構成も条件も異なるため、単純比較はできません。それでも、公式の対応リストにVolta世代は含まれていません[2]。エンジン内部を自前で作り直してこの速度に到達したのは、ハッカー精神を感じさせる試みです[1]。
意外な発見もありました。0.2.6では、1トークンだけの応答でtok/sを表示しないよう修正されたのです[3]。以前は1トークンだけの試験で、モニターが1,250 tok/sと読み取れる状態でした[3]。実態より速く見える数字だったわけで、速度の数値は測り方次第で変わる、という教訓です。周辺でも、トークン速度の見積もりツール[5]やtok/sの解説[5]、GPU別のスループットベンチマーク[5]が公開されており、数字の読み方への関心が高まっています。
公式の更新と個人のフォークが、別々の条件でローカル推論を前進させています。最新GPUを持たない環境では、SSDオフロードとRAM活用の両面で最適化が進みました。対応外の古いGPUにも、自分で道を開く動きが加わっています。125B級を「どんなPCでも、どんな古いサーバでも」動かす挑戦は、まだ続きそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: I built an engine that runs Qwen-Flash-Next at nearly 400t/s on cheap(ish) hardware. 3x V100 32GB in an old R740. Originally forked from strata but the engine guts all built for the old Volta generation. — https://www.reddit.com/r/LocalLLaMA/comments/1xg9cr1/i_built_an_engine_that_runs_qwenflashnext_at/
I built an engine that runs Qwen-Flash-Next at nearly 400t/s on cheap(ish) hardware. 3x V100 32GB in an old R740. Originally forked from strata but the engine guts all built for the old Volta generation.
- Web記事 記事全文: GitHub – Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware … — https://github.com/Niko1221/Strata
Chat, code and work with images, locally.
Models · Install · Hardware · Tools · Help · Support
English · 简体中文 · 日本語 · Deutsch · Français · Español · Português
Free, open source, and yours to run. Use Strata on your deskt - Web記事 記事全文: Releases · Niko1221/Strata – GitHub — https://github.com/Niko1221/Strata/releases
Releases: Niko1221/Strata
Release list
Strata 0.2.6
Strata 0.2.6: fixes from the stress tests, a faster DeepSeek on big-RAM PCs, and an uninstaller that finishes the job
The app and the Terminal are 0.2.6. The DeepSeek e - Web記事 Web検索: Strata LLM – Run 125B+ MoE Models on 12GB VRAM Consumer GPUs (Docs & Setup) — https://stratallm.org/
Strata LLM – Run 125B+ MoE Models on 12GB VRAM Consumer GPUs (Docs & Setup)
- Web記事 Web検索: Supported Models & Quantization – Strata LLM (Qwen 125B, DeepSeek MoE … — https://stratallm.org/docs/models/
Supported Models & Quantization – Strata LLM (Qwen 125B, DeepSeek MoE …
- Web記事 Web検索: Strata Token/s Estimator: Model Speed and Hardware Upgrade Savings — https://eth-lab.com/en/2026/10/strata-tokens-estimator-en/
Strata Token/s Estimator: Model Speed and Hardware Upgrade Savings
- Web記事 Web検索: Understanding tokens-per-second in Local LLM Inference · Strata — https://www.stratat.com/en/guides/tokens-per-second
Understanding tokens-per-second in Local LLM Inference · Strata
- Web記事 Web検索: LLM Throughput Benchmark: Tokens/sec by GPU and Provider — https://tokendyno.com/blog/llm-throughput-benchmark/
LLM Throughput Benchmark: Tokens/sec by GPU and Provider
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS