「Strata」が再び話題です。以前は古いサーバでの実測が注目されましたが、今回はコミュニティの計測とコスト計算が進んだようです。Redditでは「2つのStrataエンジンを回して、それぞれ70tps(1秒あたり70トークン)、1日12Mトークン」という報告がありました[1]。投稿者は自分を「ローカルな王様」と呼んでいます[1]。MoEは複数の専門家ネットワークを状況に応じて使う仕組みです。
この投稿は、ローカル実行の規模感を示しています。一方、Twitterでは「potetoが1分間に34M(3400万)トークン」という話も紹介されています[1]。投稿者によれば、potetoはCursorがXAIに買収される前に働いており、今はCursorとGrokBotへ月2500件のPRを出しているそうです[1]。ローカルとクラウドのトークン消費は、桁が違いそうです。この差は、ローカルとクラウドの使い道の違いを示唆しています[1]。
Strata本体は、125B超のMoEモデルを12GB VRAMのコンシューマーGPUで動かすことをうたっています[4]。公式ドキュメントとセットアップ案内も用意されています[4]。Niko1221氏によるローカル推論エンジンとして紹介する記事もあり、125Bモデルを限られたVRAMで動かすという説明です[5]。推論にはprefill(プロンプト全体を一括処理する段階)とdecode(トークンを1つずつ生成する段階)があります。
注目すべきは、GitHubのコミュニティベンチマークガイドです[2]。自分のハードで測った結果を共有し、他の人が同じ環境で再現できる形にしようという試みです。1つのモデル、1つのGPU、1つのコンテキスト長でも貢献できる、とされています[2]。例としてRTX 5090、Core Ultra 9 285K、64GB RAMで、Strata 0.1.29とFlash-Next IQ2_XS(量子化の型名)を131,072トークンコンテキストで走らせる報告が挙げられています[2]。4,096、32,768、128,000トークンのプロンプトで各3回、さらにリコール確認を6回行う、という細かさです。ガイドでは、ハード、ソフト、モデル、設定、ワークロードの5種類を求めています[2]。PCIeの速度や電力制限、複数GPUの選択、カスタムパックやドラフト語彙のハッシュまで、再現に足る情報を望んでいます[2]。ただし、このガイド自体には速度の数値は載っていません[2]。
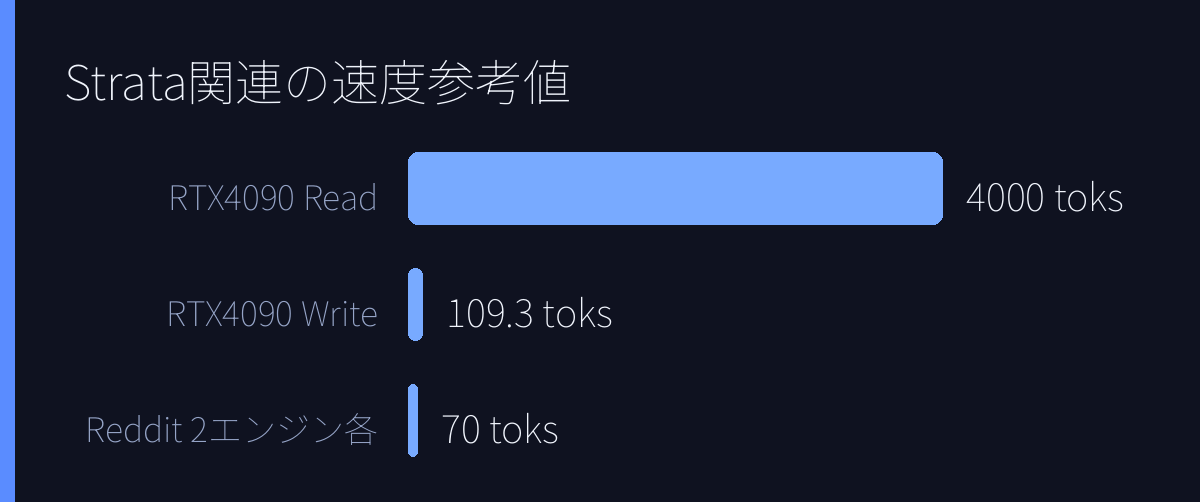
Strataのコスト計算ページでは、RTX 4090 24GBの単一カード構成が示されています[3]。Read 4,000 tok/s、Write 109.3 tok/s、消費電力550Wです[3]。Read/Writeは、prefillとdecodeの速度を分けた数値と思われます。1日の出力は75.8と表示されています[3]。100万トークンあたり0.056ドル、電気代は1日1.98ドルとあります[3]。節約額が1日11.67ドルなら、回収期間は433日です[3]。ページには29のGPUが並び、デュアルカードにはケースの余裕と電源が必要と注意書きがあります[3]。計算式は、1日の出力は速度×稼働時間、電気代はワット×時間×電気料金、1日コストは電気代とハードの償却、回収期間は本体価格÷1日の節約額です[3]。
こうした数字は、RTX 5090やStrix Haloなど消費者向けGPUの比較にもつながっています[7]。Strataという名前は、drew-worden氏の自作LLM「strata」にも使われています[6]。推論エンジンではなく、モデルそのもののようです[6]。検索ではSTraTAというfew-shot(少量の例で学習する手法)の自己訓練論文や、嵐を細かく再現する大気AIシミュレーションの論文も出ます[8]。同じ語でも対象が違うため、読み分けが必要です。
ただし、数値をそのまま信じると危うい面もあります。コミュニティガイドは、GPUやメモリ、モデルの圧縮方法、コンテキスト長、キャッシュ設定など、再現に必要な情報を細かく求めています[2]。実測値と推定値を分けることも求められています[2]。条件が違えば、同じ「Strata」でも速度は大きく変わるでしょう。コストページも、電気代や稼働時間、ハードの寿命、APIとの比較で回収日数が決まります[3]。RTX 4090の433日という数字は、あくまでその計算式での結果です[3]。Redditの70tpsも、個人の環境と使い方による実感でしょう[1]。
それでも、Strataの話題は「動くか」から「どう測るか」へ進んだように見えます。12GB VRAMで125B級MoEを動かすという主張は、まだ注目に値します[4]。Flash-Nextのようなモデル名も、ベンチ報告で出てきます[2]。今後は、RTX 4090やRTX 5090での実測、prefillとdecodeの速度、電力と回収期間が、コミュニティの共通言語になっていくようです[2][3][7]。ローカルAIを趣味で回す人と、業務で大量のトークンを消費する人の距離も、数字で語られそうです[1][3]。
引用ソース
- Reddit Reddit r/LocalLLaMA: I am a King, but local 😂 — https://www.reddit.com/r/LocalLLaMA/comments/1xgy5ic/i_am_a_king_but_local/
I am a King, but local 😂
- Web記事 記事全文: Llm-Strata/docs/COMMUNITY_BENCHMARKS.md at main – GitHub — https://github.com/mabaro/Llm-Strata/blob/main/docs/COMMUNITY_BENCHMARKS.md
Share measurements from your own hardware so other users can judge how Strata might run on a similar machine. This guide suggests a report format and a pull request workflow; a single model, GPU, or context length is eno
- Web記事 記事全文: Local LLM hardware benchmarks and cost · Strata — https://www.stratat.com/en/benchmarks
Hardware benchmarks
Pick a GPU and see what it costs to run — and how long until it pays for itself.
How you’ll use it
29 GPUs · Dual cards need case room and enough power supply.
Selected hardware
RTX 4090
24 GB · singl - Web記事 Web検索: Strata LLM – Run 125B+ MoE Models on 12GB VRAM Consumer GPUs (Docs & Setup) — https://stratallm.org/
Strata LLM – Run 125B+ MoE Models on 12GB VRAM Consumer GPUs (Docs & Setup)
- Web記事 Web検索: Strata (Niko1221): a Local Inference Engine That Runs a 125B Model on a … — https://cldnavi.com/en/blog/strata-local-llm-engine-2026/
Strata (Niko1221): a Local Inference Engine That Runs a 125B Model on a …
- Web記事 Web検索: GitHub – drew-worden/strata: A custom-built large language model, built … — https://github.com/drew-worden/strata
GitHub – drew-worden/strata: A custom-built large language model, built …
- Web記事 Web検索: LLM Benchmark v4: consumer-grade open source on RTX 5090 or Strix Halo … — https://akitaonrails.com/en/2026/10/22/llm-benchmark-v4-consumer-open-source-rtx5090-strix-halo-strata/
LLM Benchmark v4: consumer-grade open source on RTX 5090 or Strix Halo …
- Web記事 Web検索: STraTA: Self-Training with Task Augmentation for Better Few-shot Learning — https://arxiv.org/html/2109.06270v2
STraTA: Self-Training with Task Augmentation for Better Few-shot Learning
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS