ローカルAIのllama.cppで、モデル切替や再起動後に推論が遅くなる原因がKVキャッシュの再計算にあると話題です。スリープで2秒以内の切替、セッションの保存・復元が注目されています。キャッシュ再利用の仕組みと注意点、ベンチマークの使い方もわかります。
ローカルAIのllama.cppで、モデル切替や再起動後に推論が遅くなる原因がKVキャッシュの再計算にあると話題です。スリープで2秒以内の切替、セッションの保存・復元が注目されています。キャッシュ再利用の仕組みと注意点、ベンチマークの使い方もわかります。
Qwen3.8系の公開とローカル推論が同時に進み、Strataとllama.cppの速度差や27Bの評価と不満が話題です。API版の拡充やAIバブル関連語も加わり、実運用では速さと安定を自分の構成で測る必要があり、分かれ目が見えます。
GufoはStrix Halo専用推論エンジンですが、二台構成のGufo-TPが話題です。128GiBに収まらないQ8モデルや長い文脈を、ThunderboltやRDMAで分断して動かす狙いです。単体速度から二台連携へ、最新動向を追います。
Strata/Basaltの最適化で、Qwen3.8 Flash Nextの125B MoEがRTX 5080で動くという報告です。prefill(一括処理)約5500TPS、decode(生成)ピーク275TPSとされ、実用性が一段上がりました。RAMや量子化の制約も扱います。
llama.cppのCUDA PRでMoEゲートとup、GLUを融合し、DGX Sparkで17.2%のspeedupが出ました。Fused-MoEはdecode時のGPU同期を64回から1回に減らします。ローカル推論が速くなったことがわかり、ai関連で注目されました。
Strata追跡では、Redditの実使用感と公式ベンチ・コスト計算が注目されています。RTX 4090でWrite 109.3 tok/s、Read 4000 tok/s、回収433日など具体的な数字が並び、計測ガイドも整備されました。
改造RTX 3080の追跡記事。4枚構成の実測ではQ8+MTPでdecode約95 tok/s、8×RTX 5060 Ti構成の2.4倍に達しました。さらに計算制限を解除する新modでprefill約20%向上、decodeは不変という結果も報告されています。
NVIDIA RTX 30/40シリーズの人工的な性能制限を解除するオープンソースツールが話題です。LLM推論のprefillが最大2倍、実使用でも最大60%の向上が報告されています。一方で中古GPU価格が数時間で15〜20%上昇し、NVIDIAの市場戦略との攻防が注目されます。
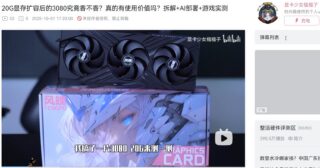
NVIDIA未発売のRTX 3080 20GB改造カードが中国で登場し、AI向け性能制限を解除するツールでの動作も確認されました。2枚構成の実測でprefillが+20%改善、decodeは0%。規格外カードとコミュニティ製アンロックの組み合わせが注目されています。
BaiduがKVキャッシュを最大4分の1に圧縮する新手法VHAを発表。GQA比でベンチマーク+0.05〜+0.81%を維持しつつキャッシュを削減し、学習とprefillの計算量も7.9%減。推論時は既存のGQA最適化をそのまま使える点が注目です。
2026.11.13
AIチャットは性能差より監視と推論設計が分かれ目
2026.11.12
AIエージェントは業務の入口で試されている
2026.11.12
Fireworks AIが2回目の侵害を通知、推論基盤の被害が拡大
RECENT COMMENTS