142Bの総量で、動かすのは14Bだけ。dots.llm1は、その設計がはっきり見えるAIモデルです。前回の追跡では、ローカル推論の裏側にあるバックエンド選択を見ました。今回は、モデル本体の構成と学習データの作り方を追います。公式リポジトリには、ベースモデルと指示調整済みモデルが置かれています[1]。Hugging Faceや論文へのリンクも並び、実装と研究の両方を想定した公開です[1]。単なるモデルカードではなく、学習の道筋が見える形です。
dots.llm1は、2025年6月6日に公開されたMoEモデルです。MoEとは、全部のパラメータを毎回使うのではなく、入力ごとに一部だけ動かす仕組みです。総パラメータは142B、推論時にアクティブになるのは14Bと説明されています[1]。前学習では、高品質なコーパスを使い、合成データを入れていません。公式の説明では、最先端モデルと同等の性能を出すと書かれています。ただし、その根拠となる数値はこの素材には出ていません[1]。レポートも用意され、dots.llm1コレクションとしてチェックポイントを探せます[1]。
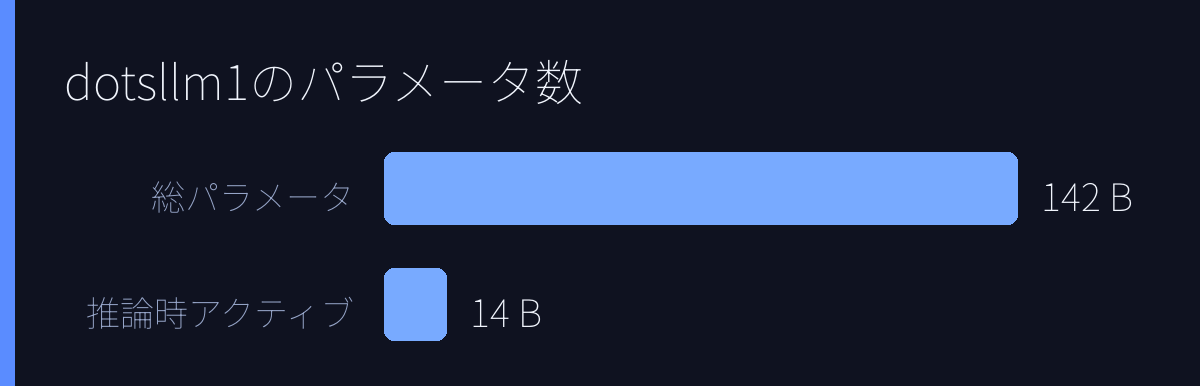
構造の数字も出ています。層数は62、注意ヘッド数は32です。MoEは128のルーティング専門家から6つを選び、共有専門家2つを足す構成です[1]。これは、細かく役割を分けて計算を軽くする工夫です。注意層にはQK-Normという、学習を安定させるための正規化も入っています[1]。対応言語は英語と中国語、コンテキスト長は32,768トークンです。32,768トークンは、長い文章を一度に扱うための上限です。日本語は素材にありません。ライセンスはMITです[1]。
注目したいのは、完成モデルだけではない点です。dots.llm1は、学習過程の中間チェックポイントを公開しています。これにより、大規模言語モデルがどの段階で何を学んだかを見やすくなります[1]。訓練段階は前学習とSFTです。SFTとは、指示に従う形に調整する学習です。データ処理も3段階の枠組みで説明されています。高品質で多様なデータを作るための工夫が、モデルの裏側に見えます[1]。研究を促すための公開です。
ローカル推論の目線では、アクティブ14Bは魅力的です。推論の計算量は、総142Bより14Bに近い形で抑えられる可能性があります。MoEでは、毎回使う専門家が変わります。だから計算は軽くできます。一方で、総142Bの重みをどこかに置いておく必要があります。この置き方が、ローカル推論の難しさになりそうです。アクティブ14Bは、推論の計算コストを下げる方向に働きます。総142Bは、メモリやストレージの負担になりそうです[1]。推論エンジンや量子化の指定は素材にありません。総142BをGPUに載せるか、CPUに分担するかは確認できません。
2026年のローカルLLMベンチマーク記事も検索されますが、このモデルの実測値は含まれていません[2]。ここで注意したいのは、性能の言い方がまだ粗いことです。Qwen2.5-72Bと同等という説明はありますが、具体的なベンチマーク名やスコアは素材にありません。ベンチマークの条件も不明です。合成データを使わない点も、データ処理の質に強く依存します。前学習で合成データを入れない代わりに、細かく整えた実データが必要になります。つまり、モデルの設計とデータ処理はセットで見るべきです[1]。前学習とSFTの役割分担も重要です。
インフラの話も公開資料の冒頭に出ますが、素材では途中で切れています[1]。そのため、分散学習や推論最適化の具体的な中身は、この記事では書けません。ここは正直に置いておきます。インフラの続きは、推論エンジンやGPU構成に直結します。代わりにわかるのは、データ処理とチェックポイント公開が前面に出ている点です。dots.llm1は、完成後のスコアより、作る過程を見せる方向に寄っています[1]。
派手な数値より、学習過程の公開と構成の透明性。dots.llm1の価値は、そこにあるようです。MoEの細かさ、14Bアクティブ、142B総量という数字は、ローカル推論の設計を考えると興味深いです。一方で、実際の速度とメモリは測っていません。今後の追跡では、GPU構成や量子化の有無、prefill(プロンプト全体を一括処理する段階)とdecode(トークンを1つずつ生成する段階)の速度差を素材として確認したいです。数値が揃えば、MoEの利き方も見えます。読者が試すなら、まずメモリと速度の実測です。
引用ソース
- Web記事 記事全文: GitHub – studio-dots-ai/dots.llm1: The official repository of the dots … — https://github.com/studio-dots-ai/dots.llm1
🤗 Hugging Face | 📑 Paper
🖥️ Demo | 💬 WeChat (微信) | 📕 rednote | 𝕏 X
Visit our Hugging Face (click links above), search checkpoints with names starting with dots.llm1 or visit the dots1 collection - Web記事 Web検索: Benchmarking Local LLMs in 2026: Speed, Quality, Resource Usage — https://dasroot.net/posts/2026/04/benchmarking-local-llms-speed-quality-resource-usage/
Benchmarking Local LLMs in 2026: Speed, Quality, Resource Usage
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS