Xでは「AI暴走」[3]や「AIバブル崩壊」がトレンドワードになっています。その一方で、local AIの界隈では、Flash推論というより、StrataとQwenの組み合わせが試されています[1]。以前取り上げたFlash 125Bを12GB GPUで動かす量子化(重みを圧縮してメモリを節約する仕組み)では、大きなモデルをローカルで動かす方向性が示されました。今回は、Qwenの小さいモデルから大きいモデルまで並べた推論速度の比較が新しい話題です。
Redditのr/LocalLLaMAでは、RTX 3060 12GB、Ryzen 5 7600X、32GB RAM、NVIDIA CUDA環境の1台で、QwenのモデルファイルをStrata(RustingStrata)とllama.cppで同じファイルのまま読み込ませました[1]。ブラウザやDiscordを開いたまま、調整なしの素の比較で2回の平均を取ったところ、READMEより低い値でした。prefill(プロンプト全体を一括処理する段階)は、2Bで3859対6080、4Bで1433対2482と、llama.cppが速い結果でした[1]。
ところが、モデルがVRAM容量を超えるとStrataが有利になります。decode(トークンを1つずつ生成する段階)は、35B-A3Bで71.5対39.6、80B-A3Bで63.7対33.3でした[1]。177Bと表記されたFlash-Nextでは、63GBのファイルでprefillが305対193、decodeが21.3対18.1です[1]。12GBのGPUで大きなMoE(一部の専門家だけ使うモデル)を動かすとき、Strataは約1.5倍から約2倍伸びたと報告されています[1]。
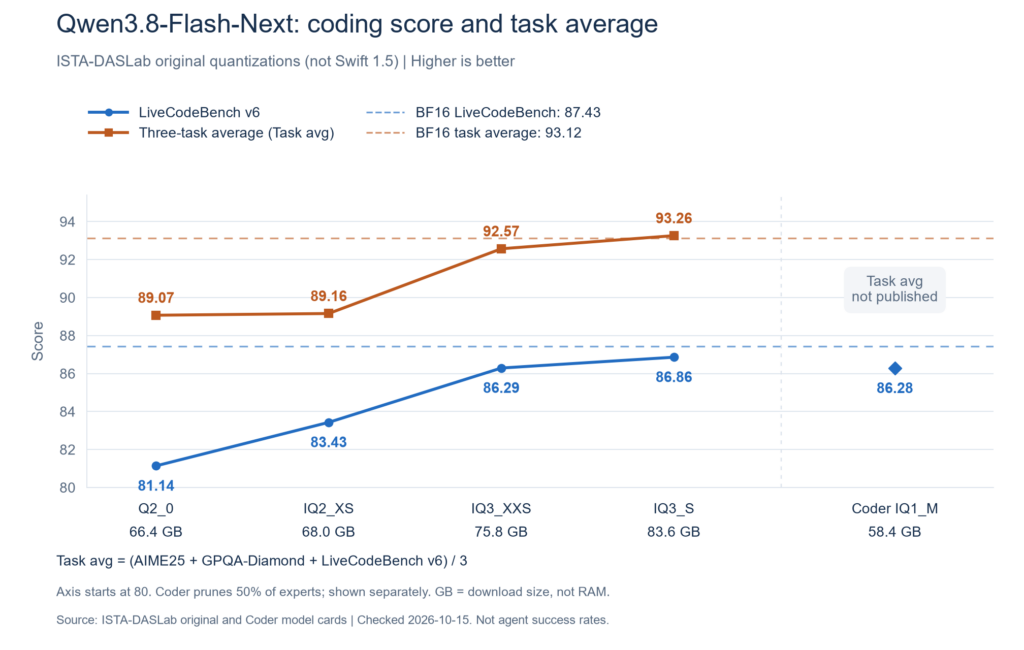
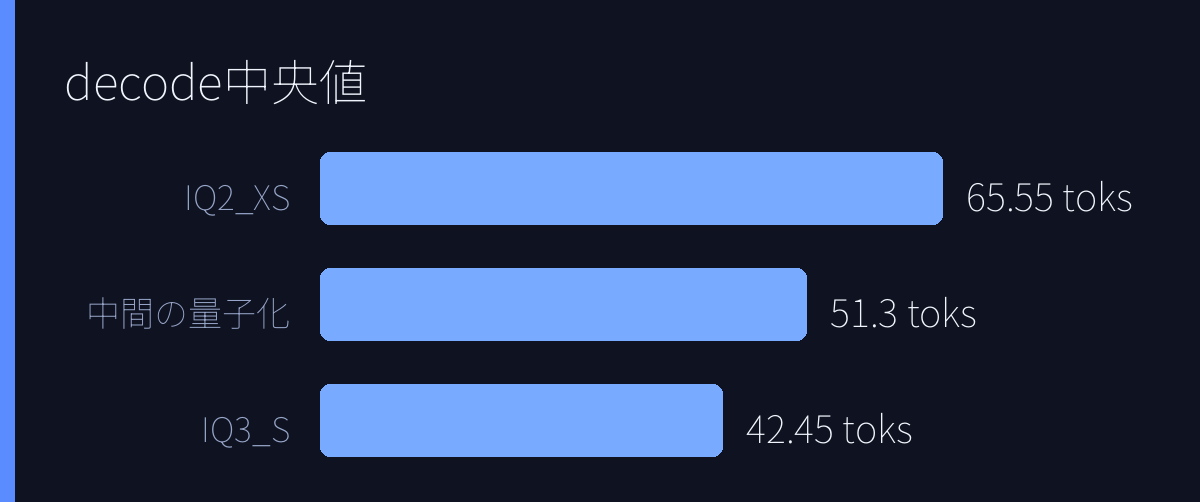
別の角度からは、RTX 5060 Ti 16GB、i7-11700、64GB RAMの環境で、軽い量子化(IQ2_XS)、中間の量子化、重い量子化(IQ3_S)の3段階について、decodeの中央値も報告されています[2][5]。32Kのprefillと4Kのdecodeを9回ずつ測り、4Kトークンを読んだ後の生成速度は65.55、51.30、42.45 tok/sです[2][5]。prefillとdecode、LiveCodeBench(コード生成の試験)、ダウンロードサイズ、RAM使用量も比較されています[2][5]。品質スコアは原版と量子化版を分けています[2]。
公式ドキュメントでは、Qwen3.8-Flash-Nextの125B MoEが主対象で、RTX 4070で20-35 tok/sと書かれています[5]。StrataはMoE向けに作られており、MLA(注意機構の一種)という仕組みでKVキャッシュ(生成時の記憶データ)を70%減らすとされています[5]。VRAMとRAMの配分を指定して動かす前提も示されており、12GB VRAMのコンシューマー向けGPUで125B以上を動かすという話です[5]。GitHubやセットアップ記事も出ており、hackerという語が似合う細かな設定が話題になりそうです[5]。
ただし、数字をそのまま信じると危うい面もあります。GitHubのコミュニティベンチマークには、RTX 5090だけでなく、2x TITAN RTX、AMD MI50、Intel Arc Pro B60、Quadro RTX 4000、V100などの報告が並びます[4]。GPU2枚に層を分割する報告や、131,072トークンのコンテキストで測る報告もあります[4]。同じモデルでも、エンジンバージョン、KVの型、ドライバ、接続規格、RAMの構成で結果が変わります[2][4]。軽い量子化はSwift 1.5、重い量子化は原版Qwenで、モデル変種も違います[2]。2x TITAN RTXでは、NVLink(GPU間の高速接続)があってもエンジンがNVLinkを使わないという注意書きや、実測と推定を分けるルールもあります[4]。
つまり、StrataとQwenの話題は「どのモデルでも速い」ではなく、VRAMの壁を越えたときに差が出る話です。小さいモデルならllama.cpp、大きいMoEならStrata、という使い分けが見えてきます[1]。今回は速度の分岐点と量子化の種類別の差が中心です。
引用ソース
- Reddit Reddit r/LocalLLaMA: Strata for all Qwen models from little to big — https://www.reddit.com/r/LocalLLaMA/comments/1xottw2/strata_for_all_qwen_models_from_little_to_big/
Strata for all Qwen models from little to big
- Web記事 記事全文: Strata Model Benchmarks: IQ2_XS, IQ3_XXS and IQ3_S Speed, Quality and … — https://eth-lab.com/en/2026/10/strata-model-benchmarks-en/
On an i7-11700 with an RTX 5060 Ti 16GB and 64 GB RAM, nine-run Decode medians were 65.55, 51.30 and 42.45 tokens/s for IQ2_XS, IQ3_XXS and IQ3_S respectively. This article compares all three across Prefill/Decode, indiv
- X Xトレンド: AI暴走 — https://trends24.in/japan/
AI暴走
- Web記事 記事全文: Strata-Qwen/docs/COMMUNITY_BENCHMARKS.md at main – GitHub — https://github.com/InnateC/Strata-Qwen/blob/main/docs/COMMUNITY_BENCHMARKS.md
Share measurements from your own hardware so other users can judge how Strata might run on a similar machine. This guide suggests a report format and a pull request workflow; a single model, GPU, or context length is eno
- Web記事 記事全文: Strata 模型比較與實測成績:IQ2_XS、IQ3_XXS、IQ3_S 的速度、分數與記憶體 – Ethan Lab — https://eth-lab.com/2026/10/strata-model-benchmarks/
在 i7-11700、RTX 5060 Ti 16GB 與 64 GB RAM 上,IQ2_XS、IQ3_XXS、IQ3_S 的九次實測 Decode 中位數分別為 65.55、51.30、42.45 tokens/s。本文完整比較三款模型的 Prefill/Decode、逐次結果、作者速度與換算耗時、LiveCodeBench 分數、下載大小,以及 RAM 用量和剩餘容量。IQ2_XS 測速使用 Swift 1.5,兩款 IQ3 使用
- Web記事 記事全文: Supported Models & Quantization – Strata LLM (Qwen 125B, DeepSeek MoE … — https://stratallm.org/docs/models/
Qwen3.8-Flash-Next (125B MoE)
The primary model Strata was designed for. Rivals Claude 3.5 Sonnet on programming benchmarks while generating at 20-35 tok/s on an RTX 4070.
strata-cli run –model qwen3.8-125b-q4 –vram 11 - Web記事 Web検索: Strata LLM – Run 125B+ MoE Models on 12GB VRAM Consumer GPUs (Docs & Setup) — https://stratallm.org/
Strata LLM – Run 125B+ MoE Models on 12GB VRAM Consumer GPUs (Docs & Setup)
- Web記事 Web検索: GitHub – Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware … — https://github.com/Niko1221/Strata
GitHub – Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS