📌 エグゼクティブサマリー
BaiduがKVキャッシュを最大4分の1に圧縮する新手法VHAを発表。GQA比でベンチマーク+0.05〜+0.81%を維持しつつキャッシュを削減し、学習とprefillの計算量も7.9%減。推論時は既存のGQA最適化をそのまま使える点が注目です。
LLMに長い文章を扱わせるとき、メモリを一番圧迫するのが「KVキャッシュ」です。過去のトークンの情報を推論中ずっとメモリに保持し、使い回すためのデータです。文脈が長いほど膨らむため、長文脈モデルでは大きな負担になります。Baiduの研究チームは、このKVキャッシュを品質をほとんど落とさずに最大4分の1へ減らす手法「Virtual Head Attention(VHA)」を発表しました[3]。
発表を受けて、Redditのr/LocalLLaMAでもすぐに取り上げられました[1]。論文はNeurIPS 2026のものです。Xibo Ding氏やGuoxia Wang氏らBaiduの研究者による共同研究です[3]。注目されるのは、KVキャッシュをめぐる「不可能な三角形」です。キャッシュの容量、学習とprefill(プロンプト全体を一括処理する段階)の計算量、そしてモデル品質。この3つを同時に改善するのは難しい、という問題です[1]。
従来の手法は、どこかで妥協が必要でした。標準的なGQA(複数のクエリが同じKVデータを共有してキャッシュを節約する仕組み)は品質が高い一方、キャッシュの負荷が大きくなります。キャッシュを圧縮するMLAは品質が落ちます。MFAはキャッシュを小さくできる反面、学習とprefillの計算量が大幅に増えます[1]。
VHAの仕組みは、2つの軽い線形演算(行列のかけ算だけでできる処理)の追加です。ひとつはQ Premix。KVグループ内のクエリにほぼ恒等の変換をかけ、半分に減らした物理的なクエリヘッド(アテンションを分担する計算単位)から、「仮想ヘッド」の多様性を取り戻します。もうひとつはLinear Postmix。低ランクの残差構造で、ヘッド間の特徴を融合します[1][3]。
ポイントは推論時の扱いです。2つの処理に非線形な操作が含まれないため、推論時にはクエリと出力の投影に折りたためます。結果として、モデルは標準的なGQA-2と同じ形になります。推論の仕組みは何も変えずに済みます。既存のGQA向け推論最適化をそのまま再利用できる、というわけです[1][3]。
数値も示されています。4Kコンテキストで50Bトークンを使った4つの学習規模の比較では、GQA比でベンチマークが+0.05〜+0.81%向上しました。KVキャッシュはdense(MoEではない通常の構造)のモデルでGQA-8の4分の1、MoE規模ではGQA-4の2分の1への削減です。学習とprefillの計算量(FLOPs)は7.9%減りました[3]。
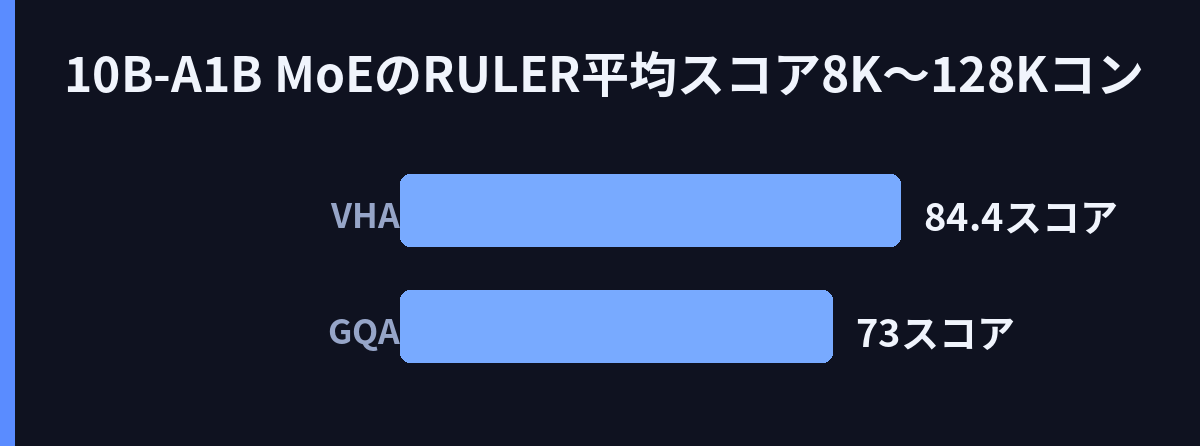
より大きな規模での結果もあります。8Kコンテキストで500Bトークンを学習した30B-A3BのMoEでは、12のベンチマークでMLA比+0.70%、GQA-4比+2.60%を記録しました[3]。また10B-A1BのMoEでは、8K〜128KコンテキストにわたるRULER(長い文脈の理解力を測るベンチマーク)の平均スコアが84.4。GQAの73.0を大きく上回っています。長い文脈でもGQAより劣化しにくいことを示す数値です[3]。
一方で、小規模な学習では改善幅が+0.05%にとどまる場面もあります。効果の大きさは規模によって変わるようです[3]。また、KVキャッシュ対策はVHAだけではありません。不要な情報を捨てるeviction、数値の精度を落として圧縮する量子化、行列を分解して圧縮する低ランク手法など、アプローチは多岐にわたります。海外メディアはこれらを10の技術として整理しています[4]。KVキャッシュをページ単位で管理し、メモリの断片化を減らすPagedAttentionも知られています[4]。arXivには最適化戦略を整理した論文もあり[2]、2026年版の総合ガイドも公開されています[4]。
VHAの要点は、キャッシュ削減と品質維持を両立したまま、推論環境をほとんど変更せずに済む点です。既存のGQA最適化がそのまま使えるため、導入の負担は小さそうです[1]。長いコンテキストを低コストで扱う選択肢が、また1つ増えたと言えそうです。
RECENT COMMENTS