763Bの巨大モデルを、重み1.75ビットで動かす——そんな挑戦的な量子化が話題です。オーストリアの研究機関ISTA-DASLabが、DeepSeek-V4.1-Flash-1017の量子化版「GSQ-RCO」を公開しました[1]。量子化とは、モデルの重みを圧縮してメモリを節約する仕組みです。
対象モデルは、1層に384個のエキスパート(専門に特化した小さなネットワーク)を持ち、1トークンあたり6個だけを稼働させるMoEです。コンテキストは100万トークンに及びます[2]。全体は763.2Bで、transformer本体が551.9B、Engramと呼ばれる2つの参照テーブルが196.6Bです。以前この連載で取り上げた「552B」という数値は、この本体部分にほぼ一致します[2]。

注目はGSQ-RCOという手法の中身です。従来の量子化は、すべてのテンソル(重みのまとまり)に同じ型を一律に適用していました。GSQ-RCOは各テンソルが精度にどれだけ敏感かを勾配ベースの探索で評価し、サイズの予算内で精度を配分する「非均一量子化」です[2]。GSQが低ビットのスカラー量子化を担当し、RCOがテンソルごとの型決めを担います[2]。
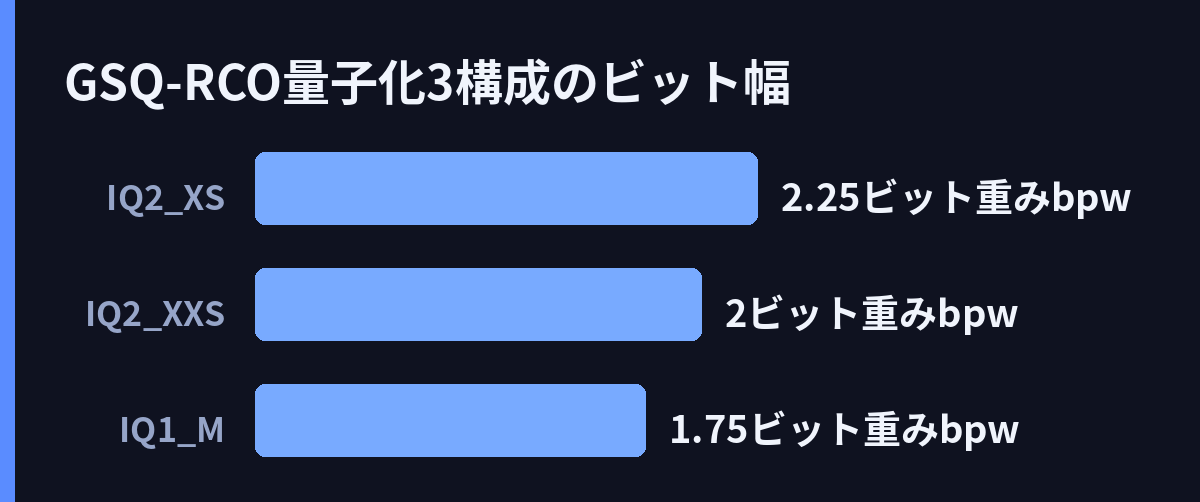
公開されたのは3構成で、もっとも強く圧縮したIQ1_Mでは重み1つあたり1.75ビット。ほかに2.00ビットと2.25ビットの構成があります[2]。エキスパートがパラメータの大半を占めるため、探索の自由度もそこに集中します。ただし割り当ては層ごとで、エキスパート単位ではありません(GGUFでは表現できないためです)。ファイルはGGUF(ローカルLLMで標準的なモデルファイル形式)で、本体は4つのシャードに分割されます。Engramテーブルは4.50ビットの別ファイルに切り出され、複数構成を試しても1回のダウンロードで済みます[2]。そしてモデルカードは「実行環境Strataを使えば、12GB VRAMのGPU1枚で動く」と説明しています[2]。
ただし、この動作環境には留保がついています。Redditの投稿者は、llama.cppでは元アーキテクチャの対応がまだマージされておらず動かないと指摘しました[1]。Strata対応についても、本家StrataはQwen3.8-Flash-Next専用のはずなので、XolotlやMayaといったStrata系フォークのことだろうという見立てです[1]。
別の動きもあります。GitHubのU4ARプロジェクトは、推論エンジンSGLang向けのカスタムランタイムで、226.29GBのパック済みアーティファクトを構築しました。H100 NVL 1枚にCPUへのエキスパートオフロードを組み合わせ、8,000個のエキスパートをGPUに、7,360個をCPU RAMに置いています[3]。検証でのピークはVRAM 97.04GB、RAM 147.01GBで、CUDA OOM(メモリ不足エラー)はゼロでした[3]。速度を測ったところ、3プロンプトのリプレイでは5.82トークン/秒でした(prefill=プロンプト全体を一括処理する段階を含む集計)。ARC(推論力を試すベンチマーク)実行の稼働区間では9.01トークン/秒です[3]。ARCのプロンプトは最大57,145トークンまで成功しましたが、256K全体の推論はまだストレステストされていません[3]。
しかし、品質のほうは簡単ではありません。ARCの標準ゲーム2回、各24呼び出しで解けたレベルはゼロ。追加の2ゲーム試行でもゼロでした[3]。さらにこのプロジェクトは、活性(中間出力)の統計を取るimatrixを収集せず、重要度ベクトルを定数1のまま直接量子化しています[3]。算数・論理・グリッド変換などの確認テストは通過したものの、1,000呼び出しのタイミング試行は記事作成時点でまだ実行中でした[3]。同じ時期にUnslothも、ローカルの128GB環境向けに250GBの1ビット動的GGUFを公開しています[4]。低ビット化の競争は激しいものの、品質をどこまで保てるかはまだ検証途上のようです。
巨大MoEのローカル推論では、「どこに精度を残し、どこを削るか」という配分の巧拙が性能を左右します。GSQ-RCOはその方向性を明確に示しました。llama.cpp対応のマージやARCでの検証が進めば、12GB GPUという身近な環境での実力がはっきりするはずです。
引用ソース
- Reddit Reddit r/LocalLLaMA: ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO — https://www.reddit.com/r/LocalLLaMA/comments/1xdtk7m/istadaslabdeepseekv41flash1017gsqrco/
ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO
- Web記事 記事全文: ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF · Hugging Face — https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF
Non-uniform GGUF quantizations of a 763B-parameter, 384-expert MoE, produced with GSQ and RCO.
This repository provides GGUF quantizations of DeepSeek-V4.1-Flash-1017 at three sizes: IQ1_M (1.75 bits per weight), IQ2_XXS - Web記事 記事全文: deepseek-v41-flash-quantization/README.md at main – GitHub — https://github.com/U4AR/deepseek-v41-flash-quantization/blob/main/README.md
Reproducible conversion and a custom SGLang runtime for a 226.29 GB packed DeepSeek V4.1 Flash artifact. The measured deployment uses one H100 NVL with CPU expert offload and both complete Engram tables in host RAM.
This - Web記事 Web検索: Unsloth ships DeepSeek-V4.1-Flash-1017 dynamic GGUFs: a 250 GB 1-bit … — https://aicoder.com/news/news-20261020-unsloth-deepseek-v4-1-flash-1017-1-bit-gguf-local-128gb
Unsloth ships DeepSeek-V4.1-Flash-1017 dynamic GGUFs: a 250 GB 1-bit …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS