763Bの巨大モデルが12GBのGPU1枚で動く――話題の量子化版DeepSeek-V4.1-Flash-1017で、その圧縮の中身が明らかになりました。ISTA-DASLabがHugging Faceで公開したGGUF(重みを圧縮して保存するモデルファイル形式)は、全体に同じ圧縮をかける従来方式と違い、部分ごとに精度を変える「非一様量子化」です[1][2]。

鍵となるのは2つの手法です。1つ目のGSQは、各テンソル(重みのまとまり)を低ビットでも正確に量子化する手法です。GitHubには「Gumbel-Softmaxを使った事後量子化」として公開されています[2][4]。事後量子化は、学習済みの重みに後から圧縮をかける方式です。2つ目のRCOは、サイズの予算内で、どのテンソルにどの精度を割り当てるかを決めます。割り当ては勾配ベースの探索で決まります。テンソルごとの感度(精度を下げたときの影響の大きさ)に応じて精度が配分される仕組みです[2]。両手法はオーストリアの研究所ISTA内のDASLabで開発されました[2]。
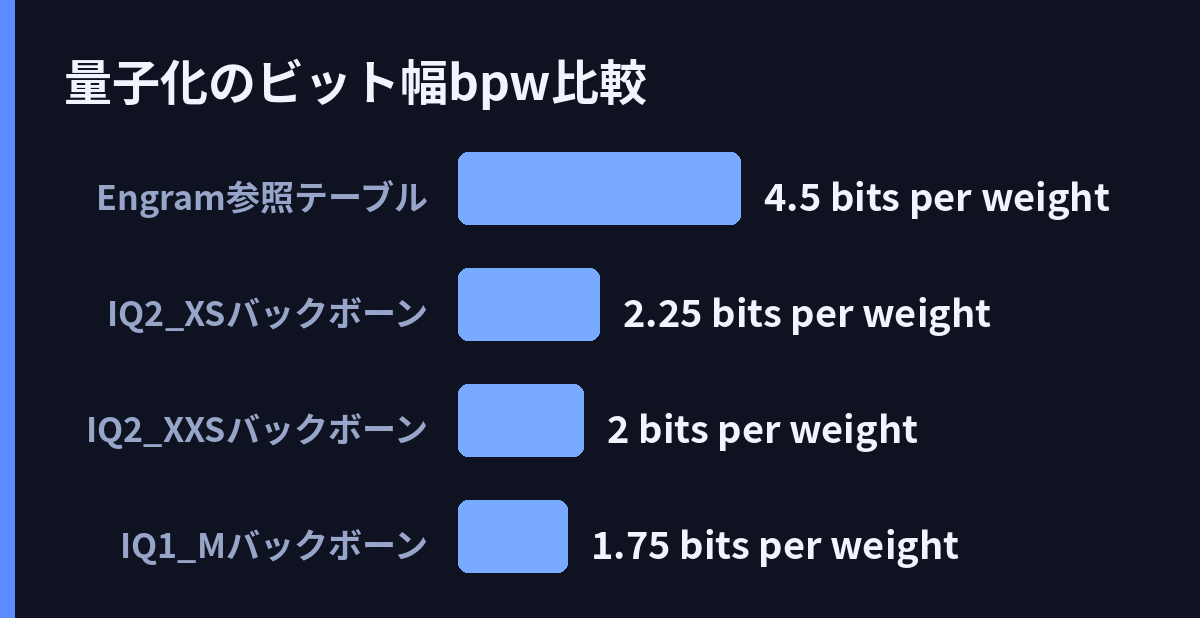
用意されたのは3サイズです。IQ1_Mが1.75bpw、IQ2_XXSが2.00bpw、IQ2_XSが2.25bpwです。bpwは1つの重みを何ビットで表すかの目安で、数字が小さいほど圧縮率が高くなります[2]。
対象モデルは763.2BパラメータのMoEです。1層に384個のエキスパート(専門に特化した小さなネットワーク)を持ち、1トークンあたり6個だけを稼働させます。コンテキストは100万トークンに及びます[2]。DeepSeek自身も「より賢く、速く、効率的」とうたうモデルです[8]。エキスパートがパラメータの大半を占めるため、探索の自由度の大半もそこに使われます。割り当ては層ごとで、エキスパート単位はGGUFでは表現できないとのことです[2]。
ファイル構成も特徴的です。transformer本体の重み(バックボーン)は551.9Bパラメータで、4分割のGGUFになります。探索が制御するのは、このバックボーンのbpwです[2]。一方、Engramと呼ばれる2つの参照テーブル(196.6Bパラメータ)は別ファイルです。こちらは4.50bpwで、バックボーンより高精度に保たれています[2]。Engramファイルは全ビルドで同一のため、複数サイズを試すときも1回だけダウンロードすれば済みます[2]。モデルカードは、Strataを使えば12GB VRAMのGPU1枚で動くと説明しています[2]。
しかし、動かせる環境にはくせがあります。Redditの投稿によると、llama.cppでは動きません。元のアーキテクチャ対応がまだマージされていないためで、進行中のPR(修正の取り込み要求)が2つ示されています[1]。また、モデルカードはStrata対応に言及します。ただ投稿者は「オリジナルのStrataはQwen3.8-Flash-Nextしか対応していないはずだ」と指摘します。おそらくStrataベースのフォーク(XolotlかMaya)を指しているのだろうという見方です[1]。現時点では、動作環境の選択肢は限られそうです。
品質への期待と疑問も同居しています。Hugging Faceの議論では、開発側が「IQ2_XXSはほぼFP8(8ビット浮動小数点)と同等の品質」と主張している点が話題になりました。投稿者は「700B超の巨大モデルはもともと低ビット量子化に強い」と指摘します。その上で、主張を信頼するかは別問題と注意を促しています[3]。同じ投稿では、Qwen3.8-flash-nextのRCO量子化が高評価です。コーディングタスクではフロンティアモデルに匹敵することもあるといいます。検索やRAG(外部情報を参照させる仕組み)を組み合わせた推論も賢いという評価です[3]。ハードウェアの増強が必要なだけに、「DeepSeek版との差で経済的正当性を確かめたい」との声も上がっています[3]。検証方法としては、5ドルほどの費用でホスト版と同じプロンプトを試し、差を体感するという提案もあります[3]。

巨大MoEの圧縮では、エキスパートに予算を集中させ、層ごとに精度を振り分けるのが有効な方向のようです。同ラボはMoEのデータ対応圧縮のコードも公開しています[6]。量子化版のローカル運用を解説する記事や、モデル概要のまとめも出てきています[5][7]。残る課題は、対応エンジンの整備とIQ2_XXS=FP8の主張の実証です。ここが埋まれば、763Bクラスのローカル推論がさらに現実味を帯びてきそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO — https://www.reddit.com/r/LocalLLaMA/comments/1xdtk7m/istadaslabdeepseekv41flash1017gsqrco/
ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO
- Web記事 記事全文: ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF · Hugging Face — https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF
Non-uniform GGUF quantizations of a 763B-parameter, 384-expert MoE, produced with GSQ and RCO.
This repository provides GGUF quantizations of DeepSeek-V4.1-Flash-1017 at three sizes: IQ1_M (1.75 bits per weight), IQ2_XXS - Web記事 記事全文: ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF – Hugging Face — https://huggingface.co/ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF/discussions/4
IQ3_S Qwen3.8-flash-next RCO GSK quant is just fabulous, at times can match frontier models at many coding task and is generally very smart for reasoning with internet+RAG grounding… Qs is how does the deepseek v4.1 10
- Web記事 Web検索: GitHub – IST-DASLab/GSQ: Gumbel-Softmax post-training quantization for … — https://github.com/IST-DASLab/GSQ/
GitHub – IST-DASLab/GSQ: Gumbel-Softmax post-training quantization for …
- Web記事 Web検索: DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF: Text-to-Text model — overview … — https://www.aimodels.fyi/models/huggingFace/deepseek-v4.1-flash-1017-gsq-rco-gguf-ista-daslab
DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF: Text-to-Text model — overview …
- Web記事 Web検索: GitHub – IST-DASLab/MoE-Quant: Code for data-aware compression of … — https://github.com/IST-DASLab/MoE-Quant
GitHub – IST-DASLab/MoE-Quant: Code for data-aware compression of …
- Web記事 Web検索: Deploying the Quantized DeepSeek‑V4‑Flash Locally: Performance … — https://www.besthub.dev/articles/deploying-the-quantized-deepseek-v4-flash-locally-performance-benchmarks-and-tips-b141eafc4a29
Deploying the Quantized DeepSeek‑V4‑Flash Locally: Performance …
- Web記事 Web検索: Introducing DeepSeek-V4.1-Flash: smarter, faster, more efficient. — https://www.deepseek.com/en/news/deepseek-v4-1-flash/
Introducing DeepSeek-V4.1-Flash: smarter, faster, more efficient.
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS