AIを動かすのに、2.6MBのファイル1つしか要らない——そんな投稿がHacker Newsに上がりました[1]。タイトルは「1つのJVM JARで、依存なしのローカル推論、llama.cppより速い」。JVM(Java仮想マシン)はJavaプログラムを動かす土台のソフトです。その上でAI推論スタックが丸ごと完結したというのです。
投稿の中身はQuixotic AIというプロジェクトで、作者自身がコメントで詳細を語っています[3]。それによると、JVM上でエンドツーエンドのAIスタックを組む本格的な試みです。CPU実行ではllama.cppと競争力のある性能が出るといいます。APIはシンプルで使いやすく設計され、スタックの各部品は単体でも動くそうです。対応モデルはGemma 4、Qwen 3.5+、LFM 2.5など最新のオープンモデルをカバー。スタック全体が、追加依存のない2.6MBのfat JAR(必要な部品を1つにまとめた実行ファイル)に収まります[3]。作者は「開発していてとても楽しかった」とも述べています。
純JavaでのLLM推論は、新しい発想ではありません。先例のJlamaでは、JavaのVector APIを通じてSIMD(1回の命令で複数の数値を同時に計算できるCPUの仕組み)を活かし、速度を稼ぐ手法が知られています。Jlamaの実測トークン/秒を計った記事も出ています[5]。JVMがネイティブコードなしでTransformerを動かす仕組みを解説する記事もあり[5]、土台の研究は進んでいました。Quixoticは、その流れに「依存ゼロ・1ファイル」という切り口で挑むプロジェクトのようです。
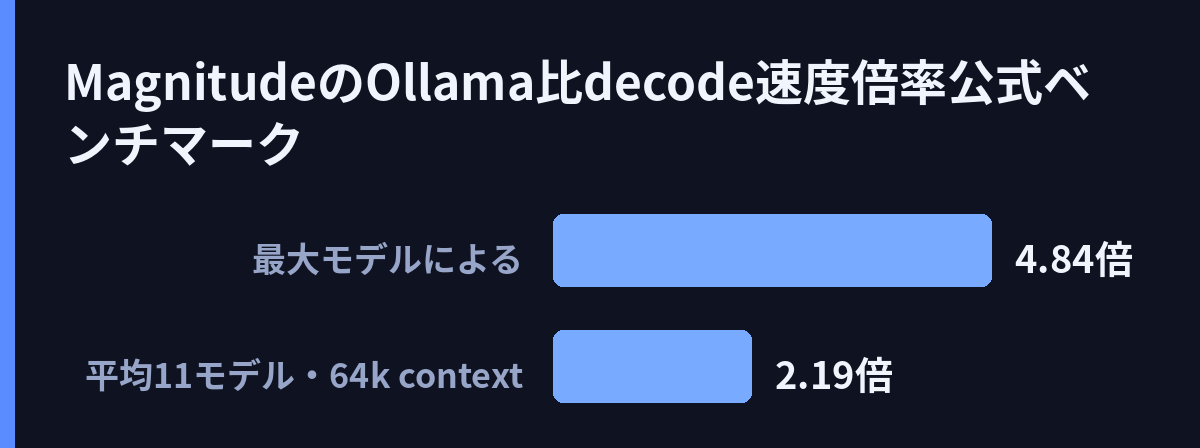
背景には、ローカル推論エンジン競争の激化があります。2026年の比較ガイドでは、Ollama、llama.cpp、vLLM、MLXなど主要7エンジンが並べて評価されました[4]。llama.cpp、Ollama、vLLM、SGLangをまとめた解説記事も複数出ています[5]。ガイドによると、Ollamaはllama.cppのラッパーで、素のllama.cppよりわずかに遠く、continuous batchingも持たないとされます[4]。速度をめぐっては、新エンジンのMagnitudeが目立つ数値を発表しました。Ollama比でdecode(トークンを1つずつ生成する段階)が平均2.19倍、モデルによっては最大4.84倍。11モデル平均・64kコンテキストという条件です[2]。鍵は、ダウンロード中に1分間の自動チューニングを行う仕組みと説明されています[2]。
しかし、この投稿は冷静に見るべき点もあります。タイトルは「llama.cppより速い」ですが、作者コメントの表現は「CPUでは競争力がある」にとどまります[3]。素材にはQuixotic自体の具体的なベンチマーク数値(TPSなど)は見つかりませんでした。Hacker Newsでの反応も2ポイント・コメント1件と、まだ小さな話題です[1]。さらに、複数ユーザーへ同時応答するサーバー用途では、continuous batching(リクエストをまとめて処理する方式)を持つvLLMやTensorRT-LLMが桁違いに速く[4]、CPU前提のJVM推論が戦える場は限られると思われます。
その一方で、ローカル実行の限界を押し広げる動きも続いています。Janasというプロジェクトは、32GB RAMのノートPCで80BのMoE(必要な一部のネットワークだけ計算する構造)を37 tok/sで動かしたと報告しています[5]。軽さと速度の両立をめざす工夫が、各所で試されているのです。
それでも、この投稿の示唆ははっきりしています。JVM向けにAIスタックが丸ごと揃うと、Javaの資産がある現場でローカル推論を組み込みやすくなると考えられます[3]。追加の依存ライブラリをインストールせずに済む点は、セットアップの負担を大きく減らします。2.6MBという軽さは、そのまま導入障壁の低さを示しています。速度主張の裏付けとなる実測値が公開されるか。そこが次の注目点になりそうです。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: 【2x Faster than Ollama】Why does it ‘auto-optimize in 1 minute’ for your … — https://note.com/makomo_memo/n/n898d967ce4cb?hl=en
【2x Faster than Ollama】Why does it ‘auto-optimize in 1 minute’ for your PC? The fascinating mechanism behind the new generation local LLM ‘Magnitude’
“I tried running a local LLM on my Mac or gaming PC, but waiting for t - HNコメント HNコメント: cal inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://news.ycombinator.com/item?id=50223693
Quixotic AI is a serious attempt to bring an end-to-end AI stack to the JVM. Performance is already competitive with llama.cpp (on CPUs), the APIs are crafted to be simple and easy to use. Every component in the stack ca
- Web記事 記事全文: Local LLM Inference Engines Compared: The Definitive 2026 Guide — https://www.local-llm.net/compare/inference-engines-2026/
The local LLM inference engine landscape in 2026 offers more choices than ever, and selecting the right one can dramatically affect your performance, developer experience, and hardware utilization. This guide compares th
- Web記事 Web検索: The Complete Guide to Local LLM Inference Tools in July 2026: llama.cpp … — https://dev.to/sreeraj-sreenivasan/the-complete-guide-to-local-llm-inference-tools-in-july-2026-llamacpp-ollama-vllm-sglang-and-4mh1
The Complete Guide to Local LLM Inference Tools in July 2026: llama.cpp …
- Web記事 Web検索: Pure-Java LLM Inference: How the JVM Runs Transformers Without Native … — https://mighri.fr/2026-09-17-llm_jvm_inference/
Pure-Java LLM Inference: How the JVM Runs Transformers Without Native …
- Web記事 Web検索: Local LLM Inference in Pure Java with Jlama: Tokens per Second, Measured — https://ankurm.com/local-llm-inference-in-pure-java-with-jlama-tokens-per-second-measured/
Local LLM Inference in Pure Java with Jlama: Tokens per Second, Measured
- Web記事 Web検索: Janas: 80B MoE on a 32 GB Laptop, 37 tok/s (Oct 2026) | explainx.ai … — https://www.explainx.ai/blog/janas-run-moe-llms-larger-than-ram-stream-experts-ssd-october-2026
Janas: 80B MoE on a 32 GB Laptop, 37 tok/s (Oct 2026) | explainx.ai …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS