GPUのメモリが8GBしかなくても、1700億超のパラメータを持つモデルが動く。こんな検証結果が、ローカルAIコミュニティで相次いで報告されています。主役はAlibabaのQwen 3.8 Flash Next。Hugging Faceでのダウンロードは先月だけで約180万回という注目のモデルです[3]。
Flash Nextは「Flash」の名のとおり、APIで1トークンあたりの計算を安く速くする方向のモデルです。ただし名前とは裏腹に、ディスク上のサイズは小さくありません[3]。MoE(トークンごとに、担当ごとに分かれたパラメータの一部だけを使う構造)で、1トークンの計算に動くのは6Bだけです。一方、保存するパラメータは全体で176.94Bに上ります[6]。ルータが次のトークンでどの専門家を選ぶかは事前にわからないため、全部をメモリに置いておく必要があるのです[3]。
ここで鍵になるのが、保存パラメータのうち51.2Bを占める「n-gram参照テーブル」です。直前の語の並びを辞書のように保存しておく部品で、計算はほとんどせず容量を稼いでいます[3][6]。VRAM構成別のベンチマークを公開したリポジトリによると、このテーブルをシステムRAMに移すと、モデルは8GBのカードで動き、GPUなしでも動きました[6]。逆にテーブルをGPUに置くと、decode(トークンを1つずつ生成する段階)が55.6倍遅くなるといいます[6]。
Redditのユーザーは、8GBのRTX 5060 Laptopと32GBのRAMという構成で、VRAM・RAM・SSDに仕事を振り分けるツール「Strata」を試しました[1][7]。手順を解説する記事も出ています[8]。Strataは当初12GBのVRAMが必要と思われていましたが、このユーザーは8GBで試して結果を出したといいます[1]。prefill(プロンプト全体を一括処理する段階)は最大毎秒900トークン、decodeは毎秒30トークンでした。しかもかなり強く圧縮するQ2量子化(重みを圧縮してメモリを節約する仕組み)の状態で、ベンチマークも実用テストも、比較したQwen 3.6 35B A3Bの微調整版やQwen 3.8 27Bより良い成績だったと報告しています[1]。ユーザー自身は「クリックベイトではない実測だ」と強調しています[1]。
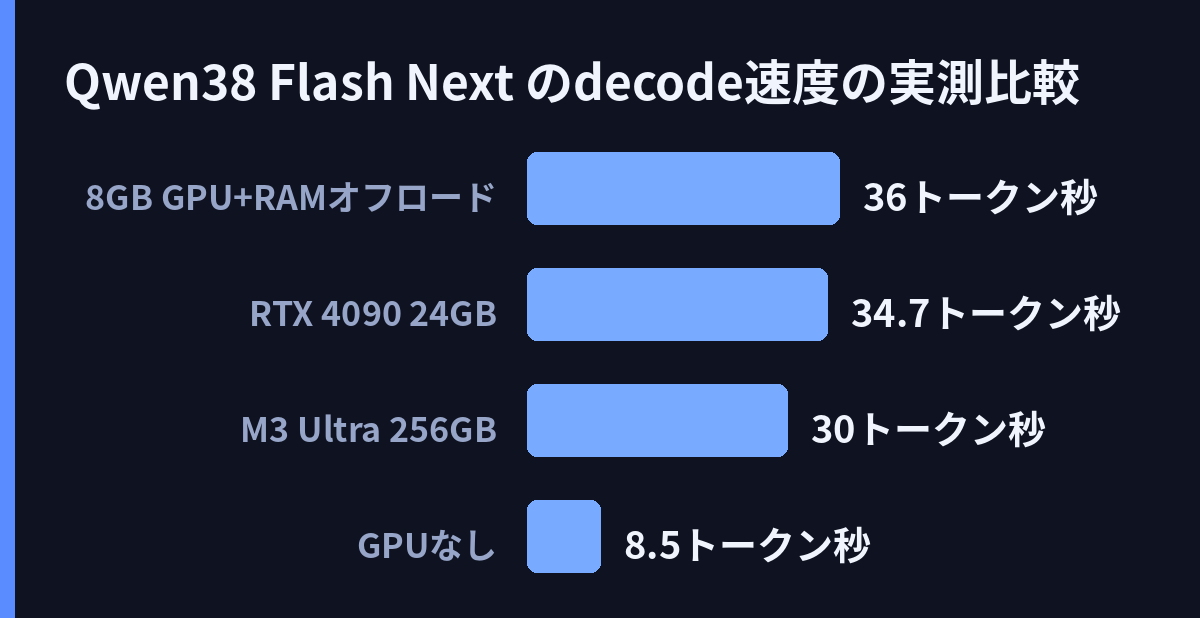
llama.cppでの検証も進んでいます。8GBのカードでは毎秒36トークン、GPUなしでも毎秒8.5トークンに達しました[6]。RTX 4090(24GB)と64GBのRAMの組み合わせでは約34トークン、64GBに制限して確認しても34.4〜34.7トークンで変わらないといいます[6]。Apple SiliconのM3 Ultra(256GB)では、119.6GBを使う4bit系の量子化(Q4_K_M)で毎秒約30トークンという報告もあります。同じ配置のままで読み込みモードを変えるだけでprefillが1.87倍になるという発見もあります[6]。
しかし、うまくいく構成には差があります。公式のNVFP4ビルドは、専門家部分だけを4bitにし、attentionやルータ、埋め込みはBF16(圧縮前の精度)のまま残すため、フラットな4bitなら約90GBのところ135GBになります。モデルカードは、長時間動き続けるエージェント的な生成では出力が長引くことも記しています[3]。27Bの量子化比較では、4bitは実用になる精度を保つ一方、1bitまで圧縮すると性能が崩れるという結果も出ています。速度を稼ぐ仕組みにも癖があります。次のトークンを先読みして速くするMTPは、24GBカードの構成では逆に3.4倍遅く(毎秒10.2対34.7トークン)、専門家をすべてGPUに置ける96GBの環境では1.61倍速くなるといいます[6]。マイクロバッチを大きくすると、約1GiBのVRAMと引き換えにprefillが30.8%向上するという細かい知見もあります[6]。
古いGPUでの動かし方も健在です。Hacker Newsには、古いTesla P100を2枚でQwen 3.8 27Bを6bit系の量子化で動かし、毎秒約60トークンという投稿がありました[2]。コメントで動作環境を尋ねる声があり[5]、投稿者によるとOSはLinux Mint、本体はDellだそうです。この「古いGPU2枚で27Bを毎秒60トークン」という数値は、以前この連載で取り上げた実測と同じものです。27Bのベンチマークまとめサイトも公開されています。
ちなみに同じ頃のX(日本)のトレンドには、「GPT-6.1Terra」や「バベルのSoranji」[4]といった語も並んでいました。環境側も整ってきて、推論エンジンのvLLMやSGLangが検証済みの設定を公開し、公式のFP8(8bit精度)チェックポイントも配布されています[3]。巨大な参照テーブルを安いメモリへ逃がす発想は、GPUの増強とは別の方向の解です。今後は「どの部品をどこに置くか」という設計が、ローカル推論の鍵になっていくようです。
引用ソース
- Reddit Reddit r/LocalLLaMA: Have 8 GB of VRAM and 32 GB of RAM? You can run Qwen 3.8 Flash Next at up to 900 t/s PP and 30 t/s TG! — https://www.reddit.com/r/LocalLLaMA/comments/1xft2ae/have_8_gb_of_vram_and_32_gb_of_ram_you_can_run/
Have 8 GB of VRAM and 32 GB of RAM? You can run Qwen 3.8 Flash Next at up to 900 t/s PP and 30 t/s TG!
- Hacker News Hacker News: 2x Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps — https://github.com/Kmic-68/llama.cpp
2x Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps
- Web記事 記事全文: Qwen 3.8 Flash-Next Hardware Requirements: Size, GPU, and VRAM (2026) — https://www.yottalabs.ai/post/qwen-3-8-flash-next-hardware-requirements-gpu-memory-2026
Flash-Next activates 6 billion parameters per token and stores 180 billion. The second number is the one your GPUs have to hold. Here’s every build size and the hardware each one fits.
Qwen 3.8 Flash-Next’s main checkpoi - X Xトレンド: バベルのSoranji — https://trends24.in/japan/
バベルのSoranji
- HNコメント HNコメント: Tesla p100s, q6_k quant, Qwen 3.8 27B ~60tps — https://news.ycombinator.com/item?id=50146283
Interesting. What system were running the cards on?
- Web記事 記事全文: GitHub – lukaLLM/Qwen3.8-Flash-Next-VRAM-Benchmark — https://github.com/lukaLLM/Qwen3.8-Flash-Next-VRAM-Benchmark
LOCAL AI SERIES:
– NEW: Qwen3.8 Flash: Over 7x Faster First Token | llama.cpp vs SGLang vs FreeToken. Benchmarked! https://youtu.be/RlsxXB5q-cA
– Why Qwen3 8 Flash Is So Cheap to Run 0 to 96GB VRAM Explained and Tested! - Web記事 Web検索: GitHub – Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware … — https://github.com/Niko1221/Strata
GitHub – Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware …
- Web記事 Web検索: Run Qwen3.8-Flash-Next Locally With Strata: Hardware, Speed, Trade-offs — https://launchboosts.com/blog/run-qwen-3-8-flash-next-locally-strata
Run Qwen3.8-Flash-Next Locally With Strata: Hardware, Speed, Trade-offs
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS