aiの話題で、hacker好みのローカル推論がflashのように速くなったことがわかりました。llama.cppのCUDA PR #31188が出ました。MoEのゲートとupの行列積、GLUをMMQ内で融合しました [1]。MoEは専門家ネットワークの一部だけ使う構造です。ゲートとupは、その専門家への入力を作る2つの線形変換です。GLUは、2つの出力を掛け合わせて活性化を制御する仕組みです。MMQは、量子化された重みで行列積を速く行うための仕組みです。
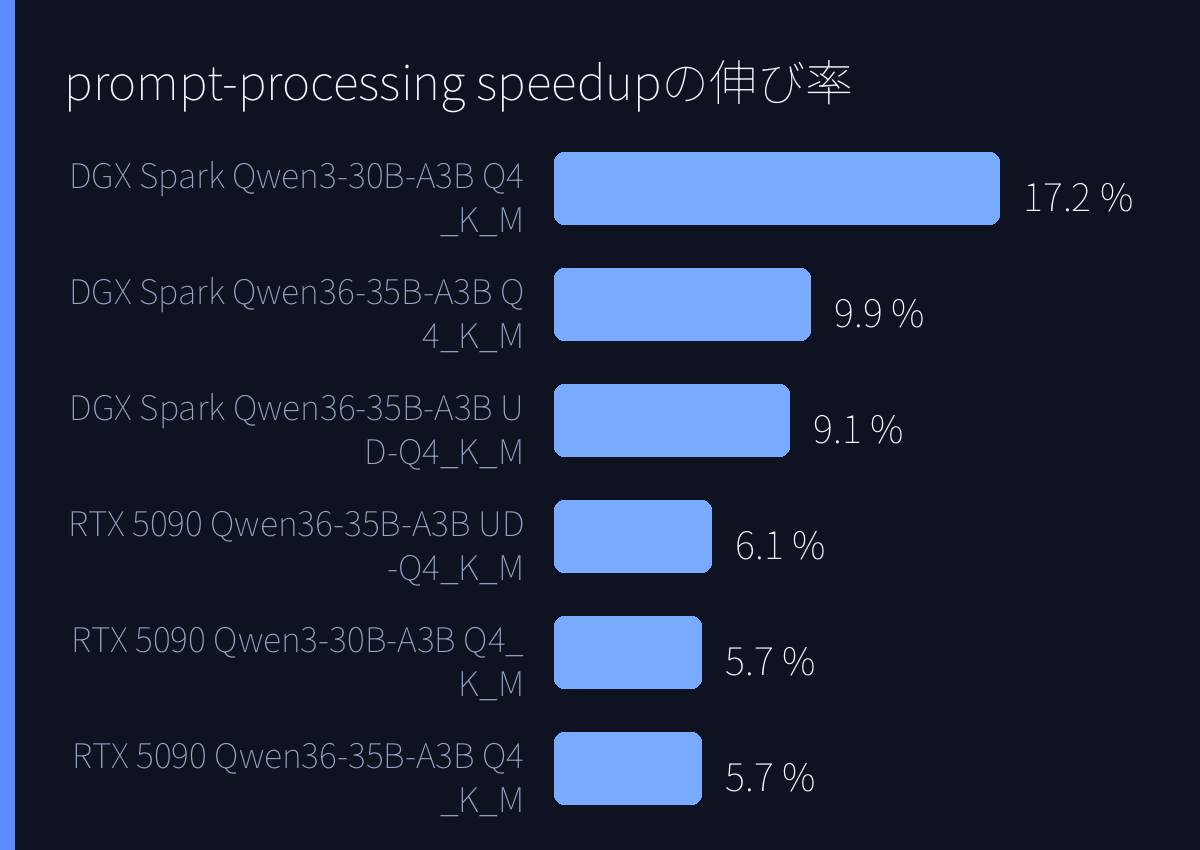
試した環境はDGX SparkのGB10とRTX 5090です。数値はprompt-processing speedup、つまりプロンプト処理の速度です。Qwen3-30B-A3BをQ4_K_Mのような圧縮形式で動かすと、DGX Sparkでは2911.4から3410.8へ17.2%伸びました [1]。RTX 5090では同じ設定が12611.7から13330.3へ5.7%でした [1]。Qwen3.6-35B-A3BもDGX Sparkで9.9%、RTX 5090で5.7%でした [1]。別の圧縮形式でも、DGX Sparkで9.1%、RTX 5090で6.1%でした [1]。
この改善は、計算そのものを劇的に軽くしたというより、細切れの処理をまとめた効果と思われます。これは、CUDAバックエンドの最適化セットの一部です。MoEの推論では、ゲートとupを別々に実行し、GLUを挟むと、メモリ往復やカーネル起動が増えます。カーネル起動とは、GPUに計算命令を出すことです。ゲートとupを同時に計算し、GLUの掛け算まで続けることで、GPUの待ち時間を減らせます。融合すると、中間結果をGPUメモリに書き戻す回数を減らせます。prefill(プロンプト全体を一括処理する段階)で特に効きそうです。
同じ方向性は、Fused-MoEという実装にも見えます。これはsoftmaxルーティング、top-k選択、gate-up GEMM、SiLUゲート、down GEMM、加重scatter-addを1つの呼び出しにまとめます [2]。softmaxは、値を確率のように整える関数です。top-kは、上位の専門家だけを選ぶ仕組みです。GEMMは行列積の計算です。SiLUは滑らかに値を絞る活性化関数です。加重scatter-addは、重みを掛けた結果を足し戻す処理です。Pythonのループを置き換え、1回の呼び出しに寄せることで、制御の細切れを減らします。
注目したいのはdecode(トークンを1つずつ生成する段階)です。この実装では、トークン数が1、専門家が64、選ぶ数が6のとき、専門家ループを6回だけ回し、GPU同期は1回に抑えます [2]。素朴なPyTorch回帰では、各専門家を使うか確認するたびにGPUとCPUが同期し、64回になるため、decodeで不利です [2]。この経路では、一度だけGPUからCPUへ個数を受け取り、残りはCPU側で判断します。トークンの生成が速いほど、この同期の差が目立ちます。
この実装は、トークン数が128以下ならdecode向け、それより大きければprefill向けに分けます [2]。prefillでは並び替えとパディングで大きなトークン数を効率化しますが、小さなトークン数ではパディング後の数が膨らむ問題があります [2]。Tritonという仕組みを使う経路では、計算はfloat32という高い精度で行い、保存はbfloat16という軽い数値形式にします [2]。タイル形状は、GPUで一度に扱うデータのブロックサイズです。decodeとprefillで別々に調整できます。CUDAだけでなく、ROCm、Ascend、MUSAといった別環境でも動く設計です [2]。
ただし、速さの数字は環境とモデルで変わります。DGX Sparkでは17.2%出ても、RTX 5090では5.7%にとどまります [1]。DGX SparkはGB10を使う環境、RTX 5090は別のGPU環境です。これは、GPUの性能差だけでなく、ボトルネックがどこに移動したかの違いと思われます。融合が万能なら、どの環境でも同じ倍率になるはずです。実際には、メモリ帯域、圧縮形式、MoEの専門家数、一度に処理する数で効き方が変わります。
今回の話題は、llama.cppのCUDA最適化議論 [3]、MoE推論のガイド [4]、Hexagonベンチマーク [4]、NVIDIAの訓練向け融合カーネル記事 [4]、2026年のllama.cpp高速化記事 [4] と同じ流れにあります。訓練でも推論でも、MoEは融合カーネルの設計が速さを左右します。NVIDIAの訓練向け記事も、MoEの訓練で融合カーネルが重要だと読み取れます [4]。aiのローカル実行では、セットアップとバージョン管理が大事です。今回のPRは、MoEの細切れ処理をまとめることで、prefillの速度を確実に押し上げました。
引用ソース
- Reddit Reddit r/LocalLLaMA: CUDA: fuse MoE gate/up matmuls and GLU in MMQ by anujj · Pull Request #31188 · ggml-org/llama.cpp — https://www.reddit.com/r/LocalLLaMA/comments/1xhodj3/cuda_fuse_moe_gateup_matmuls_and_glu_in_mmq_by/
CUDA: fuse MoE gate/up matmuls and GLU in MMQ by anujj · Pull Request #31188 · ggml-org/llama.cpp
- Web記事 記事全文: GitHub – lvy010/Fused-MoE: A fused Mixture-of-Experts CUDA kernel that … — https://github.com/lvy010/Fused-MoE/tree/main
fused_moe.py 将完整的 MoE 前向传播——softmax 路由、top-k 选择、gate-up GEMM、SiLU 门控激活、down GEMM 以及加权 scatter 归约——融合为一次优化调用。
hidden_states [M, K] ──► softmax + topk ──► 排序分发
│ - Web記事 記事全文: Optimizing Token Generation in llama.cpp’s CUDA Backend — https://github.com/ggml-org/llama.cpp/discussions/17621
You signed in with another tab or window. Reload to refresh your session.You signed out in another tab or window. Reload to refresh your session.You switched accounts on another tab or window. Reload to refresh your sess
- Web記事 Web検索: Guide to optimizing inference performance of large MoE models across … — https://gist.github.com/DocShotgun/a02a4c0c0a57e43ff4f038b46ca66ae0
Guide to optimizing inference performance of large MoE models across …
- Web記事 Web検索: Performance Benchmarking | jeffzhou2000/ggml-hexagon | DeepWiki — https://deepwiki.com/jeffzhou2000/ggml-hexagon/10.3-performance-benchmarking
Performance Benchmarking | jeffzhou2000/ggml-hexagon | DeepWiki
- Web記事 Web検索: Boosting MoE Training Throughput with Advanced Fusion Kernels — https://developer.nvidia.com/blog/boosting-moe-training-throughput-with-advanced-fusion-kernels/
Boosting MoE Training Throughput with Advanced Fusion Kernels
- Web記事 Web検索: How to Optimize llama.cpp for Maximum Inference Speed in 2026 — https://docs.bswen.com/blog/2026-03-15-llamacpp-optimization-speed/
How to Optimize llama.cpp for Maximum Inference Speed in 2026
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS