ダウンロードの夜が、またやってきそうです。UnslothがQwen3.8-Flash-Next向けにDynamic V3.1 GGUFを出しました。GGUFはローカル実行向けの圧縮ファイル形式です。DeepSWEやTerminal Bench、Aider Polyglotなどで、既存の比較対象であるGSQ-RCOの量子化比と比べて10〜15%精度が向上したと主張しています[1]。Redditでは11月4日の更新として、新しいQFN(Qwen3.8-Flash-Next)をダウンロードする夜だと話題になっており、精度は15%高いと書かれています[4]。Xでは「ChatGPTImages2.6」もトレンドに入っていますが[3]、ローカルLLMでは量子化(重みを圧縮してメモリを節約する仕組み)の更新が注目されています。
注目点は検証の量で、Unslothはベンチマークにノイズが多いとして、検証に26Bトークン超を使いました。内訳はDeepSWEが18.1Bトークン、Terminal Benchが5.2Bトークンです[1]。LiveCodeBenchは3回、HMMTなどは8〜16回繰り返したと書かれており、エージェント系のベンチマークは256K、他は128Kのコンテキストで、温度1.0や次の語を選ぶ幅0.95といった生成条件を揃え、繰り返しペナルティは使わずに比較しています[1]。
もう一つの新しさは量子化の型を切り替える手順で、ほぼ元の精度のBF16や8bit圧縮の型をまたいで使う「engram switching」を全量子化向けに用意したとされています[1]。これはDeepSeek-V4.1-Flash向けのUD3.1(Unsloth Dynamic 3.1)の延長で、そちらでは他の量子化比で10〜20%の精度向上を報告しています[1]。つまり、単にモデルを圧縮するだけでなく、どの型でどこまで精度を守るかの設計が更新されたようです。
同じQwen3.8系の27Bでは、ローカル実行の目安も出ています。GGUFはGPUのVRAMに収まる層を置き、残りをCPU側のDDR4/DDR5 RAMに逃がす仕組みです[5]。RTX 3060や4060の8GB/12GBでも、量子化と層の置き分け次第で動く可能性があります[5]。Unslothの27B向けDynamicでは、1bit版が8GB RAMで動作し、使い回していない評価の保持テストで77%の精度を保ったとされています[6]。

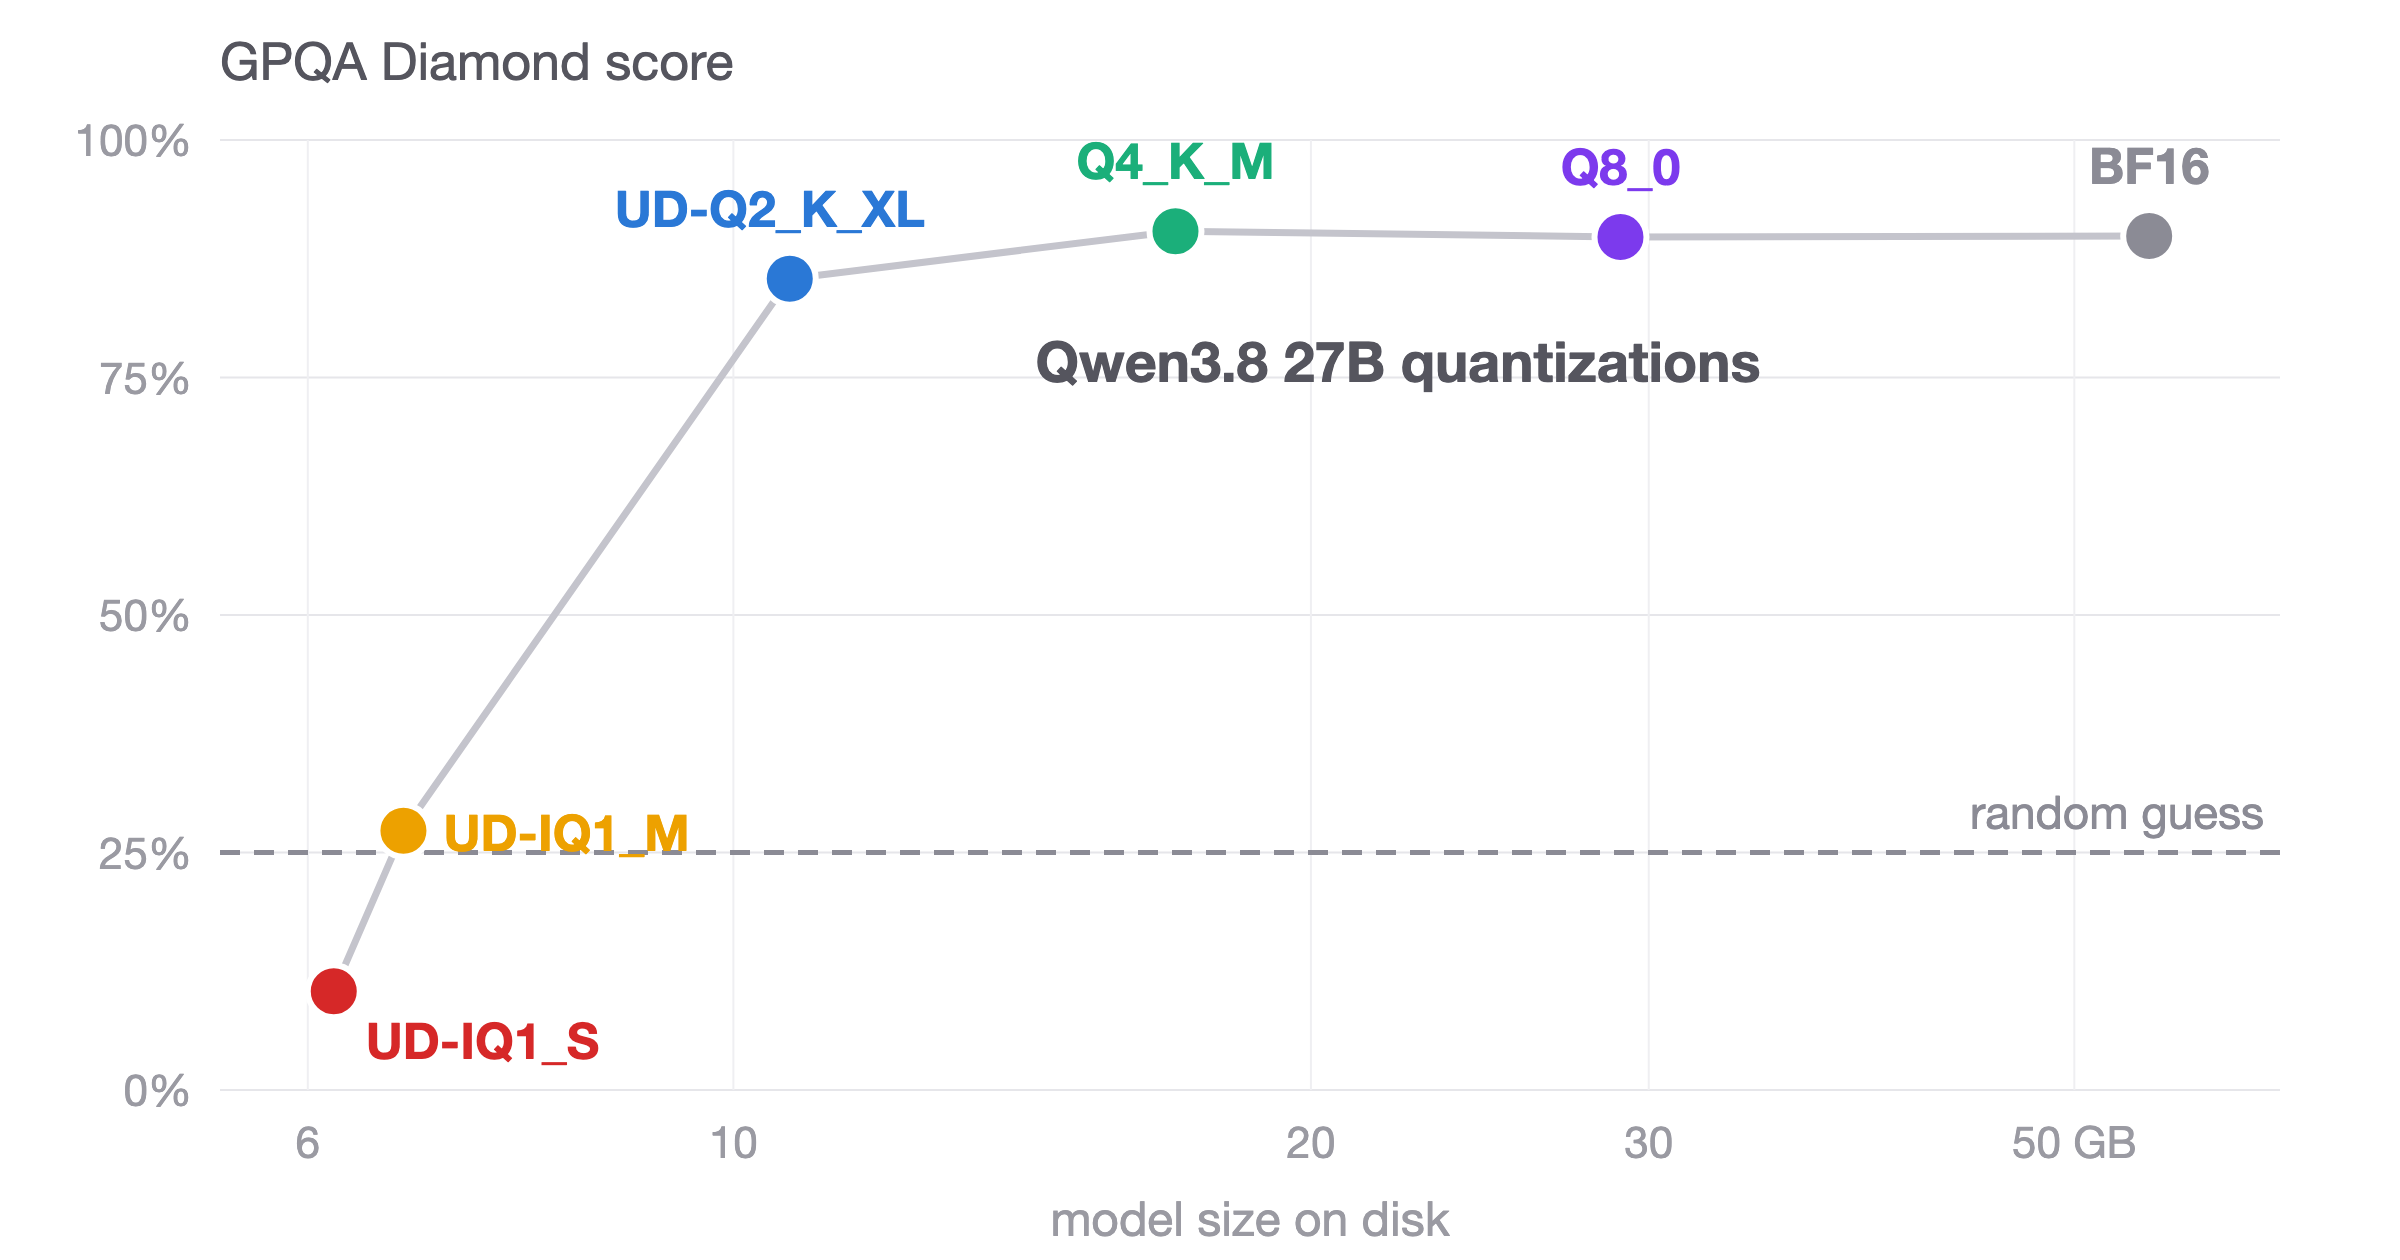
ただし、圧縮には落とし穴もあります。別の実測記事では、BF16の27Bは55GB、4bit系のQ4_K_Mは17GBで、Terminal Bench 2.1ではフルモデルとの差が見られなかったと報告されています[7]。24GBのRTX 4090なら、約64kトークンのコンテキストを確保できるようです[7]。一方、1bitではGPQA Diamondがほぼランダムに近い結果で、推論が長くなるほど悪化しました[7]。KVキャッシュ、つまり生成中の履歴を保持するメモリも、F16で32kトークンあたり約2.3GB必要です[7]。
では、Flash-Next V3.1はローカルで使えるのでしょうか。現在のところ、Hugging Faceのページではllama.cpp、vLLM、OllamaなどでUD-Q4_K_XLのような4bit系タグを使う例が示されています[2]。ただし、Flash-Nextの必要VRAM/RAMやTPS(1秒あたりの生成速度)の実測値は見つかりませんでした。以前取り上げたQwen4系の125B MoEの話とは条件が違うため、単純比較はできません。
結局、V3.1の話題は「新しい量子化ファイルが出た」より「どのタスクで、どの型まで許容できるか」に近づいています。検索結果でも4bitから1bitまでの精度やトークン効率、KVキャッシュ最適化が取り上げられています[8]。まずは4bit前後でエージェント作業を試し、1bitは検証用にとどめるのが安全そうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: New Qwen3.8-Flash-Next Unsloth Dynamic V3.1 GGUFs — https://www.reddit.com/r/LocalLLaMA/comments/1xnvbxn/new_qwen38flashnext_unsloth_dynamic_v31_ggufs/
New Qwen3.8-Flash-Next Unsloth Dynamic V3.1 GGUFs
- Web記事 記事全文: unsloth/Qwen3.8-Flash-Next-GGUF · Introducing Qwen3.8-Flash Unsloth … — https://huggingface.co/unsloth/Qwen3.8-Flash-Next-GGUF/discussions/91
– Notebooks
– Google Colab
– Kaggle
– Local Apps Settings
– llama.cpp How to use unsloth/Qwen3.8-Flash-Next-GGUF with llama.cpp: Install (macOS, Linux) curl -LsSf https://llama.app/install.sh | sh
# Start a local O - X Xトレンド: ChatGPTImages2.6 — https://trends24.in/japan/
ChatGPTImages2.6
- Reddit Reddit r/LocalLLaMA: Unsloth Qwen3.8-Flash-Next GGUFs V3.1 Update (November 4th 2026) — https://www.reddit.com/r/LocalLLaMA/comments/1xnuva2/unsloth_qwen38flashnext_ggufs_v31_update_november/
Unsloth Qwen3.8-Flash-Next GGUFs V3.1 Update (November 4th 2026)
- Web記事 記事全文: Unsloth Releases Qwen 3.8-27B in GGUF: Quantization Guide, CPU RAM … — https://ia4pymes.tech/en/blog/unsloth-qwen-3-8-27b-gguf-run-local-ram-smes-2026
The team at Unsloth AI has published the official GGUF quantized collection for the Qwen 3.8-27B model on Hugging Face (huggingface.co/unsloth/Qwen3.8-27B-GGUF).
This release represents a major milestone for small and me - Web記事 記事全文: Unsloth Qwen3.8-27B GGUF: Which Quant for Your RAM? (Aug 2026 … — https://www.explainx.ai/blog/unsloth-qwen3-8-27b-dynamic-v3-ggufs-august-2026
Unsloth followed its early-preview Dynamic v3.0 quantization method with a full release for Qwen3.8-27B, announced via @UnslothAI around August 19-20, 2026. The headline claim: these GGUFs deliver more than 10% better to
- Web記事 記事全文: Benchmarking Qwen3.8 27B quantizations: 4-bit holds up, 1-bit collapses — https://quesma.com/blog/qwen38-27b-quantizations-benchmarked/
How much GPU RAM do you actually need to run Qwen3.8 27B without sacrificing quality?
The full BF16 model weighs 55 GB, putting it beyond most consumer hardware.
Yet the 17 GB Q4_K_M matches the full model on a popular a - Web記事 Web検索: Qwen3.8 Flash Next GGUF Benchmark: Q4 to Q1 Accuracy and Token Efficiency — https://kaitchup.substack.com/p/qwen38-flash-next-gguf-benchmark
Qwen3.8 Flash Next GGUF Benchmark: Q4 to Q1 Accuracy and Token Efficiency
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。

RECENT COMMENTS