AIにコードを直させるなら、クラウドに送らない方が速い場面があります。Xのトレンドには「AIバブル」や「AIバブル崩壊」[3]といった語も上がっています。その一方で、MicrosoftのFoundry Localが開発機のGPUでコーディングAIを動かす方向で注目されています[2]。
Foundry Localは、Qwen3.8-27Bというコーディングに強いモデルをローカルで動かします。公開ベンチマークもあり、ターミナル操作やリポジトリ全体のコード生成で強い点が報告されています[2]。GitHub Copilotに接続すれば、コードやリポジトリの内容を外部に送らずに、調査や修正まで進むエージェント型の使い方ができます。推論コストも把握しやすくなり、通信が切れても作業が続けられます[2]。
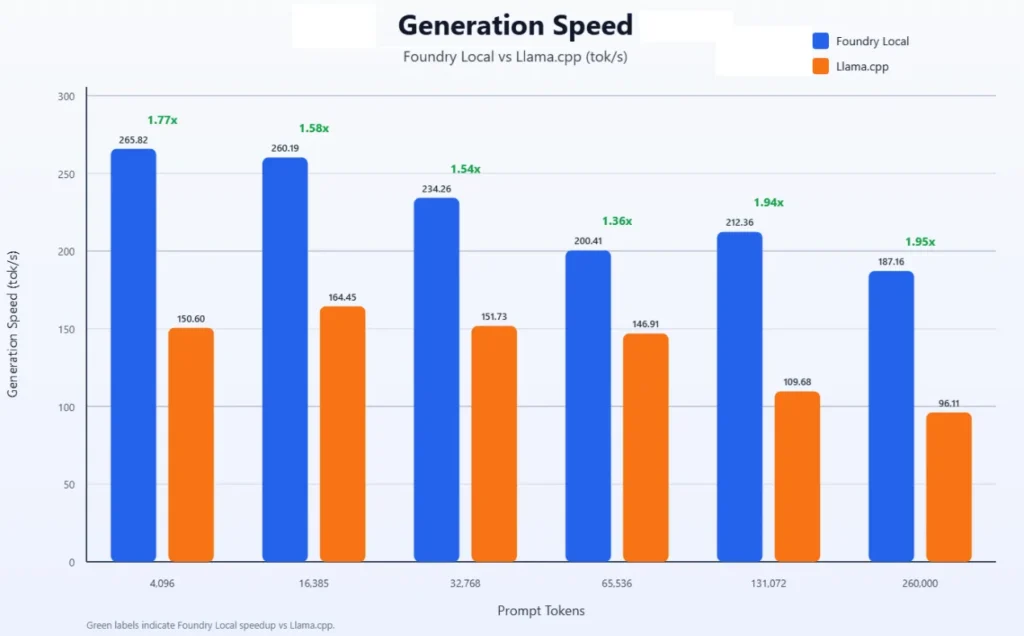
Redditでは、RTX 5090とNVIDIA DGX Sparkで改善が報告され、decode(トークンを1つずつ生成する段階)の処理速度が35〜135%上がったそうです[1]。Microsoftのベンチマークでは、RTX 5090とNVIDIA DGX Sparkが使われ、DGX Sparkは128GBのメモリをCPUとGPUで共有します。ローカル推論エンジンのllama.cppと比べ、どのプロンプト(指示文)の長さでも、Foundry Localが速かったと報告されています[5]。131Kトークンを超えると差が広がったそうで、リポジトリ全体を読むような長い文脈で有利そうです。

速さの裏には推論の工夫があり、Foundry Localはモデルを動かすための実行基盤としてONNX Runtimeを使います。prefill(プロンプト全体を一括処理する段階)とdecodeの両方を最適化します[2]。DFlash2という推測生成(speculative decoding)で複数トークンを先に予測し、4-bit量子化(重みを圧縮してメモリを節約する仕組み)でモデルを約18GBに縮めます[2]。さらに、途中経過を保持するメモリを圧縮し、足りない分をCPUに退避して、24GBのGPUメモリでも動くようにしています[2]。
開発者が試すセットアップ手順も出ており、Foundry Local CLI(コマンドラインツール)の0.13.0以上が必要です[5]。GitHub CopilotのBring Your Own Keyも使い、自分のモデルやキーを指定する仕組みです[5]。CUDAとcuDNNはGPU向けの計算ライブラリで、同梱されず、別途インストールします[5]。Microsoft Learnのクイックスタートでは、.NET 8.0 SDK(開発キット)を使い、Azureのサブスクリプションは不要です。モデルをダウンロードし、チャット応答を生成する例も出ています[5]。Mediumでは、Copilotを部品として使うための開発キットであるCopilot SDKとFoundry Localの解説も出ています[5]。
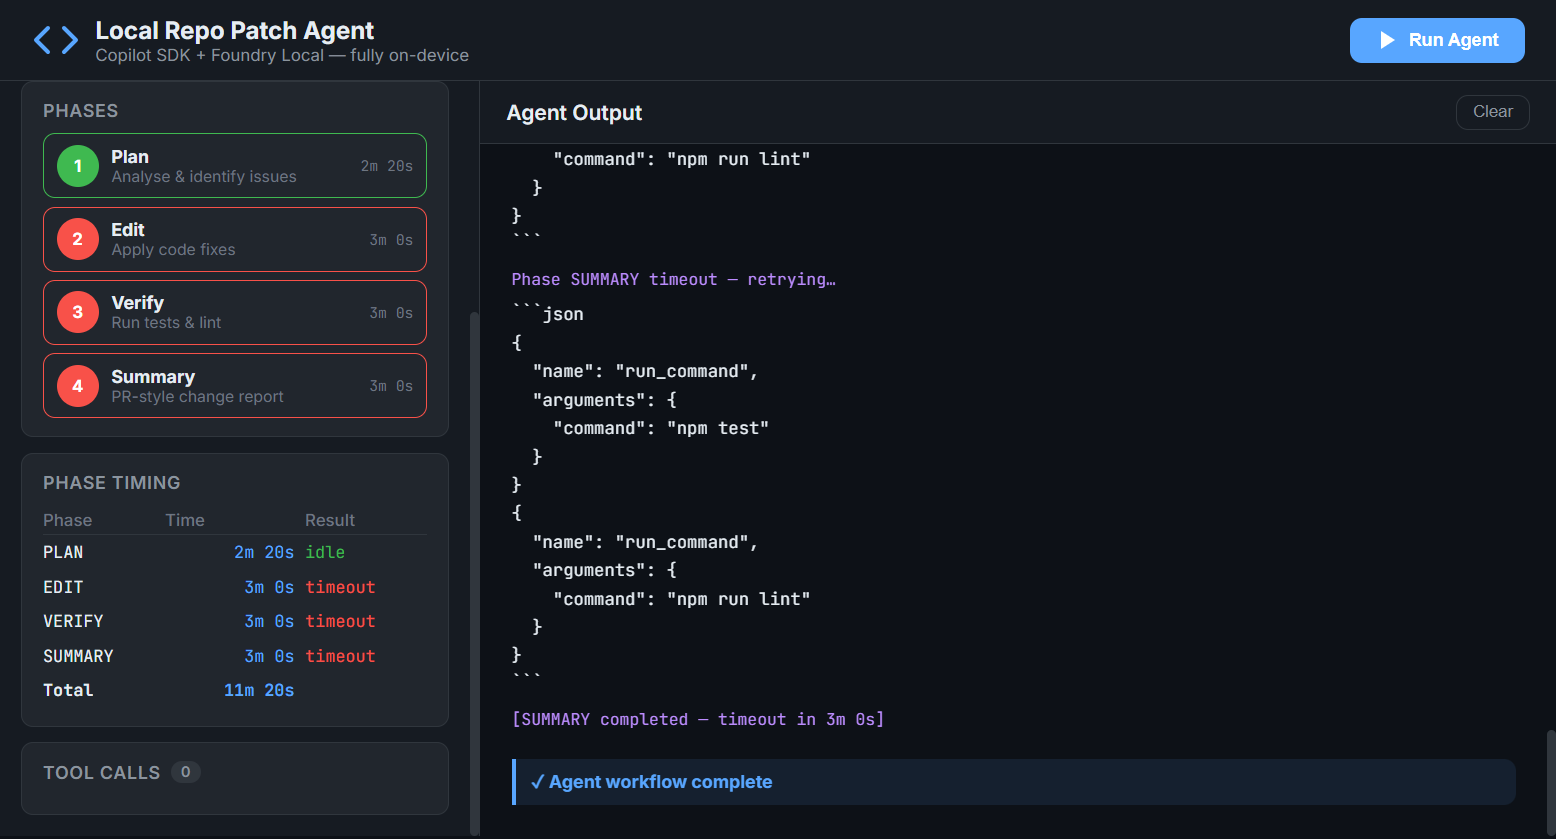
さらにCopilot SDKとFoundry Localを組み合わせると、リポジトリを自分で調べて修正まで進むエージェントが作れます。例としてLocal Repo Patch Agentがあり、バグやコードの臭いを検出します。コードの臭いは保守性を損なう癖です。修正し、テストで確認し、変更要約を生成する流れは完全にオフラインで動きます[4]。金融や医療、政府案件など、ソースコードを外部に出せない現場では、この制約が大きな意味を持ちます[4]。
ただし万能ではありません。現在の最適化はNVIDIA GPU向けで、MacやAMD GPUの対応は今後の予定とされています[5]。24GBのGPUメモリでは64Kトークンまで、32GB以上なら262Kトークンまで使えますが、メモリ制限もあります[2]。Redditでは「llama.cppにこの仕組みを載せられないか」という声もあり、既存のローカル推論環境への波及はこれからようです[1]。
Foundry Localの話題は、Xトレンドに「AIバブル」や「AIバブル崩壊」[3]が上がる中で出ています。ローカル推論が実用ラインに近づいたことがわかり、Qwen3.8-27Bを約18GBで動かせます[2]。llama.cppより速いという数値は、開発現場にとって大きな魅力になりそうです[5]。一方で、対応GPUやメモリ、llama.cppなどへの移植の課題も残ります。次は、どのハードで同じ体験が得られるかが注目されそうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: Bring Agentic Coding On-Device with Foundry Local — https://www.reddit.com/r/LocalLLaMA/comments/1xp4lv5/bring_agentic_coding_ondevice_with_foundry_local/
Bring Agentic Coding On-Device with Foundry Local
- Web記事 記事全文: Bring Agentic Coding On-Device with Foundry Local — https://devblogs.microsoft.com/foundry/foundry-local-agentic-coding-qwen3-8-27b/
Coding agents can dramatically accelerate development—but cloud-only AI assistants can rack up costs, send sensitive context over the wire, and stall the moment your connection drops. Local inference flips that trade-off
- X Xトレンド: AIバブル崩壊 — https://trends24.in/japan/
AIバブル崩壊
- Web記事 記事全文: Agentic Code Fixing with GitHub Copilot SDK and Foundry Local … — https://techcommunity.microsoft.com/blog/educatordeveloperblog/agentic-code-fixing-with-github-copilot-sdk-and-foundry-local/4493967
Building a Local Repo Patch Agent:
Introduction
AI-powered coding assistants have transformed how developers write and review code. But most of these tools require sending your source code to cloud services, a non-starte - Web記事 記事全文: Get started with Foundry Local – Foundry Local | Microsoft Learn — https://learn.microsoft.com/en-us/azure/foundry-local/get-started
In this quickstart, you create a console application that downloads a local AI model, generates a streaming chat response, and unloads the model. Everything runs on your device with no cloud dependency or Azure subscript
- Web記事 記事全文: Bring Agentic Coding On-Device with Foundry Local — https://daily.dev/posts/bring-agentic-coding-on-device-with-foundry-local-v5peiycsu
Foundry Local now runs the Qwen3.8-27B coding model on-device and connects it to GitHub Copilot. With 4-bit quantization the model shrinks to about 18 GB, running on consumer GPUs with 24 GB or more of VRAM. Microsoft be
- Web記事 Web検索: Building Agentic AI with GitHub Copilot SDK and Foundry Local … – Medium — https://medium.com/@shweta-lodha/building-agentic-ai-with-github-copilot-sdk-and-foundry-local-on-device-inference-made-practical-15e6e2a4d673
Building Agentic AI with GitHub Copilot SDK and Foundry Local … – Medium
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS