ハッカー系の話題として、AlibabaのAI「Qwen4」をめぐる動きがまた出てきました。正式な発表ではなく、仮名モデルや推論設定の断片から、公開の気配がうかがえる段階です。
Redditのr/LocalLLaMAでは、Qoderで「Qoduck」を試した報告が上がっています。投稿者は、このモデルが画像生成と動画生成をネイティブに備えていることに気づいたと述べています[1]。Qwen4の候補と見られる一方、Alibabaはまだ名前を公表していません[2]。
Web記事では、Qoduckの正体の特定がさらに進んでいます。トークン化(文章をモデルが扱う単位に分割する仕組み)の検査でQwenファミリーのトークン化に一致し、知識評価では公開済みのQwenを上回ったと報告されています[2]。Qoder上の価格はQwen3.8-Maxと同じで、100万トークンのコンテキストに切り替えられるとされています[2]。個人ユーザーはアプリ内では毎日無料ですが、公開APIはありません[2]。Arenaでも仮名モデルKerriaがQwenのトークン化に一致し、Kalmiaが去った翌日に現れたとされています[2]。
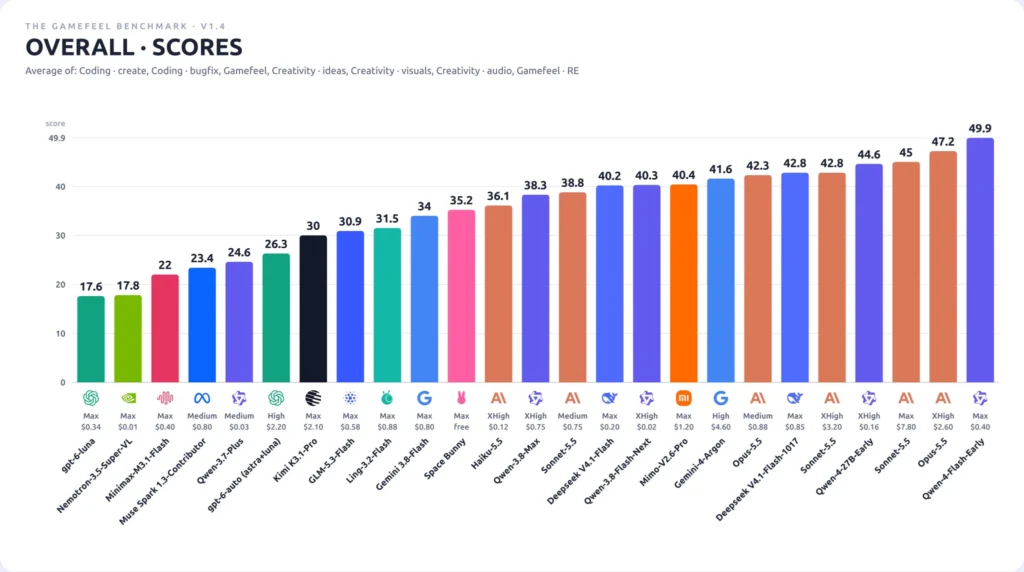
もう一つの焦点は、Flash-Earlyです。Xでは「Qwen-4-Flash-Early(codename hawk)」がGameFeel Benchに追加されたという報告があります[3][6]。音声スコアの計算ミスも修正されたとされています[6]。ただし、同じ投稿者から、提示されたデータはQwen4-27b向けだと確認する声と、Qoderアプリで走らせた小規模テストはMaxではないかという見方が出ています[5]。評価名とモデルの対応は、まだ揺れています。

こうした混線は、Qwenの評価文化とも関係しています。Qwenは以前からC-EvalやMMLU、HumanEval、GSM8K、WMT22、長文perplexity、ReActやHuggingFace Agentまで幅広く評価されてきました[4]。ベンチマークの範囲が広いほど、仮名モデルがどの枠に入るかを見分けにくくなります。
ここで重要なのは、ツール側の準備と、実体の評価状況がずれていることです。Qwen Codeのバージョンv0.26.5は、qwen4のモデルIDに対してlow、medium、xhighの推論レベル(考える深さの段階)を用意し、既定をxhighにしています[2]。Qwen Code v0.26.3では、qwen4ファミリー全体について、100万トークンを想定した設定にしています[2]。アムステルダムでのApsara Conferenceでも、「Qwen4 Series Coming Soon」の資料にMax、Flash、Plus、27Bが並んでいました[2]。一方、Qwenの公式アカウントは10月14日以降沈黙し、荘子の「北の海に魚あり、名は…」という言葉を載せたポスターを出しただけです[2]。名前も日付も空欄のまま、ハッカー的な仮名運用が続いています。
ローカル実行の観点では、現在のところQwen4の重みの公開、量子化(重みを圧縮してメモリを節約する仕組み)版、必要なVRAM/RAMの目安は見つかっていません。Qwen4シリーズにはMax、Flash、Plus、27Bが並ぶと示唆されていますが、27BがQwen3.8-27Bのように4bit量子化で17GB程度で動くかは不明です。以前取り上げた実測では、Qwen3.8-27Bの4bit版がTerminal-Bench 2.1でフル精度に並ぶ結果を出したと報告されました。ただし、Qwen4で同じ条件が成り立つかは、まだ確認できません。llama.cppやvLLMでの対応も、現時点で確認できる情報では分かりません。当面は、公開APIのないQoder側で試すか、公式の重みとエンジン対応を待つのが安全そうです。
引用ソース
- Reddit Reddit r/LocalLLaMA: testing Qoduck (Maybe qwen4) on Qoder — https://www.reddit.com/r/LocalLLaMA/comments/1xqafp1/testing_qoduck_maybe_qwen4_on_qoder/
testing Qoduck (Maybe qwen4) on Qoder
- Web記事 記事全文: Qwen 4: Release Date, Kalmia, 27B, Max & Flash | Benchmarks — https://stealthmodels.com/qwen-4
Qwen3.8-Max lays out our steel room correctly, then gets the light wrong. See what Qwen 3.8 still misses on our hardest benchmarks, and every trace of Qwen 4 so far.
A familiar face. A difficult reflection. Shall we look - Reddit Reddit r/LocalLLaMA: follistatin on X: “Qwen-4-Flash-Early (codename hawk) added to GameFeel Bench! (and audio score was calculated — https://www.reddit.com/r/LocalLLaMA/comments/1xqrilf/follistatin_on_x_qwen4flashearly_codename_hawk/
follistatin on X: “Qwen-4-Flash-Early (codename hawk) added to GameFeel Bench! (and audio score was calculated
- Web記事 記事全文: Benchmark Results | QwenLM/Qwen | DeepWiki — https://deepwiki.com/QwenLM/Qwen/7.1-benchmark-results
Benchmark Results
Relevant source files
This document presents comprehensive benchmark results for the Qwen model family across multiple evaluation categories. It provides performance metrics for both the base pretrained - Web記事 記事全文: follistatin on X: “@torisetxd I just published results for Qwen-4-Flash … — https://x.com/follistatindev/status/2119222281624789116
Xユーザーのfollistatinさん: 「@torisetxd I just published results for Qwen-4-Flash-Early (codename hawk) that I got access to, also today, and I can confirm the data presented here was for Qwen4-27b check out my updated post:
ht - Web記事 記事全文: Qwen-4-Flash-Early (codename hawk) added to GameFeel Bench! (and audio … — https://x.com/follistatindev/status/2119220233751671186
Xユーザーのfollistatinさん: 「Qwen-4-Flash-Early (codename hawk) added to GameFeel Bench!
(and audio score was calculated wrong for qwen-4-27b, a genuine mistake that was fixed)」
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS