切り替えの速さに関する話が変わってきました。以前はモデルをどう載せ替えるかが中心でしたが、今は会話の途中結果をどう残すかが鍵になっています。Hacker Newsでは、KV cacheの再利用を掲げるTokiRecurが3ポイント、0コメントで投稿されました[1]。KV cacheは、推論のprefill(プロンプト全体を一括処理する段階)で計算したkey/valueをメモリに保持します。次のdecode(トークンを1つずつ生成する段階)で再利用する仕組みです[2]。
もう一つ目立つのは、スリープからの切替を2秒以内にするという試みです。Hacker Newsでは1ポイント、0コメントでした[4]。GitHubでは、スリープとウェイクに対応したllmsnapも紹介されており、モデルを完全に読み直すのではなく、状態を保ったまま切り替える発想です。stillwarmという記事では、ローカルLLMが再起動後にキャッシュを忘れる問題を測定しています[8]。Xトレンドでは「Soranji」という語も上がっていますが、ここではllama.cppの話題とは切り離して扱います[3]。
速度の土台は、依然としてllama.cppの構成です。ある解説では、RTX 3090で27Bモデルが約3 TPSだったと報告されています[5]。GPUへのオフロード(重い部分をGPUに寄せる仕組み)や計算基盤、KV cache、バッチサイズ(一度に処理する量)を見直すと、40+ TPSになったと報告されています[5]。TPSは1秒あたりの生成トークン数ですが、これはモデルや量子化、会話の長さ、ビルドに依存する例です。

速度を評価するなら、prefillとdecodeを分ける必要があります。ある解説では、Flash Attentionや大きなバッチサイズはprefillを大きく改善しても、decodeに同じ割合の改善をもたらすとは限らないと書かれています[5]。Flash Attentionは、Attention計算を速くする仕組みです。切替高速化も、どちらの段階を軽くしたいかで設計が変わります。
切替を速くしても、KV cacheの置き場所を誤ると動作が止まります。M5 Max 128GBでQwen 3.6 35B-A3B、128k context(会話の長さ)、2 slots(同時処理の枠)という構成が報告されています[6]。その構成では、KV cacheは8bitに近い型で、Flash Attentionも使われていました。モデル約25GB、KV cache slot約4GBで、合計約33GBと計算できました。それでも15〜20回のツール呼び出しでeviction error(キャッシュを追い出すエラー)が出ました。
原因は、–cache-ramを「KV cacheをシステムRAMに逃がす指定」と誤解していたことです。実際には、2025年10月に導入された指定で、CPU側メモリにプロンプトの途中結果を保存する仕組みを制御します。生成中に使うKV cacheはGPUメモリに残ります[6]。ここを間違えると、メモリに余裕があるのにキャッシュが追い出されます。
ここにも落とし穴があります。KV cacheを圧縮するとメモリは浮きますが、速度も落ちます。ある実測記事では、64K tokensのコンテキストで、圧縮したKV cacheは16bit浮動小数の約半分のdecode速度になったと報告されています[7]。同じ記事では、KV cacheがVRAM(GPUメモリ)に収まるなら16bit浮動小数のまま、収まらないなら8bitに近い型をKとVに揃えるという指針も示されています[7]。
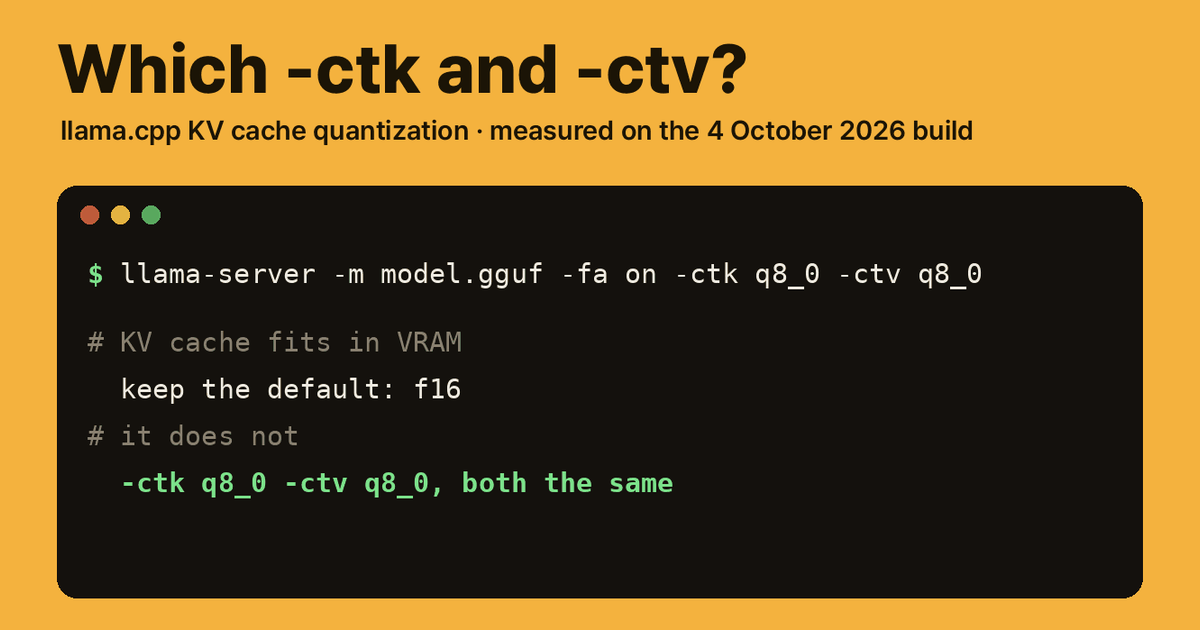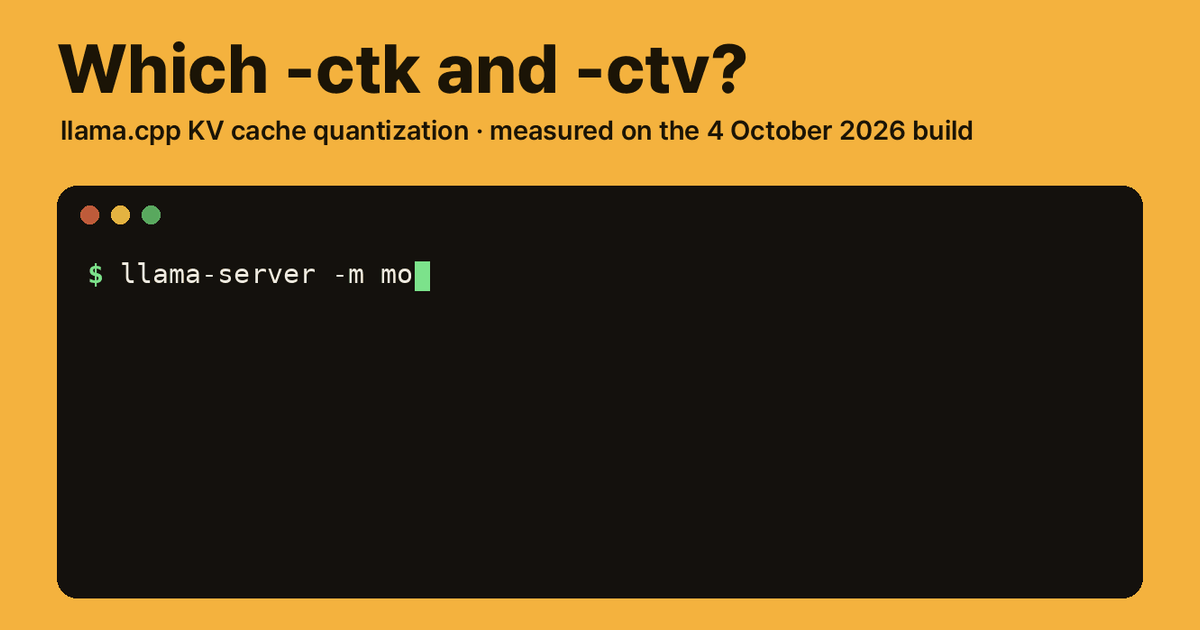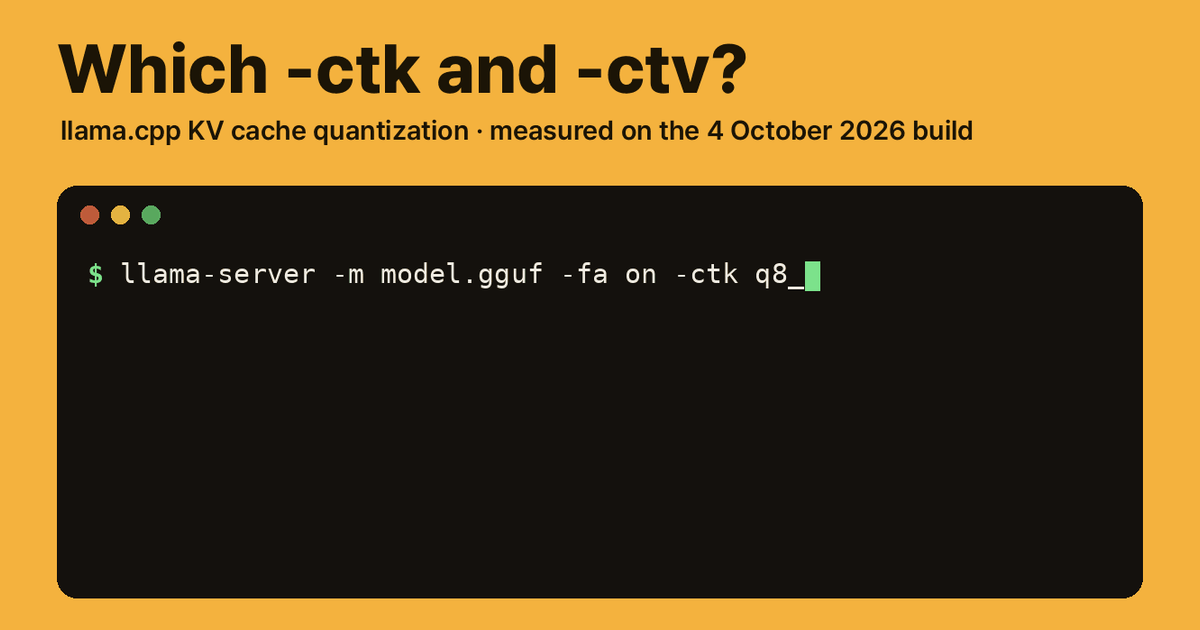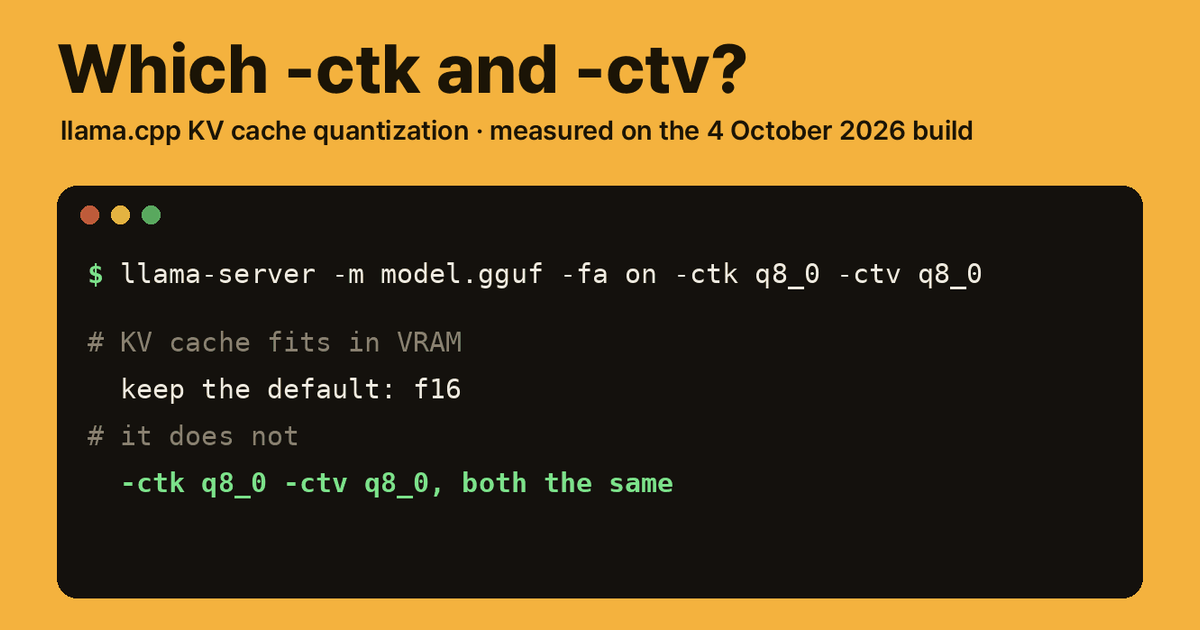
それでも、切替と再利用は進んでいるようです。キャッシュの保存と復元を組み合わせ、64 TPSに到達した例も紹介されています。さらに、llama.cpp向けの42倍の高速化を掲げる記事もあり、コスト削減の鍵として注目されています。話題は「モデルを速く読み直す」から「KV cacheをどう残し、どう壊さないか」へ移っています。TokiRecurのようなKV cacheの再利用[1]やスリープとウェイク[4]が重要で、–cache-ramの正しい理解[6]や圧縮による速度コスト[7]も、セットで見る必要があります。
引用ソース
- Hacker News Hacker News: TokiRecur – llama.cpp LLM launcher with KV-cache recycling — https://github.com/lhadzic377-netizen/TokiRecur
TokiRecur – llama.cpp LLM launcher with KV-cache recycling
- Web記事 記事全文: Memory Management and KV Cache | ggml-org/llama.cpp | DeepWiki — https://deepwiki.com/ggml-org/llama.cpp/3.6-memory-management-and-kv-cache
This page explains the memory management system in llama.cpp, focusing on key-value (KV) cache mechanisms, recurrent and hybrid memory models, Independent Sliding Window Attention (ISWA), DeepSeek V4 (DSV4) compressed ca
- X Xトレンド: Soranji — https://trends24.in/japan/
Soranji
- Hacker News Hacker News: Swapping LLMs in Under Two Seconds: A Sleep Mode for Llama.cpp — https://zaage.it/writing/llama-sleep/
Swapping LLMs in Under Two Seconds: A Sleep Mode for Llama.cpp
- Web記事 記事全文: How to Optimize llama.cpp for Maximum Inference Speed in 2026 — https://docs.bswen.com/blog/2026-03-15-llamacpp-optimization-speed/
How to Optimize llama.cpp for Maximum Inference Speed in 2026
I once watched a 27B model crawl along at about 3 tokens per second on an RTX 3090.
The GPU was decent. The model was quantized. I was using llama.cpp. Yet th - Web記事 記事全文: Understanding –cache-ram in llama.cpp: Prompt Caching, Eviction Errors … — https://jessequinn.info/blog/llama-cpp-cache-ram-prompt-caching
← Back to Blog
This post documents a debugging session that started with mysterious KV cache eviction errors on my llama-server and ended with a clearer understanding of what –cache-ram actually does, how it interacts w - Web記事 記事全文: llama.cpp KV Cache Quantization: Which -ctk and -ctv to Use, Measured … — https://sotaaz.com/post/llamacpp-kv-cache-quantization-guide-en
llama.cpp KV Cache Quantization: Which -ctk and -ctv to Use, Measured on the Current Build
Short answer. If the KV cache fits in VRAM, leave it at the default f16. If it does not, use -ctk q8_0 -ctv q8_0. Set both flags - Web記事 Web検索: Your local LLM forgets its cache after every restart. I measured how … — https://huggingface.co/blog/vimalnakrani/stillwarm-kv-cache-persistence
Your local LLM forgets its cache after every restart. I measured how …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。



RECENT COMMENTS