8GBのGPUで35B MoEが約35 tok/s(トークン/秒)。そんな報告がRedditのr/LocalLLaMAに上がりました[1][5]。話題はBigMoeOnEdgeです。MoEは、専門家と呼ばれる部品を必要な分だけ使うモデルです[4]。llama.cppというローカルLLMの実行基盤が読み込めるMoEモデルなら、そのまま使えます。量子化の種類を問わず動きます。量子化は、重みを圧縮してメモリを節約する仕組みです[1][4]。NVIDIA、AMD、Intel、Mac、スマホ、CPUだけで動かせるという点が注目されています[1][4]。Xでは「AIメカ」がトレンド語として上がっています[3]。
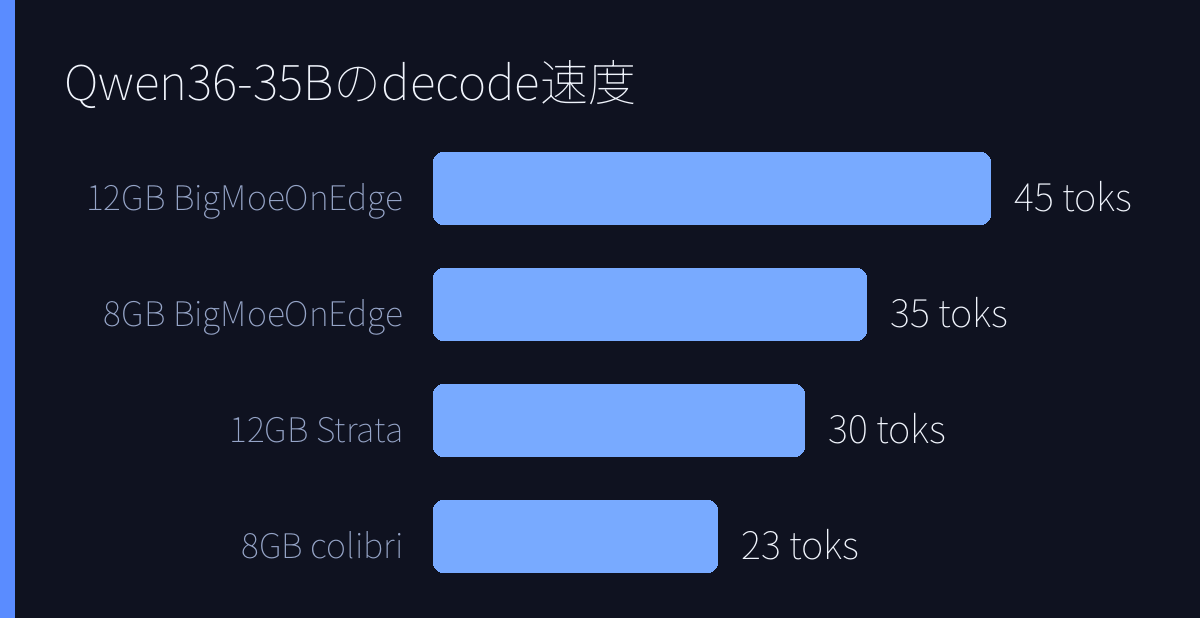
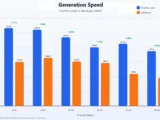
投稿では、8GBカードでQwen3.6-35Bを動かしたとき、8GB BigMoeOnEdgeは約35 tok/s、8GB colibriは約23 tok/sでした[1][5]。Strataは16kコンテキスト(長い文章を扱う範囲)で起動しなかったとされています[1][5]。12GBカードでは同じモデルで、12GB BigMoeOnEdgeは約45 tok/s、12GB Strataは約30 tok/sでした[1][5]。長いプロンプトではprefill(プロンプト全体を一括処理する段階)の遅延が差になりました。8GBカードで最初のトークンの生成までBigMoeOnEdgeが約5秒、Strataが約14秒、colibriは約2分でした[1][5]。
MacやCPUでも試されています。16GBのMacBookではQwen3.8-Flash-Next 125Bが約10 tok/s、Strataは約7 tok/sでした[1][5]。2021年製ThinkPad、GPUなし、16GB RAM、CPUのみでは、Q4_K_Mのような量子化モデルで988行を約2.3 tok/sで生成した例があります[4]。ここでの速度はdecode(トークンを1つずつ生成する段階)です[4]。
仕組みは単純です。一部のエンジンは少数のモデルとGPU向けに最適化して速さを狙いますが、BigMoeOnEdgeはllama.cppの公開API(外部から使える仕組み)を使い、見つけた機械向けに自分で計画します[2]。MoEはトークンごとに使う専門家が少ないため、必ず使う重みとよく使う専門家だけをメモリやVRAM(GPUのメモリ)に置き、残りはflash(フラッシュ)から読みます[4]。出力はllama.cppと同じとし、品質を落とさないとしています[1][4]。自動設定(–auto)で機械に合うキャッシュ量、スレッド数、GPUとCPUの分担を決めます。オプションを細かく選べなくても使えるとされています[1][4]。
ただし、BigMoeOnEdgeが常に最速とは限りません。2026-11-10時点のGitHubの比較文書では、Strataが最適化された環境では上回るとされています[2]。例として12GBカード、RTX 3060級、15コアのZen 2 CPU、47GB RAMでQwen3.6-35B-A3BのUD-Q4_K_XLを256トークン試した結果、Strataは20スレッド環境で58.5〜59.7 tok/sを公表しています[2]。Strataは多くの専門家をCPUで計算し、この比較では15コアのZen 2 CPUとDDR4メモリが制約になったと説明されています[2]。GitHubの比較文書は、設定が異なるため順位づけより桁感として読むべきだと注意しています[2]。Strataは12GB VRAMの消費者GPUで125B+ MoEを動かすことをうたっています[7]。参考として、RTX 4090では消費電力550W、回収433日といったコスト試算も公開されています[6]。また、BasaltはRTX 50が必要で、この投稿の8〜16GB環境では動かしにくいとされています[1]。
つまり話題の核心は、単に速いエンジンが増えたことではありません。所有しやすい8〜16GB GPU、Mac、CPUで、既存のGGUF(llama.cpp向けのモデルファイル)をそのまま使える点です[1][4]。一方で、最適化されたGPUやCPU構成ではStrataが有利な場合もあり、環境選びは残ります[2][6][7]。ローカル推論は、モデルの大きさより、メモリ・flash・CPUをどう流すかというhacker的な設計の工夫が速さを決める面もあるようです[2][4]。
引用ソース
- Reddit Reddit r/LocalLLaMA: BigMoeOnEdge outperforms Strata and colibri on 8-16 GB cards and Mac and you can run any model — https://www.reddit.com/r/LocalLLaMA/comments/1xx5fng/bigmoeonedge_outperforms_strata_and_colibri_on/
BigMoeOnEdge outperforms Strata and colibri on 8-16 GB cards and Mac and you can run any model
- Web記事 記事全文: BigMoeOnEdge/docs/comparison.md at main – GitHub — https://github.com/Helldez/BigMoeOnEdge/blob/main/docs/comparison.md
How BigMoeOnEdge compares
The engines below all run mixture-of-experts models larger than a GPU’s memory on hardware people
own. They make different trade-offs: some write their own kernels for a few models on a few GPUs - X Xトレンド: AIメカ — https://trends24.in/japan/
AIメカ
- Web記事 記事全文: GitHub – Helldez/BigMoeOnEdge: Run MoE models bigger than your RAM … — https://github.com/Helldez/BigMoeOnEdge
English · 中文 · 日本語 · Español · Français · Italiano
Run Mixture-of-Experts models larger than your device’s memory. The experts are read from flash as the model needs them. Android, iOS, macOS, Windows and Linux, built on - Web記事 記事全文: BigMoeOnEdge outperforms Strata and colibri on 8-16 GB cards and Mac … — https://www.datasciencewire.com/story/bigmoeonedge-outperforms-strata-and-colibri-on-8-16-gb-cards-and-mac-and-you-can-567da61b
Hi! for those who might not know the solution: it takes any MoE GGUF llama.cpp can load, whatever the quant. No repacking, no special format it runs on whatever you have: NVIDIA, AMD, Intel, Mac, a phone, or just the CPU
- Web記事 記事全文: Local LLM hardware benchmarks and cost · Strata — https://www.stratat.com/en/benchmarks
Hardware benchmarks
Pick a GPU and see what it costs to run — and how long until it pays for itself.
How you’ll use it
29 GPUs · Dual cards need case room and enough power supply.
Selected hardware
RTX 4090
24 GB · singl - Web記事 Web検索: Strata LLM – Run 125B+ MoE Models on 12GB VRAM Consumer GPUs (Docs & Setup) — https://stratallm.org/
Strata LLM – Run 125B+ MoE Models on 12GB VRAM Consumer GPUs (Docs & Setup)
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS