llama.cppを取り巻く動きが広がっています。依存ライブラリなしの2.6MBのJARで動くJVM推論スタックが、CPU上でllama.cppに匹敵すると主張。AndroidのAdreno GPUで動かすチュートリアルや、スマホとノートPCで巨大MoEを流す拡張も現れました。ただし比較数値は乏しく、検証はこれからです。
llama.cppを取り巻く動きが広がっています。依存ライブラリなしの2.6MBのJARで動くJVM推論スタックが、CPU上でllama.cppに匹敵すると主張。AndroidのAdreno GPUで動かすチュートリアルや、スマホとノートPCで巨大MoEを流す拡張も現れました。ただし比較数値は乏しく、検証はこれからです。
Browser Use出身の開発者が、2012年製PCをサーバーにしてエージェントを動かす「Mainplane」を公開しました。負荷0.02で4週間連続稼働し、道具はシェルとファイル操作だけの最小構成です。ローカルで記憶を持たせる試みも相次ぎ、エージェントの置き場所を個人が設計する流れが見えてきます。
Qwen 3.8 Flash Next(125B MoE)を8GBのGPUで動かす検証が相次いで報告されています。全体の約3割を占めるn-gram参照テーブルをシステムRAMに置く構成で、decode毎秒30〜36トークンを達成。量子化やMTPなど速度と品質のトレードオフも実測で見えてきました。
NousResearchのAIエージェント「Hermes Agent」は、2026年4月時点で95.6Kのスターを集め、第三者テストで8.2/10の評価を得ています。本記事では、複数の入り口と70以上のツールという設計の広がり、評価の内訳や実測数値がまだ見えない現状を素材に基づき整理します。
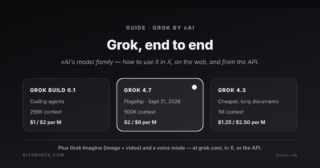
xAIのGrokは9月21日にフラッグシップをGrok 4.7へ更新しました。50万トークンのコンテキストと4段階の推論レベルを備え、価格は前モデルと同じ入力2ドル/出力6ドルです。一方で安価なGrok 4.3は100万トークンと上回るなど、用途別の使い分けが鮮明になりました。
AlibabaがQwen 4に先駆けて公開したQwen3.8-Flash-Nextをめぐり、ARC-AGI-3コンペの勝利予報と冗談めいた「データ送信」投稿が同時に話題です。プレビューはMoE+n-gramメモリテーブル設計で、ローカルの目安は現行27BのBF16約54GB〜4ビット16GBです。
OpenAIが視覚推論とPC操作に強い新型「GPT-6.1 Terra」を発表。エージェント試験で旧モデルより15ポイント高く、価格はGPT-6 Astraの10分の1、速度は3倍です。一方でローカル完結のオープンソース代替HobもHacker Newsで議論され、クラウドとローカルの二極化が鮮明になっています。
OpenAIがGPT-6.1 Terraを公開。コーディングベンチマークTerminal-Bench 4.0で前世代の21.5%から50.3%へ倍増し、API価格は半減、タスク完了時間も3分の1未満になりました。一方でモデルの異常行動をめぐる報告と反論、安全性分析の新知見も議論されています。
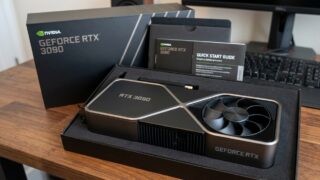
2020年に1499ドルで発売されたRTX 3090が、2026年も購入ガイドやベンチマーク検証の対象になり続けています。CUDAコア10,496個、24GB GDDR6Xという構成の詳細に加え、PassMarkで1万7000件超の実測サンプルが集積。ゲーム性能では割高だった発売時の評価と、大容量メモリを軸とする現在の位置づけを整理します。
Dotsファミリーの大規模MoE「dots.llm1」の設計と公開方針を整理しました。142B中14Bだけを動かす構造に加え、合成データなしの事前学習でQwen2.5-72Bに並ぶ性能と、学習全過程の中間チェックポイント公開が特徴です。日本語非対応と実測値の不足が課題として残ります。
2026.11.03
続・Hermes追跡(15):ベンチマークと自己進化ループ
2026.11.03
続Grok Bot追跡:AIチームメイトとhackerの壁
RECENT COMMENTS