llama.cppでFFNのゲート/アップ計算とGLUを1つにまとめるCUDA最適化PRが話題です。DGX SparkではLlama-3.1-8Bのprefill速度が最大10.7%向上、RTX 5090でも数%の改善が報告されました。CUDA Graphsなど周辺の最適化の動きも合わせて解説します。
llama.cppでFFNのゲート/アップ計算とGLUを1つにまとめるCUDA最適化PRが話題です。DGX SparkではLlama-3.1-8Bのprefill速度が最大10.7%向上、RTX 5090でも数%の改善が報告されました。CUDA Graphsなど周辺の最適化の動きも合わせて解説します。
NVIDIAのGPU「Blackwell」は2080億トランジスタ・2ダイ構成・FP4対応を公表。Blackwell Ultraはattention層2倍・AI演算1.5倍です。2026年度Q4の売上高は681億ドルで過去最高、AI半導体は73%増。データセンターと4GBエッジの両極を支える構図がわかります。
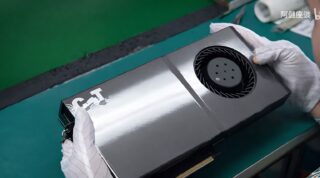
生産終了の噂のRTX 5090が、中国の工房に数百枚並ぶ様子が公開されました。技術者がGPUチップと32GBのGDDR7メモリを剥がし、AIサーバー向けの独自基板に組み替えています。輸出規制下でも流入が続く背景が注目されています。
NVIDIAの小型モデル「Nemotron 3.5 Bolt E4B」の続報。前モデル比で品質約40%向上、競合比で出力トークン最大約80%削減と発表されました。推論のON/OFF制御やDFlashによる高速化、BF16版と4GB量子化版の配布など、ローカルエージェント向け設計を整理します。
中国でRTX 5090を解体し、AIサーバー向けに組み直す工房の映像が話題です。GPUとGDDR7メモリを別基板に載せ替える作業が大規模に行われており、輸出規制で絞られた5090D(2375 AI TOPS)より標準版(3352 AI TOPS)が狙われたと報じられています。
買い占めで市場から消えたRTX 5090で、ローカルLLM推論の実測が相次いで公開されています。Qwenモデルでプロンプト処理約1万トークン/秒、27BモデルはMTP高速化で最高67.87トークン/秒を記録。エンジンと設定の選択が性能を左右する一方、カード価格は定価の3倍超が続いています。
NVIDIA未発売のRTX 3080 20GB改造カードが中国で登場し、AI向け性能制限を解除するツールでの動作も確認されました。2枚構成の実測でprefillが+20%改善、decodeは0%。規格外カードとコミュニティ製アンロックの組み合わせが注目されています。
NVIDIA RTX 5090が米主要店舗の在庫から消え、第三者価格は発売時の1999ドルから6500〜9500ドルに急騰しています。香港メディアの写真では中国のAIサーバー組立現場に小売箱が積まれており、AI需要がゲーミングGPUを吸い上げる実態が浮き彫りになりました。
RTX 3090でBF16テンソル演算が1.9倍速くなるというLinuxカーネルモジュールの報告が話題です。ベンチマークでは82→155 TFLOPSと倍近く伸びましたが、実際の推論は10〜12%の向上にとどまりました。ベンチと実用の差が数値でわかる記事です。
NVIDIAがエージェント向け検索の新モデル「Nemotron 3.5」(Embed 1B/8B、Rerank 8B、Parse)を公開しました。あわせてOpenShellの詳細も判明し、検索とセキュリティの両面でエージェント基盤を整える動きが見て取れます。
2026.11.11
続・RTX 3090、2026年の中古で24GBとNVLinkが再評価される
2026.11.11
続・Qwen4、4種とFlashが示すローカル実行の行方
2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
RECENT COMMENTS