「量子化は品質を落とす」というイメージが、Qwen3.8-27Bでは少し変わってきました。KVキャッシュの量子化を、KLDという出力分布の変化の指標で測った実験が、Redditで話題です。KVキャッシュは、AI(人工知能)の推論中にモデルが覚える中間データです。35種類の重み量子化を、llama.cpp、ExLlamaV3、vLLMというローカル実行エンジンで試し、16bit、8bit、対応する場合は4bitのKVキャッシュを比較しました[1]。
結果は明快で、8bit KVキャッシュでは、llama.cppとExLlamaV3でキャッシュサイズが半分になり、KLDはほぼ変わりませんでした[1]。vLLMでも差は少しあるものの、VRAMが足りない人には良い落としどころだと言います[1]。KLDは元のモデルと比べて出力の傾向がどれだけずれるかを見る指標で、実験では、Qwen3.8-27B自身に作らせたツール実行の会話や、分野の異なる文章を混ぜ、1行あたり最大64kトークンの文脈まで扱ったとされています[1]。
Hacker Newsでは、次のトークンを先に予測して生成を速くするMTPという仕組みが注目されています。Qwen3.8-27Bで6bitの重みに4bitの予測ヘッドを組み合わせると、6bit単体より速く、受理率も同じように見えるという報告があります[2]。コメントでは、同じ会話を何度も再生した実験で、4bitヘッドの受理率が6bitやフル精度と同じように見え、RAMを節約できたとされています[4]。
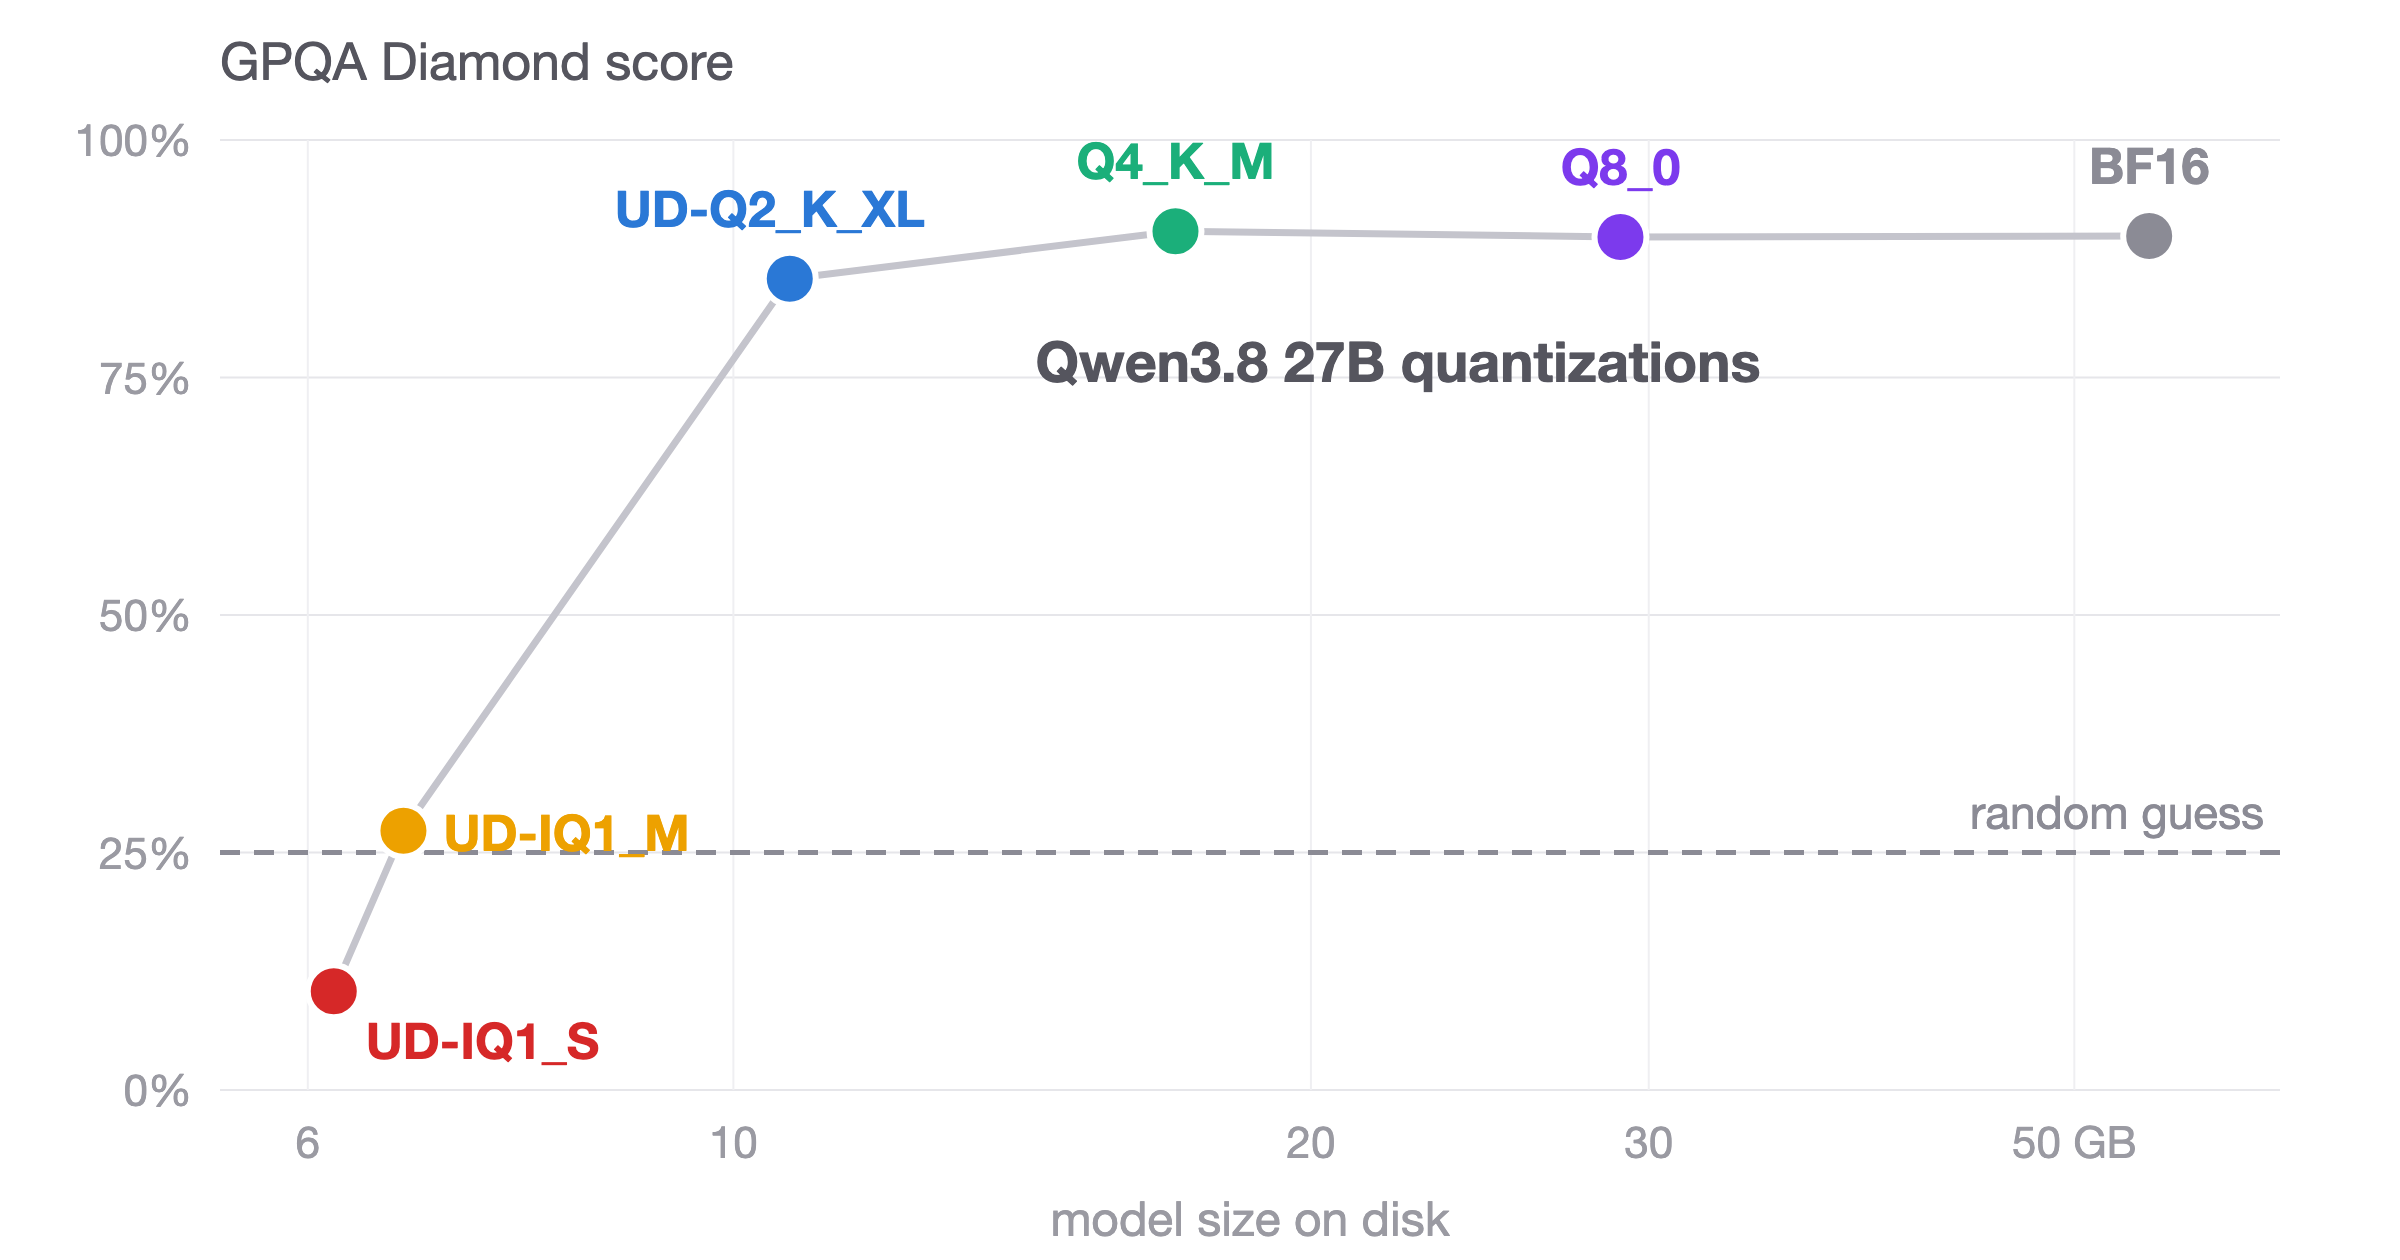
重み量子化そのものも、ベンチマークが進んでいます。Qwen3.8-27Bは画像と動画も扱うマルチモーダルモデルで、公開後3週間でHugging Faceで約13.8Kのいいねと525万DLを集めたとされています[3]。フル精度モデルは55GBで、多くのコンシューマGPUでは重いですが、17GBの4bit量子化はTerminal-Bench 2.1(コーディングのベンチマーク)でフル精度と並ぶ結果を出したと報告されています[5]。RTX 4090のような24GBカードに収まり、約64kトークンの文脈も残ると説明されています[5]。なお、このベンチでは重みと別に16bitのKVキャッシュを使い、32kトークンで約2.3GBを消費したとされています[5]。ただし1bitではGPQA Diamond(知識推論のベンチマーク)がほぼランダムに近く、推論を長くするほど悪化したとされています[5]。
16GB GPUでの実測結果も出ています。RX 9070 XTとRyzen 7 7800X3Dのマシンで、17GBの4bit量子化と別の4bit系量子化を、MTPの有無で比較しました[6]。Flash Attention(注意機構の計算を速くする仕組み)を有効にし、全層をGPUに載せる設定で、最も速い設定ではほぼ42トークン/秒に達し、64Kコンテキストに到達したとされています[6]。ただしllama-serverはモデルファイルをメモリマップするため、約13GBのシステムRAMを使います[6]。マシンのメモリ計画が必要になります。
アーキテクチャの工夫も効いています。Qwen3.8-27Bは64層のうち48層が線形アテンション、16層がフルアテンションという混合構造です。線形アテンションは計算量を抑えた注意機構で、KVキャッシュに効くのは主に16層だと説明されています[7]。これにより262,144トークンの長文脈でも、競合よりVRAMを抑えやすいとされています[7]。24GB GPUでは4bit量子化で6〜7GBをKVキャッシュに残せるという目安もあります[7]。
ただし、速度と品質の線引きは単純ではありません。Air APIはフル精度を提供し、公式には、FP8がフル精度に近い性能と省メモリを両立するとされています[3]。検索結果にも、低精度形式とMTPの速度比較や、5段階の量子化での速度とメモリ比較、ローカル実行のVRAMと速度テストが並んでいます[8]。セッションやツール実行のような長時間のAI推論では、KLDが小さくても実際のタスクで崩れる場合があるため、ベンチマークと自分のワークロードの両方を確認する必要があります。
続報として見ると、Qwen3.8-27Bの量子化は「全部を粗く圧縮する話」から「どこを圧縮するか」の話に変わっています。8bit KVキャッシュと4bit重みは現実的な候補ですが、1bitや極端な圧縮はタスクによって崩れます。Flash AttentionやMTPのような速度機構と組み合わせるなら、受理率とRAM節約のバランスを、自分のマシンで試す価値があります。
引用ソース
- Reddit Reddit r/LocalLLaMA: Effects of KV Cache Quantization on Qwen3.8 27B — https://www.reddit.com/r/LocalLLaMA/comments/1xqbesv/effects_of_kv_cache_quantization_on_qwen38_27b/
Effects of KV Cache Quantization on Qwen3.8 27B
- Hacker News Hacker News: Qwen3.8-27B MTP Q4S head on Q6 quant is faster than q6, f16 slower = acceptance — https://github.com/alainnothere/llama.cpp/commit/77b124a7ab56e0f1c33c025344a9c63465a9a87f
Qwen3.8-27B MTP Q4S head on Q6 quant is faster than q6, f16 slower = acceptance
- Web記事 記事全文: Qwen3.8-27B Benchmarks: Throughput, Latency and KV Cache — https://www.aieev.com/post/qwen3-8-27b-benchmark
Qwen3.8-27B Benchmarks: Throughput, Latency and KV Cache
Sep 9
11 min read
Hello, I’m Yongrae Cho. I work on AI infrastructure R&D on the AIEEV development team.
Air API now serves the Qwen3.8-27B-BF16 model. The Air API - HNコメント HNコメント: en3.8-27B MTP Q4S head on Q6 quant is faster than q6, f16 slower = acc — https://news.ycombinator.com/item?id=50409349
I've been running a lot of experiments, from repeat yourself to extending ngram mod to store the ngrams across conversations and reboots, at least under the conversation that I have been replaying again and again an
- Web記事 記事全文: Benchmarking Qwen3.8 27B quantizations: 4-bit holds up, 1-bit collapses — https://quesma.com/blog/qwen38-27b-quantizations-benchmarked/
How much GPU RAM do you actually need to run Qwen3.8 27B without sacrificing quality?
The full BF16 model weighs 55 GB, putting it beyond most consumer hardware.
Yet the 17 GB Q4_K_M matches the full model on a popular a - Web記事 記事全文: Squeezing Qwen 3.8 27B into a Single 16 GB GPU — Almost 42 tok/s, 64K … — https://ataadevs.net/blog/qwen-3-8-27b-llamacpp-benchmarks.html
In my previous post, Run Qwen 3.8 27B on Windows with ROCm, I set up Qwen 3.8 27B on an AMD GPU — building llama.cpp from source for maximum throughput. The setup works. The question this post answers is a different one:
- Web記事 記事全文: Running Qwen 3.8 27B Locally: GGUF Performance, KV Cache Optimization … — https://explore.n1n.ai/blog/running-qwen-3-8-27b-locally-gguf-kv-cache-optimization-2026-08-15
– Authors
– Name
– Nino
– Occupation
– Senior Tech Editor
The release of Qwen 3.8 marked a significant milestone in the open-weights ecosystem, arriving with two distinct flavors that serve very different - Web記事 Web検索: Fastest Qwen3.8 27B Quantization? Benchmarking NVFP4, INT4, GSQ, and MTP — https://kaitchup.substack.com/p/fastest-qwen38-27b-quantization-benchmarking
Fastest Qwen3.8 27B Quantization? Benchmarking NVFP4, INT4, GSQ, and MTP
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS