「1枚のRTX 5080でQwen3.8 Flash-Nextが速い」という報告が、AIやhacker界隈で話題です。Redditでは、RTX 5080と64GB RAMの構成で、エージェント型コーディングのセッション中に250トークン/秒超のdecode(生成)を掲げ、実測では平均195.6トークン/秒、prefill(読み込み)は約5700トークン/秒と報告されています[1]。Xでは「AI暴走」[3]や「AIバブル崩壊」がトレンドに上がっています。
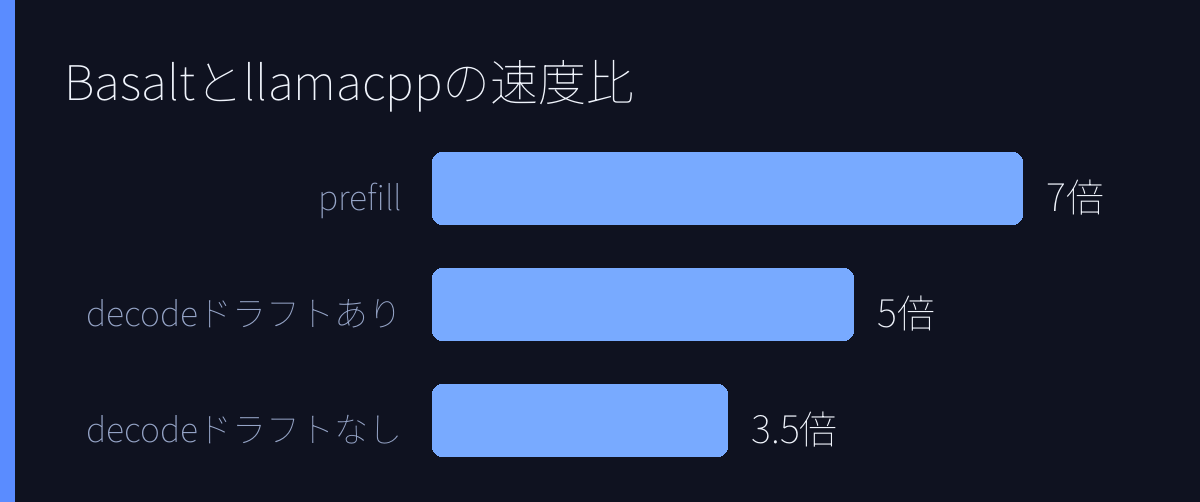
この報告で主役となるのはエンジンです。同じモデルファイル、同じPCで、Basaltはllama.cppよりdecode(ドラフトなし)が約3.5倍、decode(ドラフトあり)が約5倍、prefillが約7倍速いと報告されています[1]。ドラフトは候補を先に作る仕組みで、prefillはプロンプト全体を一括処理する段階、decodeはトークンを1つずつ生成する段階です。実測はopencodeの151リクエスト、最大202Kコンテキストで行われ、最高263トークン/秒、最低156トークン/秒でした[1]。
構成も具体的です。RTX 5080 16GBは定格360Wで、オーバークロックやアンダボルトはしていません。CPUはCore Ultra 9 285K、メモリは2x32GB DDR5-7200、PCIe 5.0 x16、Fedoraです[1]。量子化(重みを圧縮してメモリを節約する仕組み)にはUnslothのUD-IQ3_XXSを使い、16GBカードで定番の同サイズ量子化より精度が上がったとされています。wikitext perplexity(低いほど迷いにくい指標)は3.382から3.247へ改善し、ほぼ元の精度である3.273に近づきました。速度は1〜3.5%犠牲になります。さらにLaminaというMTP drafter(候補を先に作って本モデルが検証する仕組み)を使うと、ドラフトの採用率が増え、品質は本モデルが全トークンを検証するため変わらないと報告されています[1]。
評価サイトでは、Qwen3.8-Flash-Nextは総合56.1/100、216モデル中64位、速度55トークン/秒、初回トークン38.14秒、コンテキスト262Kと表示されています[5]。カテゴリではマルチモーダル13位、エージェント87パーセンタイル(同じ分類での位置)、コーディング72パーセンタイル、指示追従85パーセンタイルです[5]。ただし公開ベンチの行は25件で、空欄もあるため、数値の厚みには注意が必要です[5]。別の評価ページでは該当する行が見つからないものもあり、同じモデル名でも証拠の量は均一ではありません[6]。
しかし、同じRTX 5080でも「速い」とは限りません。Qwen3.8 27Bを4bit量子化で搭載すると、重み16.5GBが実効14.4GBを超え、部分的にシステムRAMへ逃がす前提で推定10トークン/秒、初回約0.5秒とされています[2]。エージェント型コーディングに体感30トークン/秒が必要だとすれば、かなり厳しい数字です[2]。Flash-Nextについては、4bit量子化で8Kコンテキスト時に109.7GB必要と推定し、16GBでは不可とするページもあります[6]。Flash-NextはMoE、つまり全部の重みを一度に使わない構造です[6]。総パラメータと実動作の重み配分は単純比較しにくいようです。
ユーザーの不満も出ています。Redditでは、Qwen3.8-27Bが最近使えなくなったという投稿があります。当初はRTX 4090のllama.cppで複雑なタスクもこなせたのに、基本タスクの失敗や指示の忘却、重いタスクを途中でやめるようになったという報告です[4]。投稿者は量子化や意図的な性能低下を疑っていますが、原因は発表資料からは確定できません。Qwen3.8の話題は、単に「どのモデルが強いか」ではなく、「自分のPCで、どの構成なら実用に足るか」になっています。現在のところ、Flash-Nextを16GBだけで動かす簡易な公式手順は発表資料では確認できません。ガイドにあるような64GB RAMと専用エンジン前提の構成が、ローカル推論の現実的な一歩になりそうです[1]。
引用ソース
- Reddit Reddit r/LocalLLaMA: [GUIDE] Qwen3.8 Flash-Next on a single RTX 5080 + 64GB RAM: >250 tok/s tg and 5700 tok/s prefill in real agent coding sessions (Basalt + new Unsloth UD-IQ3_XXS + Lamina drafter),+ how it compares to llama.cpp — https://www.reddit.com/r/LocalLLaMA/comments/1xomy0i/guide_qwen38_flashnext_on_a_single_rtx_5080_64gb/
[GUIDE] Qwen3.8 Flash-Next on a single RTX 5080 + 64GB RAM: >250 tok/s tg and 5700 tok/s prefill in real agent coding sessions (Basalt + new Unsloth UD-IQ3_XXS + Lamina drafter),+ how it compares to llama.cpp
- Web記事 記事全文: Can You Run Qwen3.8 27B on RTX 5080? (2026) – modelfit.io — https://modelfit.io/can-i-run/qwen3.8-27b-q4-on-rtx-5080/
Can you run Qwen3.8 27B on RTX 5080?
Qwen3.8 27B Q4_K_M on the NVIDIA GeForce RTX 5080: verdict, VRAM math and estimated speed.
– VRAM
– 16 GB(14.4 usable)
– Model weights
– 16.5 GBQ4_K_M
– Decode speed
– est. 10 tok/sro - X Xトレンド: AI暴走 — https://trends24.in/japan/
AI暴走
- Reddit Reddit r/LocalLLaMA: Qwen3.8-27B has become unuseable recently — https://www.reddit.com/r/LocalLLaMA/comments/1xoeeyf/qwen3827b_has_become_unuseable_recently/
Qwen3.8-27B has become unuseable recently
- Web記事 記事全文: Qwen3.8-Flash-Next Benchmarks & Speed (November 2026) — https://benchlm.ai/models/qwen3-8-flash-next
Decision snapshot
Each value carries a field reference instead of floating alone. Markers compare this model with the current ranked and priced catalog; they are not absolute quality thresholds.
Capability
56.1/100
field - Web記事 記事全文: Can I Run Qwen3.8-Flash-Next on RTX 5080? | LLM Configurator — https://llmconfigurator.com/en/can-i-run/qwen3-8-flash-next-on-rtx-5080
Can I Run Qwen3.8-Flash-Next on NVIDIA GeForce RTX 5080?
Written by Jakub Rusinowski · Last updated September 29, 2026
No. Qwen3.8-Flash-Next needs 109.7 GB at 8K context (108.7 GB weights + 1 GB KV cache/overhead) at Q4 - Web記事 記事全文: Qwen3.8-Flash-Next Benchmark Scores & Evals | BenchmarkList — https://benchmarklist.com/models/qwen-qwen3.8-flash-next/
Cost vs score
Measured run cost from each benchmark’s own leaderboard, log scale. One benchmark per chart — costs are never compared across tabs.
Benchmark results
No matching rows.
- Web記事 Web検索: No — Qwen3.8 Flash Next (MoE) is too large for a NVIDIA RTX 5080 (16GB) — https://canirunthisllm.com/can-i-run/qwen3-8-flash-next/on/rtx-5080-16/
No — Qwen3.8 Flash Next (MoE) is too large for a NVIDIA RTX 5080 (16GB)
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS