📌 エグゼクティブサマリー
Qwen3最小モデル0.6BをMoE構造に変換する試みがローカルコミュニティで話題です。Qwen3は共有エキスパートを持たず品質維持が難しく、疑似共有エキスパートで対処しました。公式レポートはthinkingモード統合や多言語対応29から119への拡大を示しています。
0.6Bという最小クラスのモデルが、ローカルコミュニティで改造されています。Redditのr/LocalLLaMAに投稿されたのは「Qwen3-0.6BをMoE化した」という報告です[1]。MoEとは、必要な専門家(エキスパート)だけを動かして計算量を減らすモデル構造のことです。Qwen3シリーズは0.6Bから235Bまでのスケールを、dense(全パラメータを使う通常構造)とMoEの両方でそろえています[2]。公式のGitHubリポジトリも公開されており、誰でも中身を確かめられます[8]。
投稿者は以前からQwen 2.5系のMoE化を続けてきた人物で、今回が初めてのチャット形式モデルの変換でした[1]。前回の変換後も新しい手法をいろいろ試したものの、ほとんどはうまくいかず、互換性が最大の制約になったと振り返っています[1]。そこで今回はGGUF(ローカル推論で広く使われる重み形式)との互換性を最優先しました。できるだけ多くの人に使ってもらう形を狙ったといいます。その代わり、一部の改善の余地は犠牲になったと本人が認めています[1]。
変換の過程では、予想外の壁も出ました。前世代Qwen 2.5のMoEには「共有エキスパート」があり、重要なニューロンを常に動かしておくことで品質を保てました。ところがQwen3のMoEにはこれがありません。そのため変換後に品質がかなり落ちたといいます[1]。投稿者は「疑似共有エキスパート」を試すなど、新たな工夫で対処したと報告しています[1]。
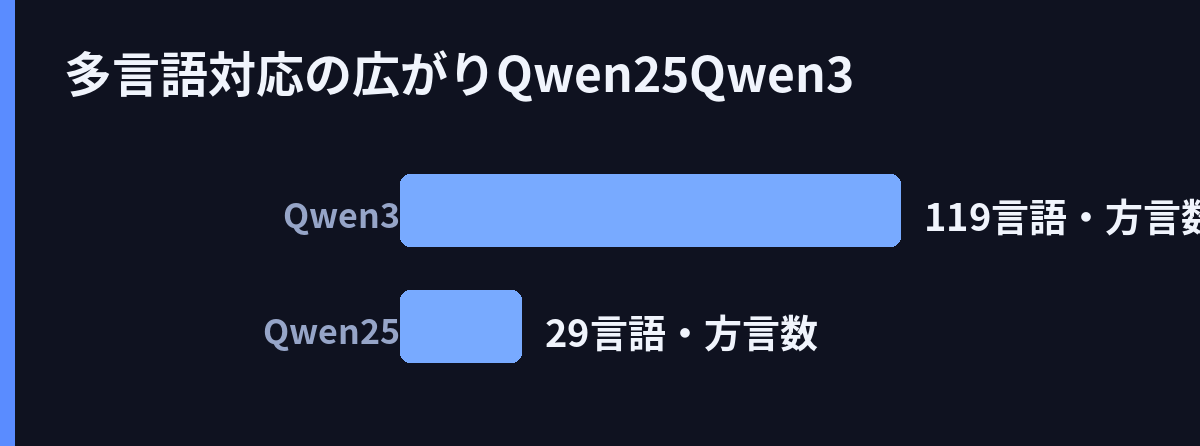
公式の技術レポートからも、このシリーズの設計思想が読み取れます[2]。Qwen3の特徴は、複雑な推論用のthinkingモードと、即答用のnon-thinkingモードを1つのモデルに統合したことです。従来はチャット最適化モデルと、推論特化モデルを使い分ける必要がありました。レポートは後者の例としてQwQ-32Bを挙げています。Qwen3では質問に応じて動的にモードが切り替わります。さらにthinking budgetを備えます。これは思考に使う計算量を予算のように調整する仕組みで、タスクの難しさに応じて遅延と性能のバランスを取れます[2]。多言語対応は前世代の29から119の言語・方言へと4倍以上に広がり、全モデルがApache 2.0で公開されています[2]。
評価のやり方も整備が進んでいます。Hugging Faceの公式ディスカッションでは、EvalScopeというツールを使った評価のベストプラクティスが共有されました[5]。速度ベンチマークに加え、コード・理解・指示追従・数学などの能力を測るベンチマーク群をまとめて試せます。thinkingの効率、つまり「どれだけ考えてどれだけの性能が出るか」も測定項目です。結果はGradio(ブラウザ操作で動かせるUI)で可視化もできます[5]。性能ベンチマークを整理したDeepWikiのページも用意され、シリーズ全体の立ち位置を確かめやすくなりました。

コード特化のQwen3-Coderも動きがあります。解説サイトはこれを「Alibabaのオープンなエージェント型コーディングLLM」と紹介し、GitHubには専用リポジトリが公開されています[7]。コミュニティからは「Qwen 3.8 Flash Next Gyro Coder」のGGUF版が出たとの報告もあり[4]、ISTA labsのコーダー版との違いが早速比べられています[4]。派生モデルのバリエーションが増えるのは、土台の人気の表れと思われます。
しかし、小ささには代償もあります。Artificial AnalysisはQwen3 0.6Bをnon-reasoning(推論モードをオフにした状態)で分析しており[6]、最小モデルの実力がどこまで届くかは慎重な見極めが必要です。MoE化の挑戦も壁にぶつかりました。共有エキスパートを失ったことで品質維持が難しくなったのです[1]。投稿者は「完璧主義のおかげでようやくもう1つ公開できた」と綴っており、品質を落とさない変換への苦労がうかがえます[1]。公式がフラッグシップの知識で小型モデルを作る手法を明記する一方[2]、コミュニティの手による改造は試行錯誤の連続のようです。
Xの日本のトレンドには「パーソナルAIエージェント」という語が上がっています[3]。中身は素材からは読み取れませんが、AIを個人の手で動かす関心の高さを感じさせる語です。235Bの頂点から0.6Bの末端まで、Qwen3は両端を同時に進めています[2]。性能を追求する大型と、改造や検証の実験台になる小型。その両方があるからこそ、ユーザーは目的に合うモデルを選び、時に手を加えて使えます。0.6BのMoE化が次のバージョンでどこまで品質を戻せるか、注目していきたいと思います。
RECENT COMMENTS