📌 エグゼクティブサマリー
オープンウェイトモデルKimi K3がClaudeに迫っています。14のベンチマークはFable 5が8勝、K3が6勝の接戦で、コーディングの公開スコアはOpus 5が70.8対58.9と優位です。K3は単価約3分の1で攻め、Claude側はキャッシュ価格を75%下げて対抗しました。
「自転車に乗るペリカンを、高精細に描いて」。このひとつの命令が、ClaudeとKimi K3の実力を比べる定番の題材になっています。以前この連載では、Claude内のモデル選び(Opus 5.5が標準、Fable 5.1は難問向け)を取り上げました。今回はその後の展開として、外から迫る挑戦者Kimi K3との比較を整理します。
きっかけのひとつは、Reddit r/LocalLLaMAへの投稿です。投稿者はMoonshotのKimi K3.1 Proに、デフォルトのthinking(max)設定でペリカン課題を試しました。コンテキスト(一度に扱える文章量)の使用は約16万トークンです。実行にはPi.devというハーネス(評価用の実行環境)を使っています[1]。できあがった結果は「Opus 5よりは上」ながら、公開時のOpus 5.5やastra 6とは依然差があるという評価でした。投稿者は「さらに思考を増やせば改善した可能性がある」とも書いています。コメント欄には改良版が次々と追加されました。オープンウェイト(誰でもダウンロードして動かせる)モデルの3D理解が大きく進んだ、というのが投稿者の見立てです[1]。なお、比較先のOpus 5.5の結果はClaude Codeで作られたもので、実行環境は異なります[1]。
ベンチマーク全体の成績は、もっと接戦です。14項目を並べた比較記事によると、Claude Fable 5が8勝、Kimi K3が6勝。Fable 5は難易度の高いエンジニアリング、専門知識を要する業務、視覚推論でリードしています。一方のK3は、長時間続くエージェント型コーディング、ターミナル操作、Web調査で勝ちました[2]。エージェントとは、指示をもとにAIが自律的に作業を進める形式のことです。公開から48時間で解説動画は二分され、「K3がFableを圧倒した」と「本当に勝ったのか」が並びました。同記事は「どちらの主張も特定のベンチマークについては正しく、全体としては誤り」と整理しています[2]。
コストの差も、具体的な数字で動いています。K3のトークン単価はFableの約3分の1です[2]。これに対しAnthropicは、Fable 5.1(2026年9月1日公開)で基本価格を入出力100万トークンあたり10ドル/50ドルのまま維持しました。その一方で、キャッシュヒット時の価格を100万トークンあたり1.00ドルから0.25ドルへ、75%引き下げています[2]。キャッシュは、同じプロンプトの一部を再利用して課金を減らす仕組みです。繰り返しの多いエージェント業務では、ここでコスト優位を盛り返した形になります。なお、K3対Fable 5.1の新しいスコアカードはまだ出ておらず、14項目の表はFable 5公開時の数値のままです[2]。
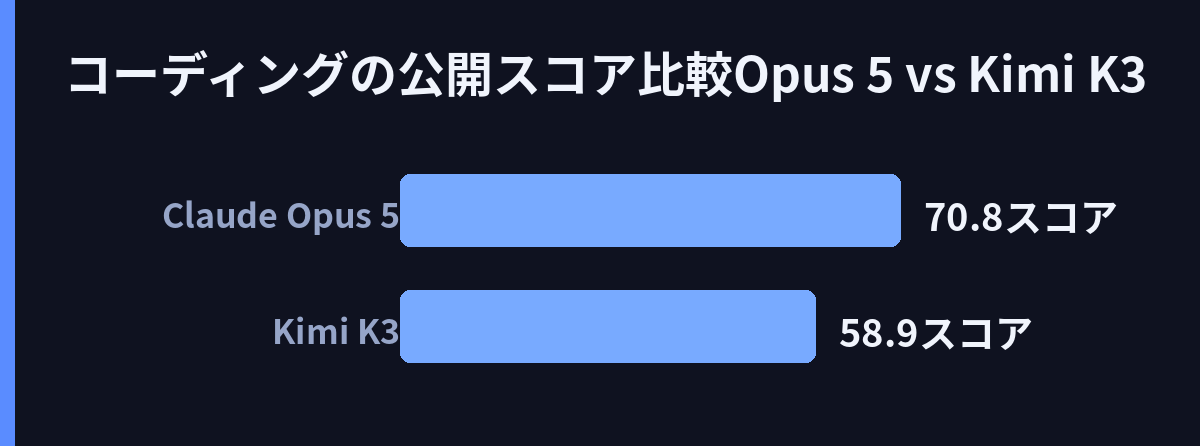
しかし、コーディングの指標では差がはっきり残ります。BenchLM.aiの比較では、Claude Opus 5の公開コーディング推定値は70.8。Kimi K3は58.9で、約12ポイントの開きです[4]。同サイトは、条件付きの数値幅からは順位を確定できない旨も添えています[4]。ペリカン課題でも、Opus 5.5との差は「まだ大きめ」とされました[1]。難問とコーディングの頂点は、まだClaude側にあるようです。
この比較の熱気自体が、いまの流行を映しています。7月時点のOpus 5対K3の検証記事[5]や、2026年の決着を扱う総括[7]など、同種の比較が複数公開されました。いずれも「Kimi K3対Claude」という同じ枠組みで、関心の高さがうかがえます。Opus 4.6以降の「エージェントシフト」を追う解説[6]や、Claudeエージェントの構築・運用ガイド[8]も出ています。日本のXでは「パーソナルAIエージェント」がトレンド語に入りました[3]。モデル比較の関心は、AIエージェントを自分の作業に取り込む流れとつながっていると思われます。
まとめると、勝敗はタスク次第で入れ替わります。長時間のエージェント作業とコストならK3、難問・専門業務・視覚推論ならFableという分担です。オープンウェイト側の進歩は速く、ペリカン課題でも差は縮まりつつあります。それでも最上位モデルとの壁は残り、Claudeはキャッシュ値下げで応戦しました。用途とコストで使い分ける時代が、さらに鮮明になったといえます。
RECENT COMMENTS