llama.cppの話題が、単純な速度比較から中身の説明へ向かっています。Hacker Newsでは、単一JARで依存なしにローカル推論でき、llama.cppより速いと主張する投稿がありました[1]。Web側では、コアライブラリの構造や量子化の解説が見られます[2][5][6][7]。派手なflash(高速化)の話より、どう動くかを説明する記事が目立ちます。ローカルLLMを自分の環境で使う流れは、AIチャットや知識管理とつなぐ例も出ています[4]。
まず内部構造です。llama.cppは層状に作られています[2]。土台にはGGMLというテンソルライブラリがあります。テンソルとは、モデルの重みを扱うための数値の箱です。GGMLはハードウェアに依存しない形でテンソルを置き、GPUやCPUなどの計算バックエンドへつなぎます[2]。計算バックエンドとは、実際に計算を担う部分です。この層があるため、同じモデルを異なる環境で動かす道筋が作られています。計算グラフとは、テンソル演算をどの順で実行するかを示す設計図です[2]。
その上で、モデル読み込みはGGUFファイルを解析し、重みをメモリへ写します。GGUFはローカルモデル向けのファイル形式です。読み込みではメモリマッピングを使い、ファイルを直接参照する形が示されています[2]。メモリをロックして動作を安定させる仕組みにも触れられています[2]。推論の中心にはコンテキストがあります。コンテキストは、推論の状態をまとめる部品です。入力バッチ、メモリ管理、計算グラフの実行をまとめています[2]。公開Cインターフェースは、外部から呼べる安定した入口です。モデル読み込み、トークン化、バッチ処理、状態管理などを扱えます[2]。トークンの列をモデルに渡す流れも、この入口から扱えます。
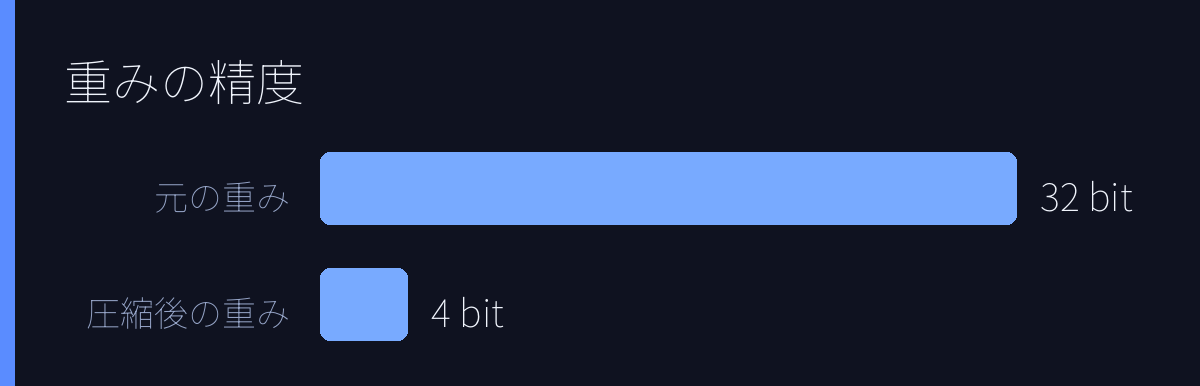
量子化も重要です。量子化とは、重みを圧縮してメモリを節約し、推論を速くする仕組みです[5]。llama.cppでは、32bitの浮動小数点で持っていた重みを、4bitの整数へ落とすことを想定しています[5]。すべての重みを一枚岩で扱うのではなく、テンソルをブロックに分けます。各ブロックには重みと、スケールなどの補助情報が入ります[5]。補助情報があるため、圧縮した重みでも元の値に近い形に戻せます。量子化はツールで行い、GGMLのテンソル変換機能を使います[5]。古い方式から新しい方式まで幅があります[5]。
たとえば4bit方式のQ4_0では、32個の重みを1ブロックにし、16bitのスケールを1つ持ちます[5]。ブロック内の最大値からスケールを決め、各重みを丸めて整数にします。この処理により、メモリ上の形は小さくなりますが、実行時には元の計算に近づけるための逆変換も必要です[5]。すべての重みを同じ強さで圧縮するわけではありません。感度の高い層は高めに残す工夫があります[5]。埋め込み層を高い精度で保つ例も挙げられています[5]。imatrix(どの重みを大事に扱うかを示す情報)では、校正用データで重要度を計算します[5]。周辺記事では、この仕組みをGGUF向けに解説するガイドも出ています[6][7]。
使われ方も広がっています。Obsidian(メモアプリ)とAIチャットを結び、ベクトル検索(意味の近さで探す検索)やMCP、llama.cppを使うThreadShelfという投稿もありました[4]。MCPは、AIツールと外部のデータや機能を接続する仕組みです。ローカル推論を知識管理とつなぐ例として読めます[4]。ベンチマーク記事やエンジン比較記事、OpenBenchmarkingのllama.cpp性能テストも出ています[8]。2026年の比較ガイドは多数ありますが、素材本文には具体的な速度数値が示されていません[8]。OpenBenchmarkingのページも、数値そのものより性能テストの存在を示す素材です。
ただ、素材には速度の直接比較数値がありません。JVM単一JARが速いという主張[1]も、モデル・GPU・量子化・コンテキストの条件セットが示されていないため、llama.cppと同等条件で勝ったとは判断できません。Xでは「Gemini4Carbon」がトレンド語として上がっていますが、llama.cppとの関係を素材から読み取ることはできません[3]。以前取り上げた実測のような具体的なTPS(1秒あたりの生成トークン数)やVRAM(GPUのメモリ)の数字は、今回の素材には出ていません。速度の話は、条件が揃って初めて意味を持ちます。
今回の話題からわかるのは、llama.cppが「動く」だけでなく、どう動くかを説明できる点で注目されていることです[2][5]。量子化と内部構造の理解は、ローカルLLMの選定に役立ちます。選定では、量子化の型名より、メモリ量と品質のバランスを見る必要があります。一方で、本当に速いかは、同じ条件でのTPSやVRAMの数字が揃って初めて言えます。素材にはその数値がまだありません。今回の記事は、その不足を踏まえて、設計と量子化の入口を整理しました。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: Core Library Architecture | ggml-org/llama.cpp | DeepWiki — https://deepwiki.com/ggml-org/llama.cpp/3-core-library-architecture
This document describes the internal architecture of the libllama core library, focusing on how major components are organized and interact during model inference. It covers the foundational GGML tensor library, the infe
- X Xトレンド: Gemini4Carbon — https://trends24.in/japan/
Gemini4Carbon
- Hacker News Hacker News: Show HN: ThreadShelf – Obsidian and AI chats: vector search, MCP, llama.cpp — https://github.com/ChrystianSchutz/ThreadShelf
Show HN: ThreadShelf – Obsidian and AI chats: vector search, MCP, llama.cpp
- Web記事 記事全文: Quantization | aifoundry-org/llama.cpp | DeepWiki — https://deepwiki.com/aifoundry-org/llama.cpp/5.3-quantization
This document provides a technical deep dive into the quantization system of llama.cpp. Quantization is the process of reducing the precision of model weights (e.g., from 32-bit floating point to 4-bit integers) to decre
- Web記事 Web検索: Llama.cpp GGUF Quantization Guide: Optimize Local LLM Performance (2026) — https://decodesfuture.com/articles/llama-cpp-gguf-quantization-guide-2026/
Llama.cpp GGUF Quantization Guide: Optimize Local LLM Performance (2026)
- Web記事 Web検索: An Explanation of How llama.cpp Quantization Technology (GGUF) Works — http://kenji.blog/en/p/llama-cpp-quantization-gguf/
An Explanation of How llama.cpp Quantization Technology (GGUF) Works
- Web記事 Web検索: Benchmarking Local LLMs in 2026: Speed, Quality, Resource Usage — https://dasroot.net/posts/2026/04/benchmarking-local-llms-speed-quality-resource-usage/
Benchmarking Local LLMs in 2026: Speed, Quality, Resource Usage
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS