Xトレンドには「Gemini4Carbon」が上がっていましたが [3]、ローカルAIの話題ではllama.cppが基準として動き続けています。llama.cppとは、自分のPCやサーバーでAIモデルを動かすための推論エンジンです。最近では、これを置き換えるような主張や、比較のための記事が相次いでいます。話題は「どれが速いか」だけでなく、導入のしやすさ、連携、量子化の選び方へと広がっています。
Hacker Newsでは、依存関係なしの単一JVM JARでローカル推論ができ、llama.cppより速いと主張する投稿がありました [1]。反応は2ポイント、コメント1件と、まだ小さいです。JVMはJavaの仮想機械で、1つのファイルで動くのは導入の簡便さにつながります。一方、ObsidianとAIチャットを結び、ベクトル検索やMCP、llama.cppを使うツールも投稿されました [4]。MCPはAIと外部ツールをつなぐ仕組みです。こちらも1ポイント、コメント0件で、静かな出だしです。
具体的な比較では、M1 Max 64GBのMacで5つのローカル推論エンジンを試した記事があります [2]。短いQ&A、コード生成、長い文脈の要約、複数回の会話、同時リクエストという複数の作業を走らせ、実用の近さを見ようとしています。llama.cppとMagnitudeは同じGGUF形式で比べました。Localsと標準のmlx-lmは同じMLX形式で比べ、Ollamaとuzuはそれぞれの標準設定で測りました。GGUFとMLXは、モデルの重みを保存する形式の違いです。
この比較は、既存のOllamaと衝突しないよう、別のポートで裏で動くサーバーとして動かした点も丁寧に書かれています。試したモデルはQwen3.5-9Bで、メモリ節約のため4ビット量子化を使いました。4ビット量子化は、重みを圧縮してメモリを節約する仕組みです。記事には、9Bモデルを16ビット(圧縮していない精度)で動かすと18GB超のメモリが必要だとあります。27Bモデルはさらに重くなるため、64GBでも同時実行や長い文脈には余裕が限られ、9Bに絞ったようです。
ただし、記事の抜粋には具体的なTPS(1秒あたりの生成トークン数)や速度の数字は出ていません。代わりに重要なのは、同じ重みで比べる部分と、各エンジンの推奨設定で動かす部分を分けている点です。量子化の型や推測的デコードの構成が違えば、単純な速度比較は難しいからです。推測的デコードは、次のトークンを先に当てて生成を速める仕組みです。
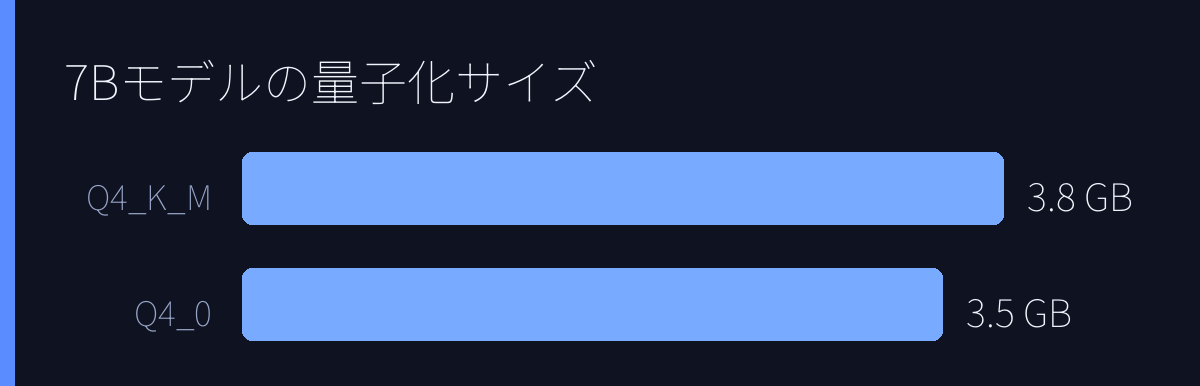
量子化の品質とサイズでは、7Bクラスの密なモデルで比較が示されています [5]。密なモデルは、すべての重みを使う通常のモデルです。新しい方式の4ビット量子化(Q4_K_M)は3.80GB、古い方式(Q4_0)は3.50GBです。新しい方式の予測のしにくさを示すperplexityの増分は+0.0535、古い方式は+0.2499です。perplexityは低いほど良い指標です。ほぼ同じサイズで品質の落ち込みが小さいため、推奨されやすいようです。llama.cppには、古い形式から、重要さを考慮した形式まで複数の世代があります。
この種の評価では、速度はGPUやドライバで大きく変わります。ビルド番号、コンテキスト長(一度に扱える文の長さ)、バッチサイズ(一度に処理する数)でも変わります。そのため、単一のTPSを万能の数字として出さない姿勢が目立ちます [5]。llama.cppは意味のあるバージョン番号を刻むのではなく、継続的にビルド番号が出るため、比較時はビルド番号を固定すべきとされています。公式のベンチマークの例や、自分で測る手順も重視されています。量子化の統一評価も論文や解説記事で進んでいます [6][7][8]。
一方、llama.cppとvLLMの使い分け、ローカルLLMの速度・品質・資源を比べる記事も出ています 。ここには、単に「速いエンジン」を選ぶより、用途で分けるという視点があります。vLLMはサーバー向けの推論エンジンとして知られていますが、素材には具体的な比較数値はありません。ローカル実行では、メモリに収まるか、導入が簡単か、連携できるかが大きな判断材料になります。意外なことに、話題の中心は「llama.cppを倒す」ことより、llama.cppを基準にしながら、導入の簡便さ、Obsidian連携、量子化の選び方、エンジン比較へと広がっています。JVM単一JARの主張は興味深いですが、HNの反応は小さく、詳細な条件も素材にはありません。今後の見通しは、同じモデル・同じ形式・同じビルドで測る再現性のある比較が、より重要になりそうです。
引用ソース
- Hacker News Hacker News: Local inferencing in one JVM JAR, dependency free, faster than llama.cpp — https://qxotic.ai/
Local inferencing in one JVM JAR, dependency free, faster than llama.cpp
- Web記事 記事全文: Comparing Five Local LLM Inference Engines on M1 Max: llama.cpp … — https://lilting.ch/en/articles/m1-max-llm-engine-benchmark
Contents
Claimed speeds for modern Mac inference engines like Magnitude, uzu, and Locals come from disparate hardware configurations, including M4 Pro, M5 Max, and M2 Max systems. This makes direct comparisons difficult - X Xトレンド: Gemini4Carbon — https://trends24.in/japan/
Gemini4Carbon
- Hacker News Hacker News: Show HN: ThreadShelf – Obsidian and AI chats: vector search, MCP, llama.cpp — https://github.com/ChrystianSchutz/ThreadShelf
Show HN: ThreadShelf – Obsidian and AI chats: vector search, MCP, llama.cpp
- Web記事 記事全文: llama.cpp Quantization Benchmark: Verified GGUF Data (2026) — https://markaicode.com/benchmarks/llamacpp-inference-benchmark/
Quick Answer: Across llama.cpp’s own quantization reference data for a 7B-class dense model, Q4_K_M sits at the trade-off sweet spot — roughly 3.80 GB with a perplexity increase of only +0.0535, far better quality-per-by
- Web記事 Web検索: Llama.cpp GGUF Quantization Guide: Optimize Local LLM Performance (2026) — https://decodesfuture.com/articles/llama-cpp-gguf-quantization-guide-2026/
Llama.cpp GGUF Quantization Guide: Optimize Local LLM Performance (2026)
- Web記事 Web検索: Which Quantization Should I Use? A Unified Evaluation of llama.cpp … — https://arxiv.org/html/2601.14277v1
Which Quantization Should I Use? A Unified Evaluation of llama.cpp …
- Web記事 Web検索: Which Quantization Should I Use? A Unified Evaluation of llama.cpp … — https://arxiv.org/pdf/2601.14277
Which Quantization Should I Use? A Unified Evaluation of llama.cpp …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。


RECENT COMMENTS