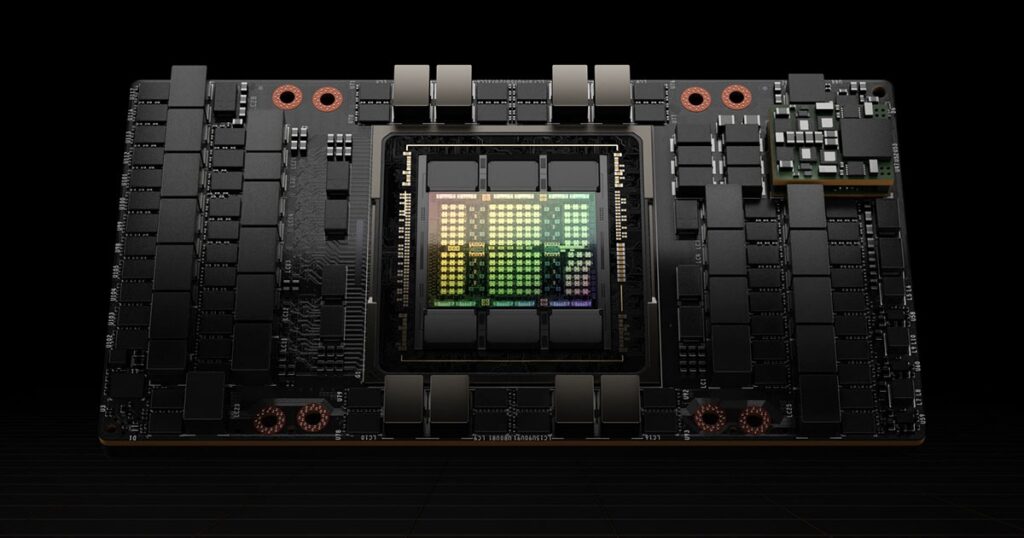
「30倍」の数字が、また動きました。前回取り上げたハッカーによるRTX解放はローカルAIの話題でしたが、今回はデータセンター向けの構成が中心です。NVIDIAはH100でLLM(大規模言語モデル)を最大30倍高速化し、推論でも最大30倍を掲げています[1]。公式データシートやNVL向けの資料、ホワイトペーパーも公開されており、仕様の裏付けを示しています[2][3][5]。
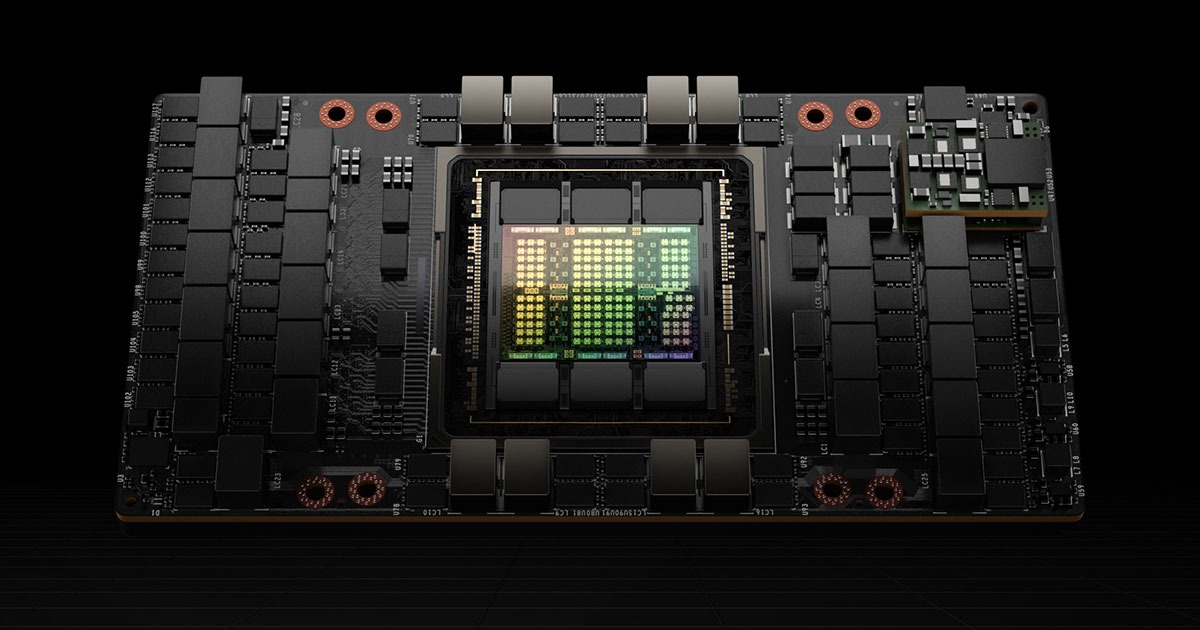
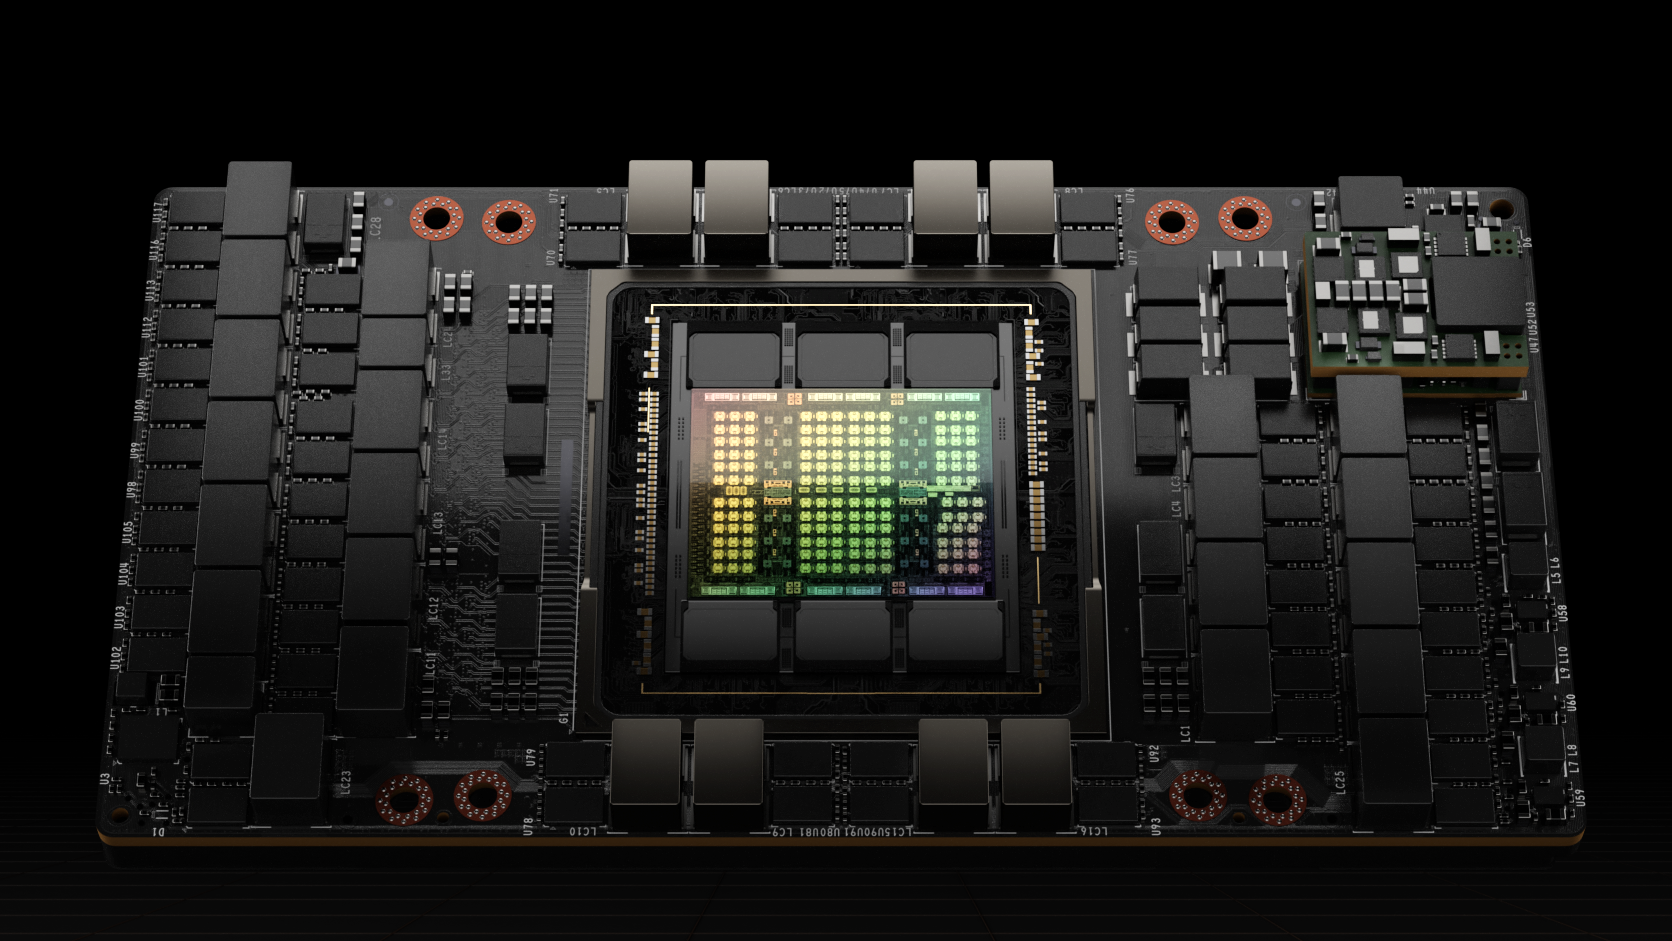
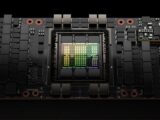
H100はHopperアーキテクチャの第9世代のデータセンターGPUです。A100との比較では、高速ネットワークのInfiniBand接続なら最大30倍、GPU同士を大規模につなぐNVLink Switch Systemではさらに3倍になる場合もあるとされます[4]。Transformer Engineは大規模言語モデル向けの計算を速くする仕組みで、FP8は重みを圧縮してメモリを節約する量子化の型です。両者を組み合わせてGPT-3 175B学習を4倍速くし、第四世代Tensor CoreはAI向けの計算回路としてFP64からFP8まで対応します[1]。第四世代NVLinkはGPU間で900GB/sを実現し、PCIe Gen5や高速ネットワークのNDR Quantum-2 InfiniBandと組み合わせ、小規模なサーバーから巨大なGPUクラスタまで拡張しやすくします[1]。
Grace Hopper Superchipは、CPUとGPUを1つにした製品です。ArmのGrace CPUとH100を900GB/sでつなぎ、PCIe Gen5より7倍速いチップ間接続を特徴とします。大規模モデルのAIとHPC(超大型計算)で10倍の性能向上を掲げています[4]。世代が上がるほど、GPU単体の速さより接続のボトルネックが重要になります。
ただし、数字は条件付きです。H100の性能は事前の期待値で、出荷製品では変わる可能性があります[4]。推論の待ち時間が一瞬で消えるとは言い切れません。BlackwellはAIベンチマークのMLPerf Training v5.1を席巻したと報じられますが、今回の記事では具体的なベンチマーク数値は示されていません[6]。
Blackwellについては、論文サイトのarXivやIEEE、ResearchGateで「Microbenchmarking NVIDIA’s Blackwell Architecture」が話題です[7][8]。マイクロベンチマークは、公式の「30倍」のような総合力ではなく、内部の細部を測るものです。データセンター向けの構成を組む側は、こうした検証を待ってから判断したいところです。
H100の30倍や4倍は、AIの学習と推論を大きく進める数字です。一方で、Blackwellの席巻を示す数値は、まだ見えていません。次の追跡では、実際のベンチマークや構成の差を、より具体的に確認できるとよさそうです。
引用ソース
- Web記事 記事全文: H100 Gpu | Nvidia — https://www.nvidia.com/en-us/data-center/h100/
NVIDIA H100 GPU
Extraordinary performance, scalability, and security for every data center.
An Order-of-Magnitude Leap for Accelerated Computing
The NVIDIA H100 GPU delivers exceptional performance, scalability, and secu - Web記事 記事全文: PDF NVIDIA H100 Tensor Core GPU Datasheet | NVIDIA — https://dam-cdn.nvd.orangelogic.com/AssetLink/u5hh6fv4r7564i4y673484y3m20083nj.pdf
�t6�Wu �dgm��-�֨mEI�&� ʎ���3�J�!5�1�D�L��_�Mv�f��Q���ޑ��N8���:, �s�’9Ŷ#?y�͗�3W�(Ӥ]�c��eI<3�`7�ݐ”�,S��5[�<���,��(P�”V;EC��ό”#���1�ݪ,5 �dcma�-�hZ��/X���w����n�7Q�6F6��؝���V ‘M��sJ��� J\:`��. �Hr��:T
- Web記事 記事全文: PDF Nvidia H100 Nvl Gpu — https://www.nvidia.com/content/dam/en-zz/Solutions/Data-Center/h100/PB-11773-001_v01.pdf
J66�ɤ���ߞ8��B%�B%@��+���Tԙ��8�A%@��+���Tԙ��8�A%@��+���Tԙ�>T�Tԙ��8�A%@�Y*!� Y�VBJ$�DJB%�3G%��@%��$�”����k��8�1}% g T@ �+A��O�V������K*���8h��[ �S%0q�S#� *����Y\�=�V�>�
- Web記事 記事全文: NVIDIA Hopper Architecture In-Depth | NVIDIA Technical Blog — https://developer.nvidia.com/blog/nvidia-hopper-architecture-in-depth/
Today during the 2022 NVIDIA GTC Keynote address, NVIDIA CEO Jensen Huang introduced the new NVIDIA H100 Tensor Core GPU based on the new NVIDIA Hopper GPU architecture. This post gives you a look inside the new H100 GPU
- Web記事 Web検索: PDF NVIDIA H100 Tensor Core GPU Architecture – NVIDIA Whitepaper … – GitHub — https://github.com/tpn/pdfs/blob/master/NVIDIA%20H100%20Tensor%20Core%20GPU%20Architecture%20-%20NVIDIA%20Whitepaper%20(2023).pdf
PDF NVIDIA H100 Tensor Core GPU Architecture – NVIDIA Whitepaper … – GitHub
- Web記事 Web検索: NVIDIA Blackwell Architecture Sweeps MLPerf Training v5.1 Benchmarks — https://developer.nvidia.com/blog/nvidia-blackwell-architecture-sweeps-mlperf-training-v5-1-benchmarks/
NVIDIA Blackwell Architecture Sweeps MLPerf Training v5.1 Benchmarks
- Web記事 Web検索: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://arxiv.org/html/2512.02189v3
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth …
- Web記事 Web検索: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://arxiv.org/pdf/2512.02189
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS