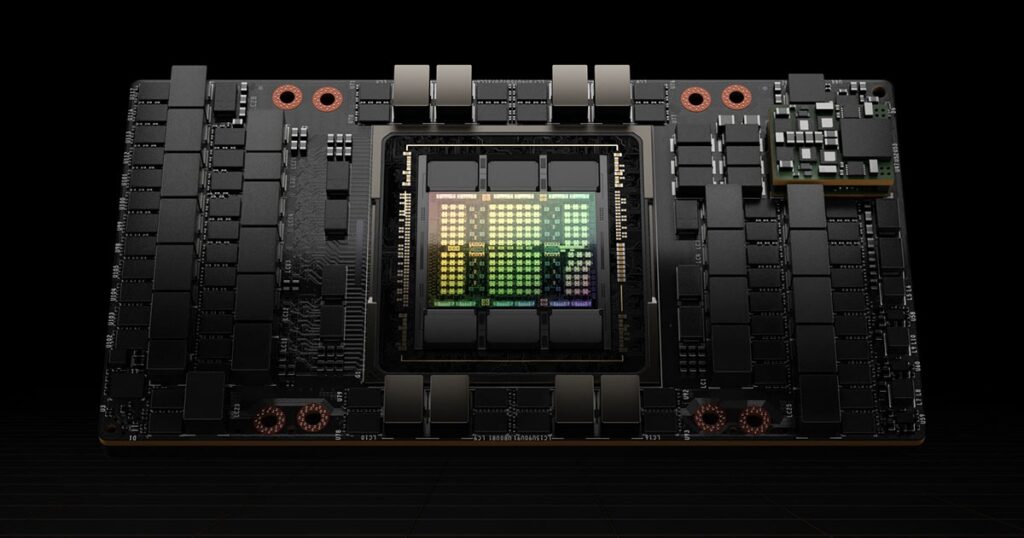
AIの学習と推論を速くするGPUの話は、また一段進みました。NVIDIAはBlackwellアーキテクチャがMLPerf Training v5.1の7モデルすべてで最速を記録したと発表しました[4][6]。前回はB200とH100の差を見ましたが、今回はH200との比較と、低精度のFP4に焦点を当てます。これはデータセンターの話で、ローカル実行の話ではありません。

まず基準となるHopper世代のH100を見ます。Transformer EngineとFP8(8ビットの浮動小数点)で、GPT-3 175Bの学習を前世代比で4倍にするとされています[1][5]。LLM(大規模言語モデル)は最大30倍高速化し、Transformer EngineはTransformerの計算を速くする仕組みです。推論でも最大30倍の高速化と低い遅延を掲げています[1]。GPU同士の接続は第4世代NVLink(GPU間接続)で900GB/sです。PCIe Gen5やInfiniBand(高速ネットワーク)も組み合わせます[1][5]。H100はセキュリティも掲げており、ハッカー対策を気にする読者にも関係します[1][5]。
H100はCPUとGPUの組み合わせでも拡張されています。Grace Hopper SuperchipはArmベースのGrace CPUとH100を組み合わせ、大規模モデルのAIとHPC(高性能計算)で10倍の性能を掲げています[2]。チップ間は900GB/sで、PCIe Gen5の7倍です[2]。さらにNVLink Switch Systemを使うと、InfiniBand構成のH100より場合によっては3倍の性能が出るとされています[2]。
Blackwellの話題は、ベンチマークのバージョンが変わったことで目立ちます。MLPerf Training v5.1は、AI学習の時間を測る業界ベンチマークです。Blackwellは7モデルすべてで最速の学習時間を記録しました。NVIDIAは、全項目で結果を出した唯一のプラットフォームだと説明しています[4][6]。最大スケールでも、提出された各スケールでも最高性能とされています[4]。
この速さの柱は、FP4(4ビットの浮動小数点)のハードウェア加速です。Blackwellでは、クロックあたりのFP4ピークスループットがFP8の2倍になります。Blackwell Ultraでは、その差は3倍になります[4]。NVIDIA独自のNVFP4という低精度データ形式は業界のMXFP4と比較され、同じトークン(文章の単位)数なら精度が良く、同じ精度なら少ないトークンで済むとされています[4]。
一方、論文のマイクロベンチマークでは、B200とH200を直接比較しています。第5世代Tensor Core(AI演算向けの回路)に加え、Tensor Memory(テンソル計算用のメモリ)、DE(解凍エンジン)、デュアルチップ(2つのチップ)も対象とし、行列積(GEMM)、Transformer推論、学習も評価しました。結果として、ResNet-50で1.85倍、GPT-1.3Bの混合精度学習で1.55倍のスループット(処理量)を報告しています[3][7]。電力効率はH200より32%良いとされています[3][7]。
ただし、数字には条件があります。H100の30倍や4倍は、ネットワークやモデル構成に依存する公式の想定です[1][2]。BlackwellのMLPerf結果も、提出された構成や対象モデルに依存します[4]。マイクロベンチマークでも、B200がすべての作業でH200より1.85倍になるわけではありません[3][7]。推論の待ち時間は、GPUとネットワークの組み合わせ次第で、一律に同じ速さにはなりません。
つまり今回の話題は、BlackwellがMLPerfで全項目を制したという発表です。H200比の実測差と、FP4の位置づけも示されました。Hopper世代が作った900GB/sの接続とTransformer Engineの枠組みを、Blackwellは低精度で伸ばしています[1][2][4]。AIの推論と学習をどこまで速くできるかは、GPU単体ではなく、ソフトウェアとネットワークの組み合わせで決まります。
引用ソース
- Web記事 記事全文: H100 Gpu | Nvidia — https://www.nvidia.com/en-us/data-center/h100/
NVIDIA H100 GPU
Extraordinary performance, scalability, and security for every data center.
An Order-of-Magnitude Leap for Accelerated Computing
The NVIDIA H100 GPU delivers exceptional performance, scalability, and secu - Web記事 記事全文: NVIDIA Hopper Architecture In-Depth | NVIDIA Technical Blog — https://developer.nvidia.com/blog/nvidia-hopper-architecture-in-depth/
Today during the 2022 NVIDIA GTC Keynote address, NVIDIA CEO Jensen Huang introduced the new NVIDIA H100 Tensor Core GPU based on the new NVIDIA Hopper GPU architecture. This post gives you a look inside the new H100 GPU
- Web記事 記事全文: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://arxiv.org/html/2512.02189v3
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth Architectural Analysis
Abstract
As GPU architectures rapidly evolve to meet the overcoming demands of exascale computing and machine learning, the performanc - Web記事 記事全文: NVIDIA Blackwell Architecture Sweeps MLPerf Training v5.1 Benchmarks — https://developer.nvidia.com/blog/nvidia-blackwell-architecture-sweeps-mlperf-training-v5-1-benchmarks/
The NVIDIA Blackwell architecture powered the fastest time to train across every MLPerf Training v5.1 benchmark, marking a clean sweep in the latest round of results. As developers experiment with new architectures, and
- Web記事 Web検索: PDF NVIDIA H100 Tensor Core GPU Architecture – Advanced Clustering Technologies — https://www.advancedclustering.com/wp-content/uploads/2022/03/gtc22-whitepaper-hopper.pdf
PDF NVIDIA H100 Tensor Core GPU Architecture – Advanced Clustering Technologies
- Web記事 Web検索: NVIDIA Blackwell Delivers Breakthrough Performance in Latest MLPerf … — https://blogs.nvidia.com/blog/blackwell-performance-mlperf-training/
NVIDIA Blackwell Delivers Breakthrough Performance in Latest MLPerf …
- Web記事 Web検索: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://arxiv.org/pdf/2512.02189
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth …
- Web記事 Web検索: Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth … — https://www.computer.org/csdl/proceedings-article/ipdps/2026/060200b026/2hJUx4SZ4Qw
Microbenchmarking NVIDIA’s Blackwell Architecture: An in-depth …
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。

RECENT COMMENTS