Qwenを巡る話題は、発表の速さより「自分のPCで使えるか」に移ったようです。RedditのLocalLLaMAでは、Strataとllama.cppを同じRTX 3060 12GBで比較した報告が目立ちます[1]。一方、Qwen3.8-27Bの体感低下を訴える投稿もあり[4]、評価と実運用の差が気になります。クラウド側ではqwen3.8-flashが1Mトークン対応で広がっています[2]。Xでは「AIバブル崩壊」[3]や「AIバブル」もトレンド語に上がっています。
比較では、prefill(プロンプト全体を一括処理する段階)とdecode(トークンを1つずつ生成する段階)を分けて測っています。同じPC、同じファイルで連続実行した報告では[1]、小型の密なモデルでは、llama.cppのprefillが速い傾向が続きます。例えばQwen3.5-2Bでは、RustingStrataが3859 tok/s、llama.cppが6080 tok/sでした[1]。
モデルがVRAM(ビデオメモリ)に収まらないと、Strataの強さが出ます。35B-A3Bではprefillが1539対1029、decodeが71.5対39.6で、Strataが上回りました[1]。80B-A3Bでもdecodeは63.7対33.3です[1]。177B版は63GBに量子化されました。量子化は重みを圧縮してメモリを節約する仕組みです。この177B版では、prefillが305対193、decodeが21.3対18.1でした[1]。Strataは12GB VRAMで125B超のMoEを動かすことを掲げており、MoEは必要な部分だけ動かす仕組みです。関連ドキュメントやベンチマークも出ています[6]。1000ドルのデュアル3060構成で、Qwen3.8 Flash Nextの量子化を試す記事もあります。
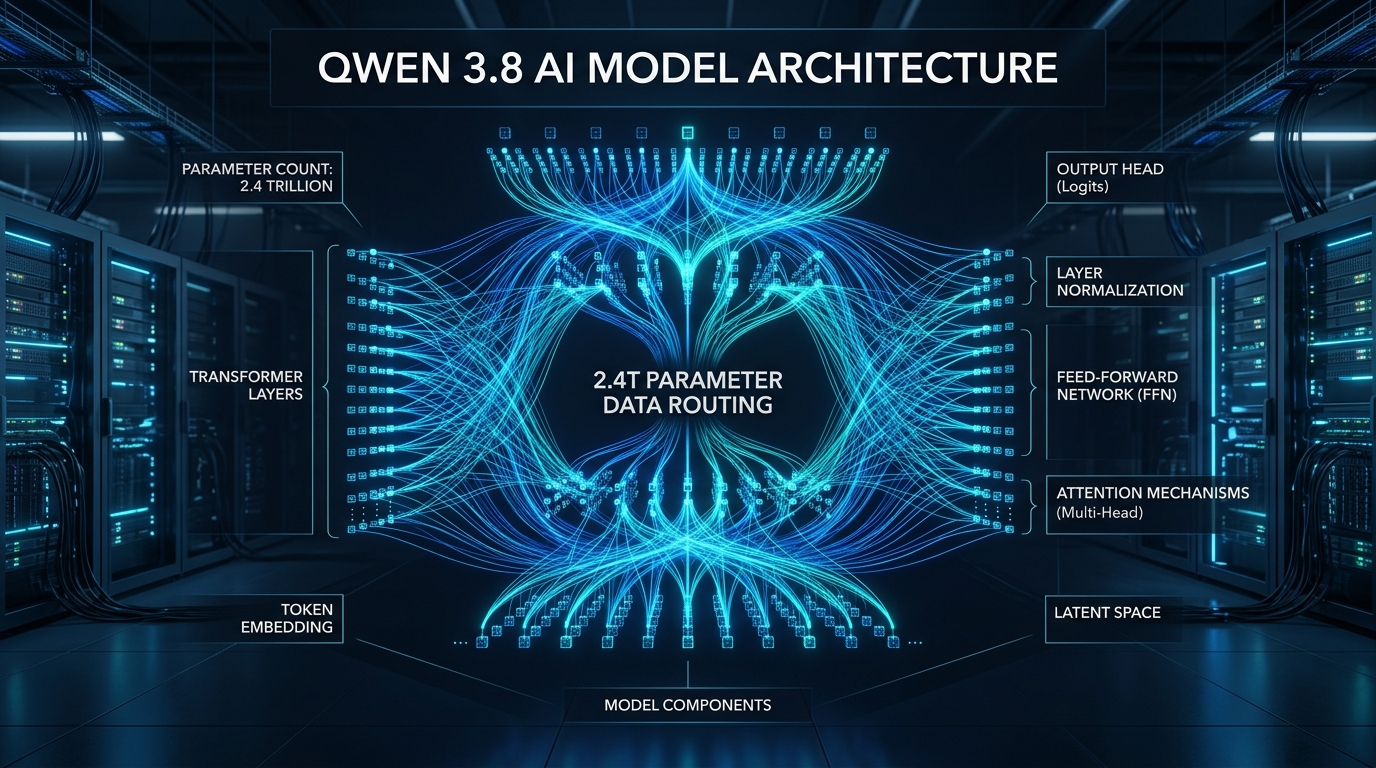
モデル公開の中心は27Bです。GitHubでは、Qwen3.8-27BがApache 2.0で公開されています[6]。262Kトークンのネイティブコンテキストを持ち、YaRNというコンテキスト拡張設定で1Mまで伸ばせると説明されています[6]。企業向け記事では、Qwen3.8アーキテクチャの重みは2026年8月10日の週から公開される予定とされています[6]。Qwen3.8-Maxは2.4Tパラメータでアクティブ95Bとされ、企業向けマルチGPUが前提です[6]。一方、量子化した27BはRTX 4090を2枚積んだ48GB構成やA100/H100で動作します。ローカル推論で60 tokens/secを超える例が挙げられています[6]。
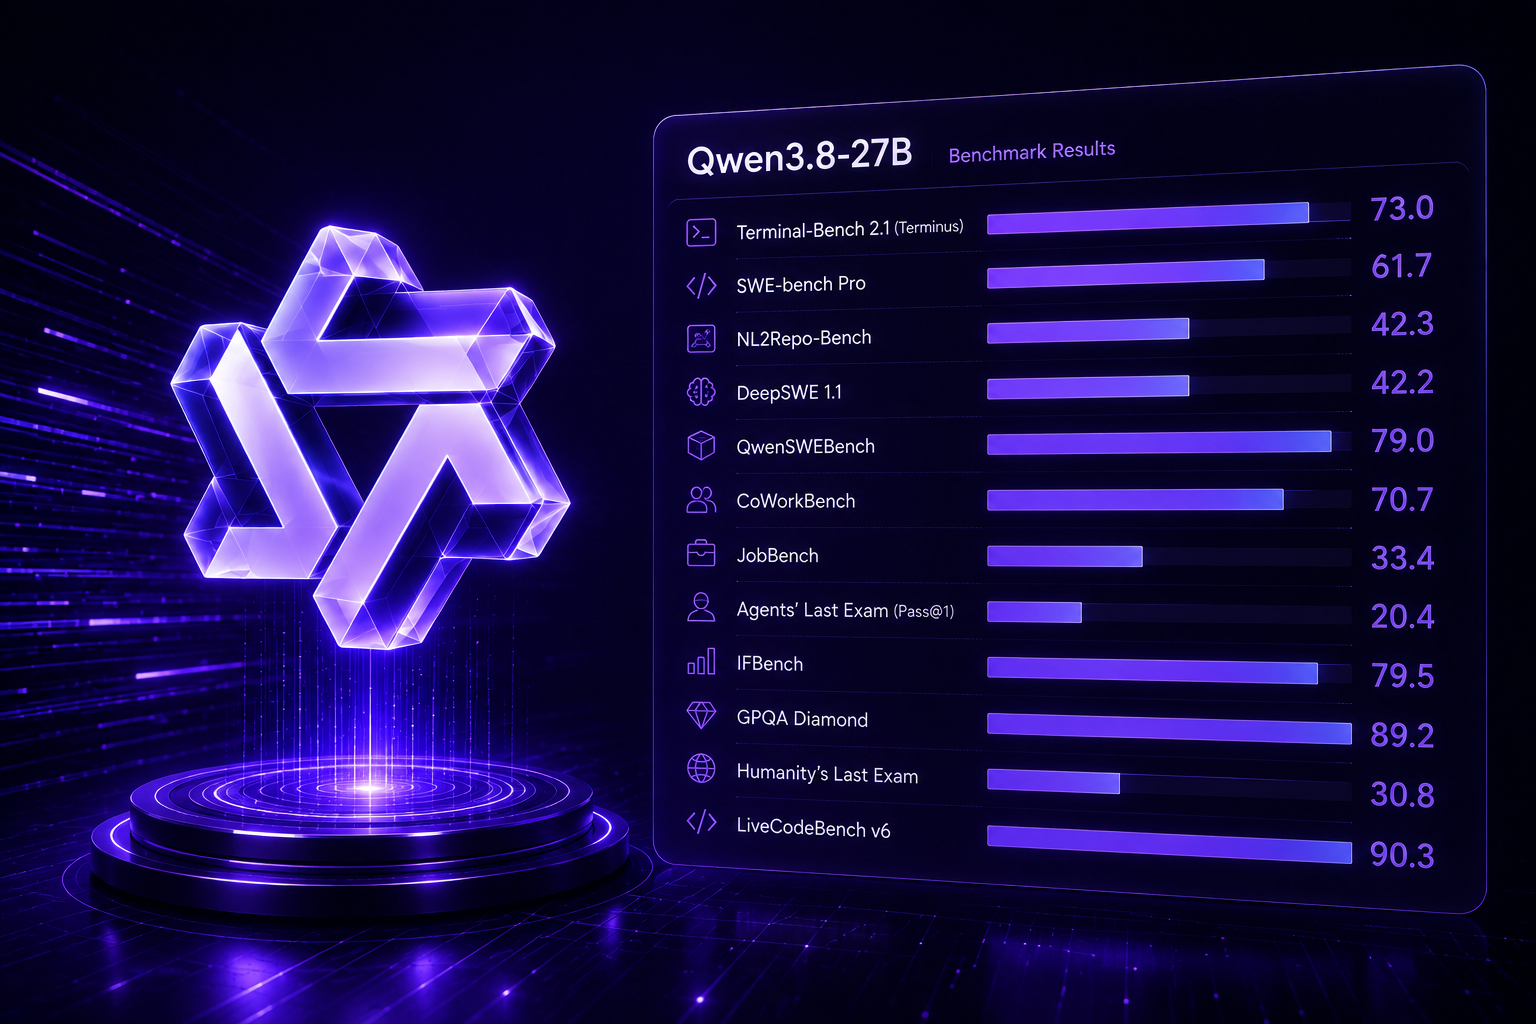
ベンチマークも派手です。公式評価では、前世代27B比でDeepSWE 1.1が13.3から42.2に伸びたとされます[5]。QwenSWEBenchは49.3から79.0に上がりました[5]。視覚エージェントではOSWorld-Verifiedが84.3、WebArena-Verifiedが64.8です[5]。独立評価では、Artificial AnalysisのIntelligence Indexの最大推論設定で52が注目されました[5]。公式評価ではSWE-bench Proで61.7も示されています[5]。
ただし、数字と体感は一致しません。Redditでは、Qwen3.8-27Bが以前はRTX 4090で複雑なタスクをこなせたと報告されています[4]。最近の動作では、基本タスクで指示を忘れる、怠けるといった不満も出ています[4]。投稿では、量子化されたせいではないかという疑いも書かれています[4]。記事側も、いくつかの評価は社内評価だと注意しています[5]。比較環境が完全に同じではないとされています[5]。
クラウド側は別方向に伸びます。QwenCloudでは、qwen3.8-flashがドイツと香港のデプロイで利用可能になりました[2]。テキスト生成、深い思考、視覚理解、関数呼び出し、構造化出力、コンテキストキャッシュを備えるとされています[2]。OpenAI/Anthropic API互換も特徴です[2]。音声では、262,144トークンのリアルタイム音声セッションモデルが追加されました[2]。音声・効果音・環境音をまとめて生成するTTS-Nextも出ています[2]。
つまり、今のQwenは、APIの大型化とローカル実行の両立が試されている段階です。27BはApache 2.0で触りやすく、StrataはVRAM不足を補う選択肢になります[1][6]。一方で、量子化やエンジン、評価環境の差が品質に直結します[4][5]。AIバブル関連語が並ぶ中、実務では「速さ」と「安定」を自分の構成で測る必要がありそうです[3]。
引用ソース
- Reddit Reddit r/LocalLLaMA: Strata for all Qwen models from little to big — https://www.reddit.com/r/LocalLLaMA/comments/1xottw2/strata_for_all_qwen_models_from_little_to_big/
Strata for all Qwen models from little to big
- Web記事 記事全文: Model releases – QwenCloud — https://docs.qwencloud.com/changelog/models
New launches and updates
Some legacy models are being retired soon. See Model deprecation policy for the deprecation timeline and replacement models. For model upgrade, version switch, update, and pricing change announce - X Xトレンド: AIバブル崩壊 — https://trends24.in/japan/
AIバブル崩壊
- Reddit Reddit r/LocalLLaMA: Qwen3.8-27B has become unuseable recently — https://www.reddit.com/r/LocalLLaMA/comments/1xoeeyf/qwen3827b_has_become_unuseable_recently/
Qwen3.8-27B has become unuseable recently
- Web記事 記事全文: Qwen3.8-27B Benchmarks: Official and Independent Results — https://www.qubrid.com/blog/qwen38-27b-benchmarks-official-and-independent-results
Qwen3.8-27B scores 52 on the Artificial Analysis Intelligence Index at maximum reasoning effort and 61.7 on SWE-bench Pro per Qwen’s own evaluation. It leads its comparison set on agentic coding and computer-use benchmar
- Web記事 記事全文: Qwen 3.8 & Qwen 3.8 27B Open Source: Official Alibaba Benchmarks & SME … — https://ia4pymes.tech/en/blog/qwen-3-8-official-benchmarks-open-weights-27b-sme-guide
Alibaba Cloud has officially published performance benchmarks and the release roadmap for the Qwen3.8 model family. Following its preview availability across Model Studio, Qoder, and QwenWork, the Chinese tech giant show
- Web記事 記事全文: GitHub – AlibabaCloud-Official/Qwen3.8-27B: Native multimodal dense LLM … — https://github.com/AlibabaCloud-Official/Qwen3.8-27B
Welcome to the repository for Qwen3.8-27B—the latest native multimodal dense open-weight model released by Alibaba’s Qwen team. Delivering top-tier performance for local hardware, Qwen3.8-27B excels at coding, agentic wo
- Web記事 Web検索: Strata LLM – Run 125B+ MoE Models on 12GB VRAM Consumer GPUs (Docs & Setup) — https://stratallm.org/
Strata LLM – Run 125B+ MoE Models on 12GB VRAM Consumer GPUs (Docs & Setup)
※ 本記事はAIにより、Reddit・Hacker News・5ch・Xトレンドの公開投稿・トレンドを軸に、その話題をWeb検索で深掘りして集めた一次情報(記事全文・HNコメント)を併せて自動生成されました。本文中の[n]は末尾の引用ソース番号です。内容の正確性は保証されません。引用先を必ずご確認ください。
RECENT COMMENTS