Metaの個人AIエージェントMuseは、自律アシスタントとして注目されます。Layer3Labsの評価では、タスク実行能力は高い一方、外部小売の遮断と未公開のタスク料金が日常利用を妨げます。本稿は、推論と感知の設計、製品名の混同、実務上の摩擦を追跡します。
Metaの個人AIエージェントMuseは、自律アシスタントとして注目されます。Layer3Labsの評価では、タスク実行能力は高い一方、外部小売の遮断と未公開のタスク料金が日常利用を妨げます。本稿は、推論と感知の設計、製品名の混同、実務上の摩擦を追跡します。
llama.cppのCUDA PRでMoEゲートとup、GLUを融合し、DGX Sparkで17.2%のspeedupが出ました。Fused-MoEはdecode時のGPU同期を64回から1回に減らします。ローカル推論が速くなったことがわかり、ai関連で注目されました。
AIの進化に追いつけないという声が5chで話題です。研究ではAI不安や生成AI格差が示され、OpenAIの実測ではテスト認識率が99.72%から5.12%に下がりました。本記事では不安の正体と必要な対策を整理します。
無料AI活用スレでは、ChatGPTの無料枠拡大と実測調査の差が話題です。66本中61本を評価し、5本は終了や転用と判明しました。無料の範囲、回数制限、商用可否、プロンプト管理の壁が焦点です。今回は新角度です。
JVM単一JAR推論は、2.6MBの依存なしJARという魅力を持ちます。ただ、速度の主張は同じ条件のベンチで確かめる段階です。InferBenchやllama-benchなど、ローカル推論を測る道具が中心になっています。
Googleの資料では、Gemini Agentが企業向け基盤とマネージドAPIとして整理されています。開発、実行、管理、セキュリティが部品化され、1回のやり取りで10万から300万トークンを消費する前提も見えます。
RTX 5090のMSRPは1999ドルですが、2026年9月には5000ドル超の実売が報告されています。Redditでは1万ドルの話も出ています。AIサーバー需要とGDDR7供給の圧力が、ローカル推論の入口を押し上げている状況を追跡します。
ブラウザで動くaiが追跡対象です。LFM3-VL-2BはWebGPUで動画字幕をリアルタイムに動かし、40倍トークン効率やWebGPUベンチの注意点も出ました。小型推論とハード供給の両面から、今週の「その他」AIを整理します。
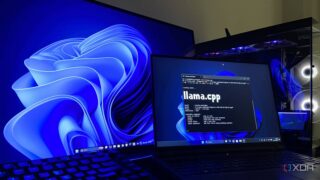
llama.cppを基準に、MoEのRAM分担やJVM単一JAR推論が話題です。RTX 4090では5〜10%のTPS差、8GB GPUで35Bを動かす設定が具体化しました。ローカルAIの最適セットアップが見えます。
Gemini Sparkについて、素材には直接の試行記録が乏しい。検索結果はGoogle AIのAPI、クラウド導入、評価と価格のタイトルを示す。Flash中心の前回から、開発者向け基盤と情報の薄さへ焦点を移す。次は専用ページと第三者検証が必要。
2026.11.03
続・Hermes追跡(15):ベンチマークと自己進化ループ
2026.11.03
続Grok Bot追跡:AIチームメイトとhackerの壁
RECENT COMMENTS