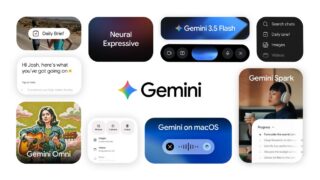
Google I/O 2026でGeminiアプリは月9億人超に成長し、24時間エージェントGemini Sparkが刷新の中心に据えられました。前回の制約解説に続き、アプリ全体の刷新、MacOS統合、月99.99ドルのUltra限定展開という新たな動きを整理します。
Google I/O 2026でGeminiアプリは月9億人超に成長し、24時間エージェントGemini Sparkが刷新の中心に据えられました。前回の制約解説に続き、アプリ全体の刷新、MacOS統合、月99.99ドルのUltra限定展開という新たな動きを整理します。
オープンソースのAIエージェント基盤OpenClawが安定版v2026.5.12に更新され、直近の更新窓は6,844コミットに達しました。一方で学術論文やIBMがセキュリティリスクの分析に乗り出しており、常駐エージェントとチャットをつなぐ仕組みの攻撃面が注目されています。
RAMが12GBのスマホで、284BのAIモデルが動き出しました。生成速度は毎秒0.94トークン。速くはありませんが、CPUだけでの実行です[4]。きっかけは、Hacker Newsに投稿された「BigMoeOnEdge」です。llama.cpp(ローカルAI実行で定番のオープンソースエンジン)の上 […]
リビングのゲーム機が、そのままAIサーバーになる。そんな試みが一段階進みました。PlayStation 5を脱獄(メーカーの制限を解く改造)し、llama.cppを動かす試みが「PS5LM」です。llama.cppは、ローカルで大規模言語モデルを動かす定番ソフトです。Hacker Newsでは375 […]
スマートフォン1台で、350億パラメータ級のモデルが実用速度で動き始めています。Redditのr/LocalLLaMAで話題なのは、OpenBMBが公開したMiniCPM-V 4.7の技術解説です。入力に応じて一部の専門家ネットワークだけを動かすMoE方式の35B-A3Bモデルです。その振り分けを一 […]
30B級のMoEモデルが、16GBのGPUで動くようになっています。さらに、エキスパート(専門家ネットワーク)を事前にメモリへ載せない方向まで進んできました。ローカル推論の定番llama.cppを巡るMoE最適化は、いま「オフロード(GPUに載らない重みをCPU側へ移す方式)」から「ストリーミング」 […]
30BクラスのMoEモデルが、16GBのGPUで動きます。そんな工夫が、ローカルAI推論の定番ツール・llama.cppで現実のものになっています。さらに今は、専門家の重みをディスクから“流し込む”方式まで登場しました[2]。VRAM(GPUのメモリ)節約の設定は以前お伝えしましたが、今回はその先の […]
脱獄したPS5でllama.cppを動かすPS5LMが、GPU推論とOpenAI互換APIまで進みました。27Bモデルで約20トークン毎秒、9Bで55トークン毎秒などの実測がHacker Newsで注目されています。
脱獄したPS5でAIモデルを動かす試み「PS5LM」が再び注目を集めています。小型モデルの推論やAPI対応が進む一方、メモリ制限と導入の壁が課題です。実用性やコストを巡る議論も続いています。
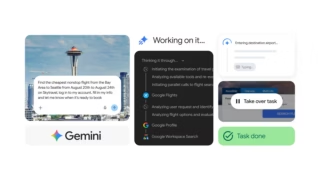
Googleの個人AIエージェント「Gemini Spark」は、端末を閉じても24時間作業を続けられる点が特徴です。専用クラウドマシンと幅広いアプリ連携が支えます。一方で、権限設定とプライバシーへの備えが課題として指摘されています。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS