Flash NextにDFlash2を組み合わせると、llama.cppで平均17%速くなったという報告です。コードやリスト生成で伸びる一方、散文では差が小さい場面もありました。ローカル実行の速度と使いどころがわかります。
Flash NextにDFlash2を組み合わせると、llama.cppで平均17%速くなったという報告です。コードやリスト生成で伸びる一方、散文では差が小さい場面もありました。ローカル実行の速度と使いどころがわかります。
AI推論のFlash Nextで、DFlash2へのアップグレードが話題です。Apple Siliconでの実測では平均17%の速度向上が報告されました。用途や設定で差が出るため、ローカル環境での検証が重要です。
CohereがQwen 3.8 Flash Nextを安全実験に使い、資金調達と重なり物議。公式技術報告やベンチ計画はあるが、素材に実測値は乏しく、検証設計とモデル選択が焦点です。aiの危険性議論で、試しかたが問われます。続報です。
AlibabaがQwen4を4段階で発表し、27Bがローカル向けとされました。公式には仕様や日付がなく、Flashや推論設計の差が焦点です。本記事では発表の実態と準備の勘所を整理します。
DeepSeekのflash系APIが10月中旬に静かに差し替えられ、ある利用者のコーディングエージェントで悪態3倍、モデル切替6.7倍になった報告です。推論品質の再現性、データ所在、AIエージェント運用の課題が、この記事から読み取れます。
Gemini Agent は、ローコードからコードファーストまで入口が増え、Flash 系モデルと評価 GA が運用に繋がりました。1 回のインタラクションで 10 万〜300 万トークンという重さと、サンドボックスの安全設定が現実です。最新資料から運用の勘所を追跡します。
Google AIのGemini Agentで、マネージドエージェントのサンドボックスと推論ループが具体化しました。1回のやり取りで10万〜300万トークンという数値や、企業向け評価のGA化が読み取れます。
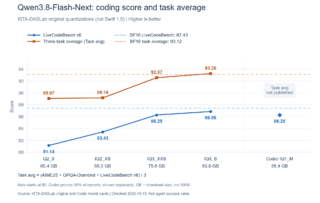
Strataのローカル推論で、RTX 5060 Ti 16GB環境の3種類の量子化の生成速度中央値が65.55、51.30、42.45トークン/秒と報告されました。Qwen 3.8 Flash Nextを使ったLG TVのroot試行やSTRATA-Benchも話題です。
Googleの資料では、Gemini Agentが企業向け基盤とマネージドAPIとして整理されています。開発、実行、管理、セキュリティが部品化され、1回のやり取りで10万から300万トークンを消費する前提も見えます。
アントグループのLingチームがLing-3.1-flash-1019の重みを公開。560B全体・25B活性のMoEで、100万トークンのコンテキストウィンドウが報告されています。総合指数は41から44へ改善した一方、文脈長の表記揺れやREADMEの注意点も見つかりました。
2026.11.11
続・RTX 3090、2026年の中古で24GBとNVLinkが再評価される
2026.11.11
続・Qwen4、4種とFlashが示すローカル実行の行方
2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
RECENT COMMENTS