Redditで、ローカル動作のQwen3.8 Flash Nextによるモーショングラフィックス制作が話題です。Strix Haloと量子化モデルで、クラウド巨大モデルと同じフレームワークの動画を完成させました。ただし複数回の調整が必要で、速度の実測はまだありません。
Redditで、ローカル動作のQwen3.8 Flash Nextによるモーショングラフィックス制作が話題です。Strix Haloと量子化モデルで、クラウド巨大モデルと同じフレームワークの動画を完成させました。ただし複数回の調整が必要で、速度の実測はまだありません。
Qwen4は公式発表前ながら、GitHub新設アカウントによる対応コード、Qwen4-27とQwen4-maxのオープンウェイト同時公開という確認情報、仕様ページの事前出現まで現れています。一方で「確認前はうわさ」との慎重論もあり、公式発表を待つ段階です。
763BのDeepSeek-V4.1-Flash-1017の量子化版で、テンソルごとに精度を変える非一様量子化の詳細が明らかになりました。GSQとRCOの組み合わせで、IQ1_MからIQ2_XSまで3サイズが公開されています。一方でllama.cppは未対応で、品質主張の検証が課題です。
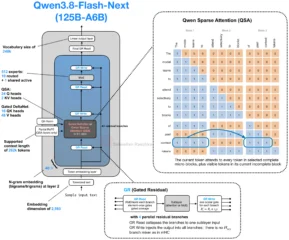
llama.cppに、Qwen4向け新構造QSAの選択処理からkq_maskを外すPRが登場し、Qwen Flash Nextで数GBのVRAM削減を掲げて話題に。QSAは4トークンのブロック単位で最大2,048トークンを選ぶ仕組みです。実装の進展と粗さというトレードオフを整理します。
ISTA-DASLabがDeepSeek-V4.1-Flash-1017の非均一量子化「GSQ-RCO」を公開。重みを1.75〜2.25ビットまで圧縮し、Strata環境では12GB VRAMのGPU1枚での動作をうたいます。一方でllama.cpp非対応やARCベンチ未解決など、実用への課題も見えてきました。
GPUなしのPCでDeepSeek V4 Flash(284B)を動かす実測が話題です。1トークンあたり13Bだけが稼働するMoEで、必要なのはメモリの速度でなく容量。大容量DDR5が24GB GPUより有利な一方、ローカル用重みはAPIのV4.1-Flash(552B)とは別物という落とし穴もあります。
Gemini Agent関連の最新動向です。Flash級モデルが6週間で3回入れ替わり、最新の3.8 Flashはバグ修正セッション100回で約236ドルと、Claude Opus 5の約5分の1のコストでほぼ同等の成功率を報告。一方でGoogleはブラウザ型エージェントMarinerを終了し、市場は業務フロー統合へ向かっています。
3万円のSnapdragonミニPC実験に続報です。投稿者が自作エンジンToRcへ移行し、Flash Nextで46トークン/秒、A3bで315トークン/秒の読み出し速度を報告。一方、NPUはdecodeでCPUに及ばない実測も示され、NPUとCPUの使い分けが鍵となっています。
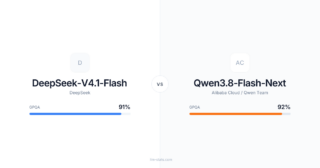
180B・活性化6BのQwen3.8-Flash-Nextが、スコア比較でMetaの816Bモデルを上回る40点を記録し話題に。ローカル実測ではDeepSeek-V4.1-Flashの量子化に対し25問全問正解と好調です。一方で総合指標ではDeepSeekに僅差で及ばず、必要メモリも111GB超と軽量ではありません。
DeepSeek-V4.1-Flashの技術レポートが公開され、省メモリ推論の仕組みが明らかになりました。FP4形式のKVキャッシュでメモリ量をV4 Flash比約1/4に削減し、100万トークンの長文処理を低コストで実現。名前は「.1」でも552Bの新規事前学習モデルという点が注目です。
2026.11.11
続・RTX 3090、2026年の中古で24GBとNVLinkが再評価される
2026.11.11
続・Qwen4、4種とFlashが示すローカル実行の行方
2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
RECENT COMMENTS