KittenMLが重みを3値に圧縮する1.58bit方式の音声合成モデルKitten-TTS 2を公開し、CPUだけでリアルタイム推論が可能になりました。医療特化の124Bモデルも登場するなど軽量・特化路線が加速しています。本記事では各モデルの中身と実用上の留意点を整理します。
KittenMLが重みを3値に圧縮する1.58bit方式の音声合成モデルKitten-TTS 2を公開し、CPUだけでリアルタイム推論が可能になりました。医療特化の124Bモデルも登場するなど軽量・特化路線が加速しています。本記事では各モデルの中身と実用上の留意点を整理します。
ローカル推論エンジンcapy-flash v0.7.1が公開され、125B MoEのQwen3.8-Flash-Nextが64GB RAMで動くようになりました。16GB GPU2枚で234tok/s、1枚でも121tok/s。27Bは16GB GPU1枚で動き、品質のトレードオフも報告されています。
前回紹介したスマホ向けMoEストリーミング層のその後を追う。284Bモデルを12GBスマホのCPUだけで0.94トークン/秒で動かす仕組みや、llama.cppをフォークしない設計、品質をflash節約と交換するオプションを整理し、GPU・モバイル側の研究動向も伝える。
アントグループのMoEモデルLing-3.1-flashに1019更新が予定され、総合指数が41→44、エージェント評価も62%→68%へ向上したと発表されました。APIと重み公開は「近日」で、数値は独立検証前の公表値です。試してから公開する配布スタイルも含めて整理します。
Qwen3.8のローカル実行で、125B MoEのFlash-Nextと27B denseモデルの比較が進んでいます。IQ2まで圧縮したFlash-NextがQ8の27Bをコーディングで上回った報告や、RTX 4070 1枚での実測が共有され、用途別の使い分けが見えてきました。
「Flash」を名乗るDeepSeek-V4.1-Flashが、最上位のV4-Pro廃止とセットで登場しました。入出力で活性パラメータを変える新設計とKVキャッシュ圧縮が鍵で、APIは入力100万トークン0.22ドル。一方、ローカル実行は7.2 tok/sにとどまります。
Gemini Agentは、コード改修の高速化の先へ進んでいます。公式ドキュメントから、1回のやり取りで10万〜300万トークンを消費する課金モデルと、既定でネットワーク無制限のサンドボックスという安全設計が見えてきました。権限・認証情報・コストの設計を整理します。
748Bパラメータの巨大モデルが、2千ユーロの中古PCで動き出しました。前回の記事では、ハッカー系タスクのベンチマークでDeepSeek FlashがSolを上回った話をお伝えしました。その後、「自宅の機材でどこまで動くのか」というローカル推論の挑戦が話題になっています。ポイントは、動いたという事実 […]
VRAM12GBのグラフィックボード1枚で、1250億パラメータのモデルが動く——。ローカル推論エンジン「Strata」をめぐり、そんな報告が相次いでいます。開発者Niko1221氏によるオープンソースのこのプロジェクトは、Qwen3.8-Flash-Next 125Bという大型のMoEモデルを、1 […]
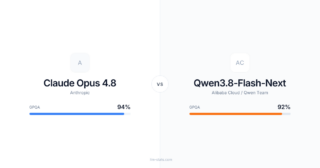
ローカルで動くモデルは、最上位のAPIモデルにどこまで迫れるのか。Redditのr/LocalLLaMAに投稿された検証が、その一つの答えです[1]。同じコーディングタスクを両者に解かせています。費用は0.32ドル対17.78ドル。約55倍の差です。それでいて完成度は69%対87%。この数字を順に読 […]
2026.11.11
続・RTX 3090、2026年の中古で24GBとNVLinkが再評価される
2026.11.11
続・Qwen4、4種とFlashが示すローカル実行の行方
2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
RECENT COMMENTS