無料AI活用専用スレに2026年10月時点の無料版比較が登場し、差が数値で明確になりました。ChatGPT無料版はテキスト会話が無制限、Geminiは3.2万トークン、Claudeは最大100万トークンです。プロンプト管理ツールや無料IDE、注意点も整理します。
無料AI活用専用スレに2026年10月時点の無料版比較が登場し、差が数値で明確になりました。ChatGPT無料版はテキスト会話が無制限、Geminiは3.2万トークン、Claudeは最大100万トークンです。プロンプト管理ツールや無料IDE、注意点も整理します。
RTX 3090でのローカルAI運用がさらに具体化しました。1.7B〜35Bの59モデルの実測をまとめたガイドでは、32BモデルをGPUだけで動かし、速度は毎秒17〜90トークンに達しています。リバースエンジニアリング用途でのローカル需要も広がりました。
Qwen4の先行プレビューQwen3.8-Flash-Nextで、ローカル実行の具体的な報告が相次いでいます。総125B・活性約6BのMoE構成を生かし、8GB GPU+24GB RAMで毎秒70トークンなど実測が共有されました。一方で推論系のベンチマークでは苦戦する項目も見えています。
1つのJARファイルだけで依存なしに動くJava製ローカル推論エンジンがHacker Newsに投稿され、「llama.cppより速い」と主張しています。JVM上で完結する構成が特徴です。ただし実測値は示されておらず、コメントもない検証前の段階です。
ブラウザのタブ内で小型ニューラルネット4つが曲を解析するリズムゲームが公開され、ローカルAIの動きがGPUマシンからブラウザへ広がっています。BeatNet約1.6MBなど超軽量モデルの組み合わせで、音声は端末から出ません。KLD指標の誤用指摘など周辺動向もわかります。
AIエージェントの実行を隔離する動きが、個人開発から公式標準へ広がっています。Kubernetesにagent-sandboxが登場し、gVisorを使う個人開発者は認証情報の分離などを工夫。企業向けには1万5000以上のAIツールを管理するセキュリティ製品も現れました。
Gemini Agentをめぐり、公式ドキュメントがエージェントモードの動作と権限設計を詳しく公開しました。ファイル変更など危険な操作は実行のたびに許可を求め、複雑なタスクではプラン承認を挟みます。キーノートもサンドボックスや支出上限などの統制を強調しており、自律性とブレーキの両立が鮮明になりました。
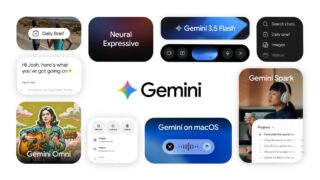
Googleの24時間エージェント「Gemini Spark」は、発表後、macOSアプリへの搭載と音声強化が進められています。朝の情報をまとめるDaily Briefなど周辺機能との連携も見え始めました。一方、提供は米国の一部ユーザーに限られ、権限設計への注目が続きます。
llama.cppのMoEオフロードに、スマホやノートを狙うラッパーや動的オフロードのフレームワークが登場し、実装が増えています。Qwen3-Coder 30Bはトークンごとに3Bだけ動くものの、重みの置き場所が壁で、RAMへの逃がしは速度との引き換えです。
llama.cppフォークの推論時abliterationエンジンがStrataに移植され、再学習なしで拒否を除いたモデルを動かす動きが出ました。Qwen3.8-Flash-Nextのabliterated版は2bit量子化でRTX 3090を1〜2枚の構成です。ただし品質検証はこれからの段階です。
2026.11.04
続・NVIDIA:Blackwellが推論と接続を変える
2026.11.04
続・Gufoの最新はStrix Haloで品質と速度を両立
2026.11.03
続・Hermes追跡(15):ベンチマークと自己進化ループ
RECENT COMMENTS