llama.cppのMoE改善が動いています。焦点は、複数の専門家を選ぶ設計と動的なオフロードです。LLaMA-MoEは活性パラメータ3.0〜3.5Bを掲げ、llama.moeはllama.cpp上での専門家オフロードを狙いますが、実測TPSや電力のデータはまだありません。
llama.cppのMoE改善が動いています。焦点は、複数の専門家を選ぶ設計と動的なオフロードです。LLaMA-MoEは活性パラメータ3.0〜3.5Bを掲げ、llama.moeはllama.cpp上での専門家オフロードを狙いますが、実測TPSや電力のデータはまだありません。
ジェイルブレイクしたPS5でllama.cppを動かす「PS5LM」の続報が話題です。OpenAI風APIやテレビ画面向けのUIを備え、27Bモデルが9〜21 tok/sで動きました。改造前提ながら、家庭の端末にAIを置く可能性を示しています。
Dotsの追跡記事です。dots.llm1は142BのMoEで、学習途中のチェックポイント公開が特徴です。dots.ttsは高精度の音声合成を報告する一方、ローカル推論の実測速度はまだ示されていません。
Metaが個人向けAIエージェント「Meta Muse」を発表しました。推論ループや記憶、接続の切り分けが設計の鍵です。一方で外部小売の制限と料金非公開が、日常利用の壁になっています。
llama.cppでMoEを動かす話題が、専門家の選び方とキャッシュ設計へ移っています。構築側はLLaMA-MoE、実行側はオフロードとキャッシュ最適化が中心です。実測速度の数値はまだ示されていません。
llama.cppのMoE対応が、モデル構築から推論のオフロード設計へ進んだことを追跡します。LLaMA-MoEは活性パラメータ3.0〜3.5B、zilongはllama-server互換で動的オフロードを狙います。実測TPSはまだなく、設定設計が中心の話題です。
ジェイルブレイクしたPS5でAIモデルを動かすPS5LMが、ペイロードからGPUネイティブアプリへ進化。Qwen3.8 27Bが9〜21トークン毎秒で動き、OpenAI互換APIも使えます。ただしファームウェア条件やセットアップの重さが課題です。
ローカルで会議を記録するツールMeetCapの続報です。同じ名前でも、Linux版はAI要約の検証、Windows版は話者ラベルの信頼性に重きを置きます。録音の次に問われるのは「誰が何を言ったか」の扱いです。
Claude Codeのサブエージェントを束ねる動きが、piというツールへ広がっています。CodexやOpenCodeも従えるPi-cowboyや、最大10件の並列実行に対応するpi-subagentsが登場しました。一方で比較の実測値は乏しく、設計は途中です。
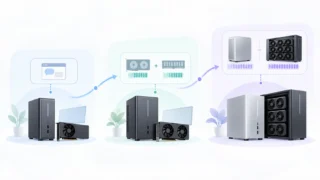
ローカルLLMはモデルごとに必要メモリが24〜32GB、128GB、256GB級に分かれます。160GBミニPCの試作機仕様が公開された一方、実測速度データの不足が課題です。追跡では構成と実売価格の差が焦点になります。
2026.11.01
続・Gemini Tasks、改名後の課金と安全の落とし穴
2026.11.01
Altman氏、AIの推論速度と安全を語る
2026.11.01
Ternary Bonsai 2、ローカル推論の壁を越えた
RECENT COMMENTS