llama.cppに、QwenモデルのGGUF変換時にテンソルを統合するPRが登場し、Redditで話題になっています。マージされれば既存GGUFの作り直しが必要になる一方、速度やメモリへの効果はまだ未確定です。変換の仕組みと、ローカル推論への影響を解説します。
llama.cppに、QwenモデルのGGUF変換時にテンソルを統合するPRが登場し、Redditで話題になっています。マージされれば既存GGUFの作り直しが必要になる一方、速度やメモリへの効果はまだ未確定です。変換の仕組みと、ローカル推論への影響を解説します。
llama.cppに、QwenモデルのGGUF変換時にテンソルを統合するPRが投稿され、r/LocalLLaMAで話題になっています。変換スクリプトqwen.pyは1046行の大型ファイルで、既存GGUFの作り直しを促す可能性があります。速度などの比較数値は素材からは確認できませんでした。
llama.cppに、QwenモデルのGGUF変換時にテンソルを統合するPRが投稿され、Redditで話題になっています。既存GGUFの作り直しが注目点です。記事ではPRの内容と、Qwenの規模、ローカル実行をめぐる動き、再変換の落とし穴を整理します。
Qwen3.8-27Bを古いTesla P100 2枚で約60tpsで動かす報告に、動作環境の詳細が判明しました。一方Redditでは、同シリーズをベースにBlender用3Dモデル生成を強化したfinetuneを求める声が登場。テキスト推論は進化を続ける一方、3D生成に応えるモデルはまだ見つかっていない実情がわかります。
Qwen4は公式発表前ながら、GitHub新設アカウントによる対応コード、Qwen4-27とQwen4-maxのオープンウェイト同時公開という確認情報、仕様ページの事前出現まで現れています。一方で「確認前はうわさ」との慎重論もあり、公式発表を待つ段階です。
GitHubで作成1か月未満の新アカウントが「Qwen4.0-Max」対応のコード修正を提案し、Redditで話題に。提案先はAlibaba系T-headのリポジトリで、モデル実在をうかがわせる痕跡として注目されています。ただし公式発表はなく、真偽の見極めが必要です。
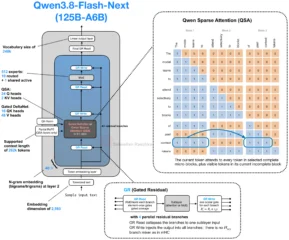
llama.cppに、Qwen4向け新構造QSAの選択処理からkq_maskを外すPRが登場し、Qwen Flash Nextで数GBのVRAM削減を掲げて話題に。QSAは4トークンのブロック単位で最大2,048トークンを選ぶ仕組みです。実装の進展と粗さというトレードオフを整理します。
Qwen3最小モデル0.6BをMoE構造に変換する試みがローカルコミュニティで話題です。Qwen3は共有エキスパートを持たず品質維持が難しく、疑似共有エキスパートで対処しました。公式レポートはthinkingモード統合や多言語対応29から119への拡大を示しています。
Qwen4の登場を前に、ローカルLLM勢で中古GPU探しが活発化。Qwen-3.8-MaxはKimi K3(活性化104B)やDeepSeek V4と100万トークン・MoEで競います。GPU調達の実情、比較の最新状況、コーダー系モデルの入手事情を整理します。
RTX 5060 Ti 2枚の環境で新しいローカルLLMを18個試したところ、どれもQwen3.8-27Bを置き換えられなかったというテストが話題です。2枚構成は32GBのVRAMでMoEモデルに強く、従来型モデルでは帯域の広いRTX 3090が速いなど、構成ごとの得意分野が見えてきました。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS