生成AIの進化についていけないという感覚が、海外では「AI不安」として研究対象になっています。現場では中高生の卒業アルバム写真を使ったディープフェイクが広がり、OpenAIは13〜17歳向けに感情依存を防ぐ安全機能を発表しました。不安への対処が研究・技術・教育の各面で動き始めた状況がわかります。
生成AIの進化についていけないという感覚が、海外では「AI不安」として研究対象になっています。現場では中高生の卒業アルバム写真を使ったディープフェイクが広がり、OpenAIは13〜17歳向けに感情依存を防ぐ安全機能を発表しました。不安への対処が研究・技術・教育の各面で動き始めた状況がわかります。
無料AI活用専用スレのその後を追う。無料版の比較はトークン数から各サービスの得意分野へ広がり、スレでは質問の型やプロンプト管理ツールの実践が共有されている。一方で単一サービス頼みは本格利用で崩れるとの指摘もあり、目的別の使い分けが鍵となる。
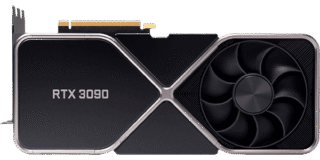
2020年発売のRTX 3090を、スペックと価格の面から2025年GPUと比較しました。FP32は35.58 TFLOPS、VRAMは24GB。同性能帯とされるRTX 5070は549ドルと約3分の1の価格ですが、VRAMは12GBで、24GBは1599ドルのRTX 4090だけです。
ローカルAIをめぐり、量子化モデルのバックアップ呼びかけ、モデルファイルのセキュリティリスク、GPU価格の高騰が同時期に表面化。CVSS 9.3の脆弱性やjailbreak成功率への影響も報告され、手元で動かすAIの「守り」が本格的な課題になっています。
AIエージェントのコード実行を隔離するサンドボックス化が一般的になる中、関心は運用側へ広がっています。gVisorで隔離し、カンバンでタスクを回す個人開発が登場しました。失敗時の再試行や資格情報の隔離など、実運用の知見が共有されています。
llama.cppのMoEオフロードが進化し、8GBのGPUで35Bモデルを動かした実検証や専用ツール、解説が相次いで登場しました。35Bのうち推論で動くのは約3Bという構造が鍵です。一方、MoEが本当にエッジ推論に役立つのかを問う論文も現れました。
Googleが発表した単一の業務用エージェント「Gemini agent」の動きを追いました。Chromium約4000万行の中で約600万行のレガシーコード分離を数カ月から数週間へ圧縮した実例や、顧客の約80%がAI製品を利用する規模を整理し、評価と調整が前提の運用面にも触れます。
GoogleがFamily Link管理下の13歳未満にGeminiアプリを数週間以内に開放すると保護者に通知しました。初期状態で有効で、子ども自身が切り替えられ、初回起動時には保護者へメールが届きます。物語作成や宿題支援などの機能が示される一方、フィルター付きでもリスクは残るとの報告もあり、安全策の実効性が問われています。
JARファイル1つで動くJVM製推論エンジンの投稿は、スコア1ポイント・コメント0件で検証を待つ。一方、純Java実装「llama3.java」はVector APIやGraalVM対応など技術の輪郭を見せ、JavaアプリからLLMを扱う「llm4j」も整備が進む。2026年の主要エンジン比較にJVM製の名前はまだ並んでいない。
llama.cppにFFNのgate/up行列積とGLUを1つのCUDAカーネルにまとめる最適化PRが投稿され、DGX Sparkで最大10.7%、RTX 5090で最大4.6%のprefill高速化が報告されました。一方、V100での別の融合試行は全体が逆に遅くなり取りやめに。カーネル融合の効果と落とし穴を数値で読み解ける記事です。
2026.11.01
続・Gemini Tasks、改名後の課金と安全の落とし穴
2026.11.01
Altman氏、AIの推論速度と安全を語る
2026.11.01
Ternary Bonsai 2、ローカル推論の壁を越えた
RECENT COMMENTS