ローカル推論エンジンStrata関連で、エキスパートをRAMに常駐させずNVMe SSDから直接読む新方式が話題に。RTX 4090とRAM 8GBで125Bモデルが約20 tok/sで動き、262kトークンでも速度はほぼ落ちませんでした。一方、Strata本体の0.2.6は大RAM環境向けに高速化し、環境別の道筋が見えてきました。
ローカル推論エンジンStrata関連で、エキスパートをRAMに常駐させずNVMe SSDから直接読む新方式が話題に。RTX 4090とRAM 8GBで125Bモデルが約20 tok/sで動き、262kトークンでも速度はほぼ落ちませんでした。一方、Strata本体の0.2.6は大RAM環境向けに高速化し、環境別の道筋が見えてきました。
GrokBotの自律動作を支えるAgent Tools APIは、検索やコード実行をモデル自身が判断して呼び出す仕組みです。最新ドキュメントではGrok 4.7がフラッグシップとされ、音声認識はリアルタイム処理がバッチの2倍の料金になるなど、従量課金の実像も明確になりました。
Dots系の文書解析モデルdots.ocrがdots.mocrへ刷新。3BパラメータのVLM1つでレイアウト検出・文字認識・図表解析を統合し、Gemini 3 Flashを審査員に立てたElo評価で同サイズ最高水準とされます。vllmなどでのローカル推論も可能で、仕組みと評価方法、留意点を整理しました。
JVM上でLLMを動かす推論エンジンに、ONNX Runtimeを活用する新顔JInferが登場しました。依存ゼロ・2.6MB JARのQuixotic AIはHacker Newsでスコア2まで動いています。ローカルLLM環境が50超に広がる中、Java陣営の手法が二分化しました。
ISTA-DASLabの2bit量子化版DeepSeek-V4.1-Flashは、テンソルごとに精度を変える非一様量子化で763Bモデルを12GB GPU1枚で動かします。MLXへの移植も登場した一方、ベンチマーク飽和で劣化が見えず、KLDなどでの検証が課題です。
Qwen3を自分の用途に仕上げる動きが音声とテキストで進んでいます。TTSの0.6Bを微調整した600Mモデルは実時間の4倍の速さで、学習費は200ドル未満。32Bの医療推論向け学習はA100 1枚で50分、競合はQwen3.8-27B超えを主張しました。
依存ライブラリ不要の2.6MB JARだけでAI推論を動かすJVM向けスタックが、Hacker Newsで話題になっています。作者はCPU上でllama.cppに匹敵すると述べ、ModelJarsやJInferなど周辺整備も進みます。一方で第三者実測は乏しく、検証の進み方が注目点です。
llama.cppに、QwenモデルのGGUF変換時にテンソルを統合するPRが登場し、Redditで話題になっています。マージされれば既存GGUFの作り直しが必要になる一方、速度やメモリへの効果はまだ未確定です。変換の仕組みと、ローカル推論への影響を解説します。
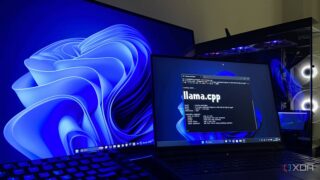
RAMより大きいMoEモデルをスマホやノートで動かすllama.cpp拡張が登場しました。既存のオフロード手法は、35Bのうち約3Bだけを稼働させる構造を活かし、8GBのGPUでも17.7GBのモデルを動かせています。新ツールの位置づけと実検証の数値を整理します。
Hacker Newsで、依存ライブラリなしの2.6MB JAR1つでローカル推論が行えるJVM向けAIスタック「Quixotic AI」が紹介されました。作者はCPU実行でllama.cppに競争力があると説明します。本記事では純Java推論の流れ、エンジン間の速度競争、速度主張の裏付けの現状までを整理します。
2026.11.01
続・Gemini Tasks、改名後の課金と安全の落とし穴
2026.11.01
Altman氏、AIの推論速度と安全を語る
2026.11.01
Ternary Bonsai 2、ローカル推論の壁を越えた
RECENT COMMENTS